
16 Natūraliosios kalbos apdorojimas: taikymai
15 skyrelis matėme, kaip vaizduoti teksto sekų teksto vienetus ir apmokyti jų vaizdavimus. Tokius iš anksto apmokytus teksto vaizdavimus galima paduoti į įvairius modelius skirtingoms tolesnėms natūraliosios kalbos apdorojimo užduotims.
Iš tikrųjų ankstesniuose skyriuose jau aptarėme kai kuriuos natūraliosios kalbos apdorojimo taikymus be išankstinio apmokymo, tik giliojo mokymosi architektūroms paaiškinti. Pavyzdžiui, 9 skyrelis rėmėmės RNN, kad suprojektuotume kalbos modelius, generuojančius apysakos tipo tekstą. 10 skyrelis ir 11 skyrelis taip pat suprojektavome modelius, pagrįstus RNN ir dėmesio sutelkimo mechanizmais, mašininiam vertimui.
Tačiau ši knyga neketina išsamiai aprėpti visų tokių taikymų. Vietoj to mūsų dėmesys sutelktas į tai, kaip taikyti (gilųjį) kalbų vaizdavimo mokymąsi natūraliosios kalbos apdorojimo problemoms spręsti. Turint iš anksto apmokytus teksto vaizdavimus, šiame skyriuje išnagrinėsime dvi populiarias ir reprezentatyvias tolesnes natūraliosios kalbos apdorojimo užduotis: nuotaikų analizę ir natūraliosios kalbos išvadų darymą, kurios atitinkamai analizuoja atskirą tekstą ir tekstų porų sąryšius.
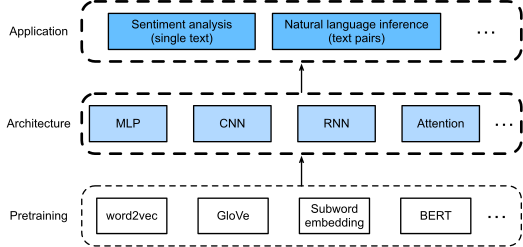
16.1 pav. Iš anksto apmokytus teksto vaizdavimus galima paduoti į įvairias giliojo mokymosi architektūras skirtingiems tolesniems natūraliosios kalbos apdorojimo taikymams. Šiame skyriuje susitelkiama į tai, kaip projektuoti modelius skirtingiems tolesniems natūraliosios kalbos apdorojimo taikymams.
Kaip pavaizduota 16.1 pav., šiame skyriuje susitelkiama į pagrindinių natūraliosios kalbos apdorojimo modelių projektavimo idėjų aprašymą naudojant skirtingų tipų giliojo mokymosi architektūras, tokias kaip MLP, CNN, RNN ir dėmesio sutelkimas. Nors 16.1 pav. galima derinti bet kuriuos iš anksto apmokytus teksto vaizdavimus su bet kuria architektūra abiem taikymams, pasirenkame kelis reprezentatyvius derinius. Konkrečiai, nuotaikų analizei išnagrinėsime populiarias architektūras, pagrįstas RNN ir CNN. Natūraliosios kalbos išvadų darymui pasirenkame dėmesio sutelkimą ir MLP, kad parodytume, kaip analizuoti tekstų poras. Galiausiai pristatome, kaip patikslinti iš anksto apmokytą BERT modelį plačiam natūraliosios kalbos apdorojimo taikymų spektrui, pavyzdžiui, sekos lygmeniu (vieno teksto klasifikavimas ir tekstų porų klasifikavimas) ir teksto vieneto lygmeniu (teksto žymėjimas ir atsakymas į klausimus). Kaip konkretų empirinį atvejį patikslinsime BERT natūraliosios kalbos išvadų darymui.
Kaip pristatėme 15.8 skyrelis, BERT reikalauja minimalių architektūros pakeitimų plačiam natūraliosios kalbos apdorojimo taikymų spektrui. Tačiau šis privalumas ateina patikslinimo kaina: tolesniems taikymams reikia patikslinti milžinišką kiekį BERT parametrų. Kai vietos ar laiko yra ribotai, tie sukurti modeliai, pagrįsti MLP, CNN, RNN ir dėmesio sutelkimu, yra labiau įgyvendinami. Toliau pradedame nuo nuotaikų analizės taikymo ir iliustruojame modelio dizainą, pagrįstą atitinkamai RNN ir CNN.
- 16.1 Nuotaikų analizė ir duomenų rinkinys
- 16.2 Nuotaikų analizė: naudojant rekurentinius neuroninius tinklus
- 16.3 Nuotaikų analizė: naudojant konvoliucinius neuroninius tinklus
- 16.4 Natūraliosios kalbos išvadų darymas ir duomenų rinkinys
- 16.5 Natūraliosios kalbos išvadų darymas: naudojant dėmesio sutelkimą
- 16.6 BERT patikslinimas sekos lygmens ir teksto vieneto lygmens taikymams
- 16.7 Natūraliosios kalbos išvadų darymas: BERT patikslinimas