
18.1 Įvadas į Gauso procesus
Daugeliu atvejų mašininis mokymasis reiškia parametrų vertinimą iš duomenų. Šie parametrai dažnai yra gausūs ir santykinai sunkiai interpretuojami – pavyzdžiui, neuroninio tinklo svoriai. Priešingai, Gauso procesai suteikia mechanizmą tiesiogiai samprotauti apie aukšto lygio funkcijų, kurios galėtų atitikti mūsų duomenis, savybes. Pavyzdžiui, galime nujausti, ar šios funkcijos kinta sparčiai, ar yra periodinės, ar turi sąlyginių nepriklausomumų, ar yra invariantiškos postūmiui. Gauso procesai leidžia lengvai įtraukti šias savybes į savo modelį tiesiogiai nurodant Gauso skirstinį funkcijos reikšmėms, kurios galėtų atitikti mūsų duomenis.
Pajauskime, kaip veikia Gauso procesai, pradėdami nuo kelių pavyzdžių.
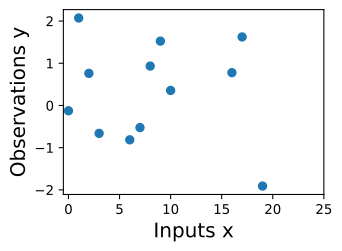
Tarkime, stebime šį duomenų rinkinį – regresijos tikslus (išvestis) , indeksuotus įvestimis . Pavyzdžiui, tikslai galėtų būti anglies dioksido koncentracijų pokyčiai, o įvestys – laikai, kuriais šie tikslai buvo užregistruoti. Kokios yra duomenų ypatybės? Kaip sparčiai jie, atrodo, kinta? Ar turime duomenų taškų, surinktų reguliariais intervalais, ar yra trūkstamų įvesčių? Kaip įsivaizduotumėte trūkstamų sričių užpildymą arba prognozavimą iki ?
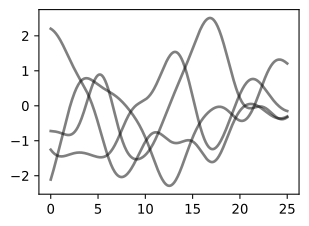
Norėdami pritaikyti Gauso procesą duomenims, pradedame nurodydami apriorinį skirstinį, kokių tipų funkcijas galime laikyti pagrįstomis. Čia parodome kelias Gauso proceso imčių funkcijas. Ar šis apriorinis skirstinys atrodo pagrįstas? Atkreipkite dėmesį, kad čia ieškome ne funkcijų, atitinkančių mūsų duomenų rinkinį, o nurodome pagrįstas aukšto lygio sprendinių savybes, pavyzdžiui, kaip sparčiai jie kinta priklausomai nuo įvesčių. Atkreipkite dėmesį, kad visų šioje užrašų knygutėje esančių grafikų atkūrimo kodą pamatysime kitose užrašų knygutėse apie apriorinius skirstinius ir inferenciją.
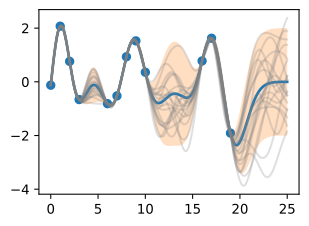
Kai sąlygojame duomenimis, galime naudoti šį apriorinį skirstinį, kad atliktume inferenciją apie aposteriorinį funkcijų, kurios galėtų atitikti duomenis, skirstinį. Čia parodome aposteriorinių funkcijų imtis.
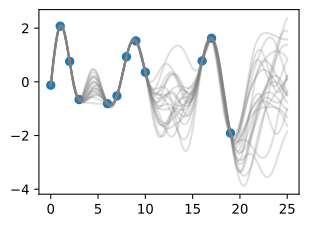
Matome, kad kiekviena iš šių funkcijų yra visiškai suderinama su mūsų duomenimis ir tiksliai eina per kiekvieną stebinį. Norėdami naudoti šias aposteriorines imtis prognozėms daryti, galime suvidurkinti kiekvienos galimos aposteriorinės imties funkcijos reikšmes ir sukurti žemiau pateiktą kreivę storai mėlyna spalva. Atkreipkite dėmesį, kad iš tikrųjų nereikia imti begalinio imčių skaičiaus šiam vidurkiui apskaičiuoti; kaip pamatysime vėliau, vidurkį galime apskaičiuoti uždaros formos išraiška.
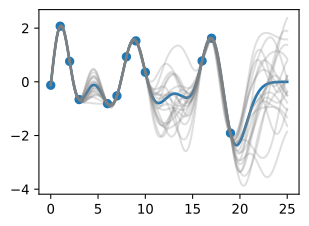
Taip pat galime norėti neapibrėžtumo atvaizdavimo, kad žinotume, kiek pasitikėti savo prognozėmis. Intuityviai neapibrėžtumas turėtų būti didesnis ten, kur aposteriorinių imčių funkcijos labiau kinta, nes tai mums sako, kad tikroji funkcija galėtų įgyti daug daugiau galimų reikšmių. Šis neapibrėžtumo tipas vadinamas epistemiliniu neapibrėžtumu, kuris yra su informacijos trūkumu susijęs sumažinamas neapibrėžtumas. Gaunant daugiau duomenų, šio tipo neapibrėžtumas išnyksta, nes vis mažiau sprendinių bus suderinami su tuo, ką stebime. Kaip ir aposteriorinį vidurkį, aposteriorinę dispersiją (šių funkcijų kintamumą aposteriorinio skirstinio atveju) galime apskaičiuoti uždaros formos išraiška. Šešėliu rodome dvigubą aposteriorinį standartinį nuokrypį į abi vidurkio puses, sukurdami patikimąjį intervalą, kuris su 95 % tikimybe turi tikrąją funkcijos reikšmę bet kuriai įvesčiai .
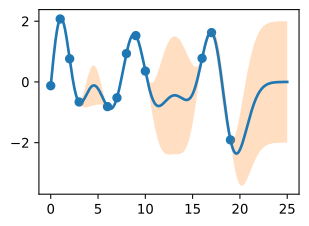
Grafikas atrodo kiek tvarkingiau, jei pašaliname aposteriorines imtis ir tiesiog vizualizuojame duomenis, aposteriorinį vidurkį ir 95 % patikimąją aibę. Atkreipkite dėmesį, kaip neapibrėžtumas didėja tolstant nuo duomenų – tai epistemilinio neapibrėžtumo savybė.
Gauso proceso, kurį naudojome duomenims pritaikyti, savybes stipriai valdo vadinamoji kovariacijos funkcija, dar žinoma kaip branduolys. Mūsų naudota kovariacijos funkcija vadinama RBF (radialiosios bazinės funkcijos) branduoliu, kurio forma yra
Šio branduolio hiperparametrai yra interpretuojami. Amplitudės parametras valdo vertikalųjį mastelį, kuriuo funkcija kinta, o ilgio skalės parametras valdo funkcijos kitimo spartą (banguotumą). Didesnis reiškia didesnes funkcijos reikšmes, o didesnis reiškia lėčiau kintančias funkcijas. Pažiūrėkime, kas nutinka mūsų apriorinėms ir aposteriorinėms imties funkcijoms keičiant ir .
Ilgio skalė turi ypač ryškų poveikį GP prognozėms ir neapibrėžtumui. Kai , kovariacija tarp funkcijos reikšmių poros yra . Esant didesniems atstumams nei , funkcijos reikšmės tampa beveik nekoreliuotos. Tai reiškia, kad jei norime padaryti prognozę taške , tai funkcijos reikšmės su įvestimis , tokiomis kad , stipriai nepaveiks mūsų prognozių.
Pažiūrėkime, kaip ilgio skalės keitimas veikia apriorines ir aposteriorines imties funkcijas bei patikimąsias aibes. Aukščiau pateikti pritaikymai naudoja ilgio skalę. Dabar panagrinėkime . ilgio skalė yra labai maža, palyginti su nagrinėjamos įvesties srities intervalu . Pavyzdžiui, funkcijos reikšmės taškuose ir tokioje ilgio skalėje iš esmės neturės jokios koreliacijos. Kita vertus, esant ilgio skalei, funkcijos reikšmės šiose įvestyse bus labai koreliuotos. Atkreipkite dėmesį, kad vertikalusis mastelis šiuose paveiksluose keičiasi.
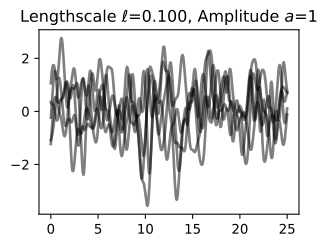
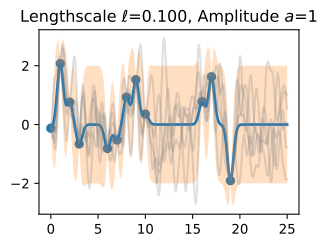
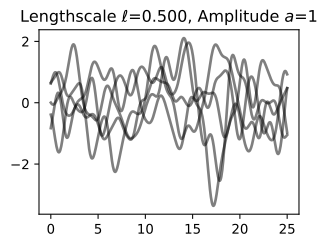
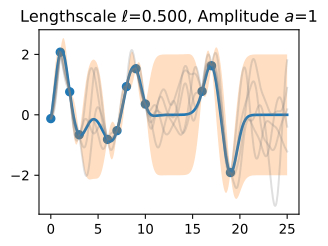
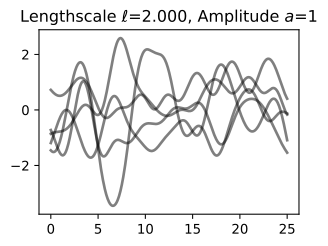
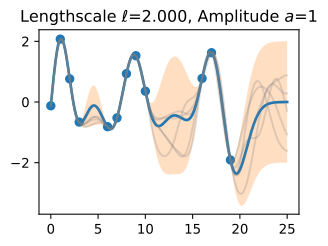
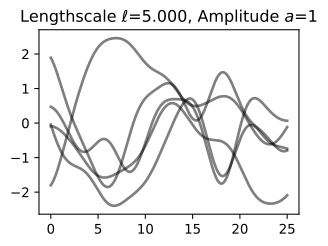
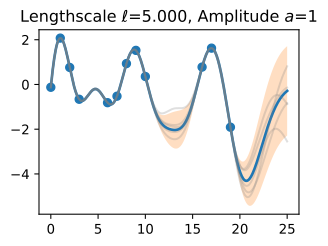
Pastebėkite, kad didėjant ilgio skalei funkcijų „banguotumas“ mažėja, ir mūsų neapibrėžtumas mažėja. Jei ilgio skalė maža, neapibrėžtumas greitai didės tolstant nuo duomenų, nes duomenų taškai tampa mažiau informatyvūs apie funkcijos reikšmes.
Dabar keiskime amplitudės parametrą, laikydami ilgio skalę fiksuotą ties . Atkreipkite dėmesį, kad vertikalusis mastelis apriorinėms imtims laikomas fiksuotu, o aposteriorinėms imtims keičiasi, taigi aiškiai matote ir didėjantį funkcijos mastelį, ir pritaikymus duomenims.
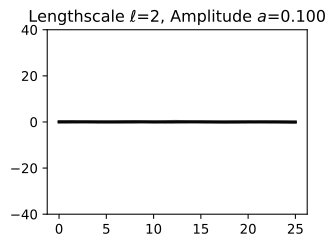
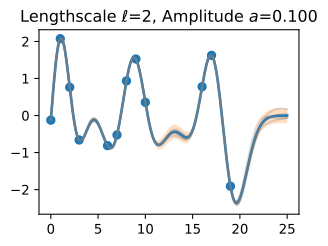
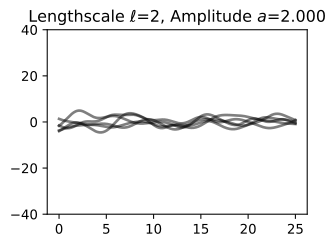
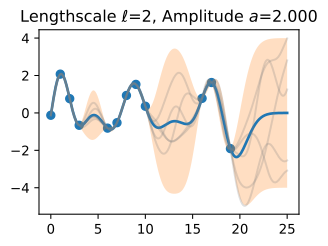
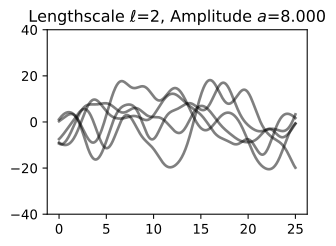
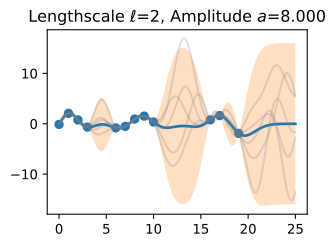
Matome, kad amplitudės parametras veikia funkcijos mastelį, bet ne kitimo spartą. Šiuo metu taip pat nujaučiame, kad mūsų procedūros apibendrinimo našumas priklausys nuo pagrįstų šių hiperparametrų reikšmių. Reikšmės ir atrodė suteikiančios pagrįstus pritaikymus, o kai kurios kitos reikšmės – ne. Laimei, yra patikimas ir automatinis būdas nurodyti šiuos hiperparametrus naudojant vadinamąjį ribinį tikėtinumą, prie kurio grįšime inferencijos užrašų knygutėje.
Taigi kas iš tikrųjų yra GP? Kaip pradėjome, GP tiesiog teigia, kad bet kuri funkcijos reikšmių aibė , indeksuota bet kuria įvesčių aibe , turi jungtinį daugiamatį Gauso skirstinį. Šio skirstinio vidurkio vektorių nurodo vidurkio funkcija, kuri paprastai laikoma pastovia arba nuline. Šio skirstinio kovariacijų matricą nurodo branduolys, įvertintas visose įvesčių porose.
Lygtis (18.1.1) nurodo GP apriorinį skirstinį. Galime apskaičiuoti sąlyginį skirstinį bet kuriam , žinant – funkcijos reikšmes, kurias stebėjome. Šis sąlyginis skirstinys vadinamas aposterioriniu, ir būtent jį naudojame prognozėms daryti.
Konkrečiai,
kur
kur yra vektorius, sudarytas įvertinus su , o yra matrica, sudaryta įvertinus su . galime naudoti kaip taškinį prognozuotuvą bet kuriam , o naudojame neapibrėžtumui: jei norime sukurti intervalą su 95 % tikimybe, kad yra tame intervale, naudotume . Visų aukščiau pateiktų paveikslų prognozuojami vidurkiai ir neapibrėžtumai buvo sukurti naudojant šias lygtis. Stebėti duomenų taškai buvo , o prognozėms daryti pasirinkome smulkią taškų aibę.
Tarkime, kad stebime vieną duomenų tašką ir norime nustatyti reikšmę kuriame nors . Kadangi aprašomas Gauso procesu, žinome, kad jungtinis skirstinys yra Gauso:
Nediagonalinė išraiška mums sako, kiek koreliuotos bus funkcijos reikšmės – kaip stipriai bus nulemta pagal . Jau matėme, kad jei naudojame didelę ilgio skalę, palyginti su atstumu tarp ir , , tada funkcijos reikšmės bus labai koreliuotos. Galime vizualizuoti nustatymo iš procesą tiek funkcijų erdvėje, tiek jungtiniame skirstinyje . Pirmiausia panagrinėkime tokį , kad , o , tai reiškia, kad reikšmė yra vidutiniškai koreliuota su reikšme. Jungtiniame skirstinyje pastovios tikimybės kontūrai bus gana siauros elipsės.
Tarkime, kad stebime . Norėdami sąlygoti šia reikšme, galime nubrėžti horizontalią liniją ties tankio grafike ir pamatyti, kad reikšmė daugiausia apribojama intervale . Šį grafiką taip pat nubraižėme funkcijų erdvėje, parodydami stebimą tašką oranžine spalva ir 1 standartinį Gauso proceso prognozuojamojo skirstinio nuokrypį mėlyna spalva apie vidurkio reikšmę .


Dabar tarkime, kad turime stipresnę koreliaciją, . Dabar elipsės dar labiau susiaurėjo, o reikšmė dar stipriau nulemta pagal . Nubrėžę horizontalią liniją ties , matome, kad kontūrai palaiko reikšmes daugiausia intervale . Vėlgi parodome ir grafiką funkcijų erdvėje su vienu standartiniu nuokrypiu apie vidutinę prognozuojamąją reikšmę .


Matome, kad mūsų Gauso proceso aposteriorinis vidurkio prognozuotuvas yra arčiau , nes dabar yra stipresnė koreliacija. Taip pat matome, kad mūsų neapibrėžtumas (paklaidos juostos) kiek sumažėjo. Nepaisant stiprios šių funkcijos reikšmių koreliacijos, mūsų neapibrėžtumas vis tiek pagrįstai gana didelis, nes stebėjome tik vieną duomenų tašką!
Ši procedūra gali suteikti aposteriorinį skirstinį bet kuriam su bet kuriuo stebėtų taškų skaičiumi. Tarkime, stebime . Dabar vizualizuojame aposteriorinį skirstinį tam tikrame funkcijų erdvėje. Tikslus skirstinys nurodytas aukščiau pateiktomis lygtimis. yra pasiskirstęs pagal Gauso skirstinį su vidurkiu
ir dispersija
Šioje įvadinėje užrašų knygutėje nagrinėjome be triukšmo stebinius. Kaip pamatysime, stebėjimo triukšmą įtraukti lengva. Jei darome prielaidą, kad duomenys generuojami iš latentinės be triukšmo funkcijos plius nepriklausomo vienodai pasiskirsčiusio (iid) Gauso triukšmo su dispersija , tada mūsų kovariacijos funkcija tiesiog tampa , kur , jei , ir kitu atveju.
Jau pradėjome įgyti tam tikrą intuiciją, kaip galime naudoti Gauso procesą aprioriniam ir aposterioriniam sprendinių skirstiniui nurodyti ir kaip branduolio funkcija veikia šių sprendinių savybes. Kitose užrašų knygutėse tiksliai parodysime, kaip nurodyti Gauso proceso apriorinį skirstinį, pristatysime ir išvesime įvairias branduolio funkcijas, o tada aptarsime, kaip automatiškai išmokti branduolio hiperparametrus ir sudaryti Gauso proceso aposteriorinį skirstinį prognozėms daryti. Nors reikia laiko ir praktikos priprasti prie tokių sąvokų kaip „funkcijų skirstiniai“, pati GP prognozavimo lygčių radimo mechanika iš tikrųjų yra gana paprasta, todėl lengva praktikuotis, kad susiformuotų intuityvus šių sąvokų supratimas.
18.1.1 Santrauka
Tipiniame mašininiame mokymesi nurodome funkciją su tam tikrais laisvais parametrais (pavyzdžiui, neuroninį tinklą ir jo svorius) ir sutelkiame dėmesį į šių parametrų, kurie gali būti neinterpretuojami, vertinimą. Su Gauso procesu vietoj to samprotaujame tiesiogiai apie funkcijų skirstinius, o tai leidžia mums samprotauti apie aukšto lygio sprendinių savybes. Šias savybes valdo kovariacijos funkcija (branduolys), kuri dažnai turi kelis labai interpretuojamus hiperparametrus. Šie hiperparametrai apima ilgio skalę, kuri valdo, kaip sparčiai (kaip banguotai) kinta funkcijos. Kitas hiperparametras yra amplitudė, kuri valdo vertikalųjį mastelį, kuriuo mūsų funkcijos kinta. Daugelio skirtingų funkcijų, kurios gali atitikti duomenis, atvaizdavimas ir jų sujungimas į prognozuojamąjį skirstinį yra išskirtinė Bajeso metodų savybė. Kadangi tarp galimų sprendinių toli nuo duomenų yra didesnis kintamumas, mūsų neapibrėžtumas intuityviai didėja tolstant nuo duomenų.
Gauso procesas atvaizduoja funkcijų skirstinį nurodydamas daugiamatį normalųjį (Gauso) skirstinį visoms galimoms funkcijos reikšmėms. Gauso skirstinius galima lengvai manipuliuoti, kad būtų rastas vienos funkcijos reikšmės skirstinys pagal bet kurios kitų reikšmių aibės reikšmes. Kitaip tariant, jei stebime taškų aibę, galime sąlygoti šiais taškais ir daryti inferenciją apie skirstinį, kaip gali atrodyti funkcijos reikšmė bet kurioje kitoje įvestyje. Tai, kaip modeliuojame koreliacijas tarp šių taškų, nustato kovariacijos funkcija ir būtent tai apibrėžia Gauso proceso apibendrinimo savybes. Nors reikia laiko priprasti prie Gauso procesų, su jais lengva dirbti, jie turi daug taikymų ir padeda suprasti bei kurti kitas modelių klases, pavyzdžiui, neuroninius tinklus.
18.1.2 Pratimai
- Koks skirtumas tarp epistemilinio neapibrėžtumo ir stebėjimo neapibrėžtumo?
- Be kitimo spartos ir amplitudės, kokias kitas funkcijų savybes galėtume norėti apsvarstyti ir kokie būtų realaus pasaulio funkcijų, turinčių tas savybes, pavyzdžiai?
- Mūsų nagrinėta RBF kovariacijos funkcija teigia, kad kovariacijos (ir koreliacijos) tarp stebinių mažėja didėjant jų atstumui įvesčių erdvėje (laikai, erdvinės vietos ir kt.). Ar tai pagrįsta prielaida? Kodėl taip arba kodėl ne?
- Ar dviejų Gauso kintamųjų suma yra Gauso? Ar dviejų Gauso kintamųjų sandauga yra Gauso? Jei (a,b) turi jungtinį Gauso skirstinį, ar a|b (a esant b) yra Gauso? Ar a yra Gauso?
- Pakartokite pratimą, kuriame stebime duomenų tašką , bet dabar tarkime, kad papildomai stebime . Tegu ir . Ar dabar būsime daugiau, ar mažiau tikri dėl reikšmės, nei kai buvome stebėję tik ? Koks dabar yra mūsų reikšmės vidurkis ir 95 % patikimoji aibė?
- Kaip manote, ar padidinus mūsų stebėjimo triukšmo įvertį padidėtų, ar sumažėtų mūsų etaloninės funkcijos ilgio skalės įvertis?
- Tarkime, tolstant nuo duomenų neapibrėžtumas mūsų prognozuojamajame skirstinyje didėja iki tam tikro taško, o tada nustoja didėti. Kodėl taip gali nutikti?