
4.1 Softmax regresija
3.1 skyrelis pristatėme tiesinę regresiją, išnagrinėdami įgyvendinimus nuo nulio 3.4 skyrelis ir dar kartą naudodami giliojo mokymosi karkaso aukšto lygio API 3.5 skyrelis, kad atliktume sunkųjį darbą.
Regresija yra plaktukas, kurio griebiamės, kai norime atsakyti į klausimus kiek? ar kiek vienetų?. Jei norite prognozuoti dolerių skaičių (kainą), už kurį bus parduotas namas, arba pergalių skaičių, kurį gali pasiekti beisbolo komanda, arba dienų skaičių, kurį pacientas praleis ligoninėje prieš išrašymą, tuomet tikriausiai ieškote regresijos modelio. Tačiau net ir tarp regresijos modelių yra svarbių skirtumų. Pavyzdžiui, namo kaina niekada nebus neigiama, o pokyčiai dažnai gali būti santykiniai pagal jo bazinę kainą. Todėl gali būti efektyviau atlikti regresiją kainos logaritmui. Panašiai dienų skaičius, kurį pacientas praleidžia ligoninėje, yra diskretus neneigiamas atsitiktinis dydis. Todėl mažiausių kvadratų metodas taip pat gali nebūti idealus būdas. Šis laiko iki įvykio modeliavimo tipas turi daugybę kitų komplikacijų, kurias sprendžia specializuota sritis, vadinama išgyvenamumo modeliavimu.
Čia tikslas nėra jūsų priblokšti, o tiesiog leisti suprasti, kad vertinimas apima daug daugiau nei tiesiog kvadratinių paklaidų minimizavimas. O plačiau žiūrint, prižiūrimas mokymas apima daug daugiau nei regresija. Šiame skyrelyje sutelkiame dėmesį į klasifikavimo uždavinius, kuriuose atidedame klausimus kiek? ir vietoj to koncentruojamės į klausimus kuri kategorija?.
- Ar šis el. laiškas priklauso šlamšto aplankui, ar gautiesiems?
- Ar šis klientas labiau linkęs užsisakyti, ar neužsisakyti prenumeratos paslaugos?
- Ar šiame paveikslėlyje pavaizduotas asilas, šuo, katė ar gaidys?
- Kokį filmą Astonas greičiausiai žiūrės toliau?
- Kurią knygos dalį skaitysite toliau?
Šnekamojoje kalboje mašininio mokymosi specialistai žodį klasifikavimas vartoja dviem subtiliai skirtingoms problemoms apibūdinti: (i) tos, kuriose mus domina tik griežtas pavyzdžių priskyrimas kategorijoms (klasėms); ir (ii) tos, kuriose norime atlikti švelnų priskyrimą, t. y. įvertinti tikimybę, kad taikoma kiekviena kategorija. Skirtumas linkęs išsitrinti iš dalies todėl, kad dažnai, net kai mums rūpi tik griežti priskyrimai, vis tiek naudojame modelius, atliekančius švelnius priskyrimus.
Be to, pasitaiko atvejų, kai teisingų žymenų gali būti daugiau nei vienas. Pavyzdžiui, naujienų straipsnis gali vienu metu apimti pramogų, verslo ir kosminių skrydžių temas, bet ne medicinos ar sporto temas. Todėl priskirti jį vienai iš aukščiau išvardytų kategorijų atskirai nebūtų labai naudinga. Ši problema paprastai žinoma kaip daugelio žymenų klasifikavimas. Apžvalgą žr. (Tsoumakas ir Katakis, 2007), o efektyvų algoritmą paveikslėlių žymėjimui – (Huang ir kt., 2015).
4.1.1 Klasifikavimas
Kad pramintume taką, pradėkime nuo paprasto vaizdų klasifikavimo uždavinio. Čia kiekviena įvestis yra pilkumo atspalvių vaizdas. Kiekvieną pikselio reikšmę galime pavaizduoti vienu skaliaru, gaudami keturis požymius . Be to, tarkime, kad kiekvienas vaizdas priklauso vienai iš kategorijų „katė", „višta" ir „šuo".
Toliau turime pasirinkti, kaip atvaizduoti žymenis. Turime du akivaizdžius pasirinkimus. Galbūt natūraliausias impulsas būtų pasirinkti , kur sveikieji skaičiai atitinkamai atvaizduoja . Tai puikus būdas tokią informaciją saugoti kompiuteryje. Jei kategorijos turėtų natūralią tvarką, tarkime, jei bandytume prognozuoti , tada gali net būti prasminga laikyti tai eilinės regresijos uždaviniu ir išlaikyti žymenis tokiu formatu. Įvairių rangavimo nuostolių funkcijų tipų apžvalgą žr. (Moon ir kt., 2010), o Bajeso metodą, sprendžiantį atsakymus su daugiau nei viena moda, – (Beutel ir kt., 2014).
Apskritai klasifikavimo uždaviniai neturi natūralios klasių tvarkos. Laimei, statistikai seniai išrado paprastą būdą kategoriniams duomenims atvaizduoti: fiktyvųjį (angl. one-hot) kodavimą. Fiktyvusis kodavimas yra vektorius, turintis tiek komponenčių, kiek turime kategorijų. Komponentė, atitinkanti konkretaus egzemplioriaus kategoriją, nustatoma lygi 1, o visos kitos komponentės – 0. Mūsų atveju žymuo būtų trimatis vektorius, kur atitinka „katę", – „vištą", o – „šunį":
4.1.1.1 Tiesinis modelis
Norėdami įvertinti sąlygines tikimybes, susijusias su visomis galimomis klasėmis, mums reikia modelio su keliomis išvestimis, po vieną kiekvienai klasei. Kad klasifikavimą spręstume tiesiniais modeliais, mums reikės tiek afininių funkcijų, kiek turime išvesčių. Griežtai kalbant, mums reikia vienos mažiau, nes paskutinė kategorija turi būti skirtumas tarp ir kitų kategorijų sumos, bet dėl simetrijos naudojame šiek tiek perteklinę parametrizaciją. Kiekviena išvestis atitinka savo afininę funkciją. Mūsų atveju, kadangi turime 4 požymius ir 3 galimas išvesties kategorijas, mums reikia 12 skaliarų svoriams atvaizduoti ( su apatiniais indeksais) ir 3 skaliarų poslinkiams atvaizduoti ( su apatiniais indeksais). Gauname:
Atitinkama neuroninio tinklo diagrama parodyta 4.1.1 pav.. Kaip ir tiesinėje regresijoje, naudojame vieno sluoksnio neuroninį tinklą. O kadangi kiekvienos išvesties ir skaičiavimas priklauso nuo kiekvienos įvesties , , ir , išvesties sluoksnį taip pat galima apibūdinti kaip pilnai sujungtą sluoksnį.
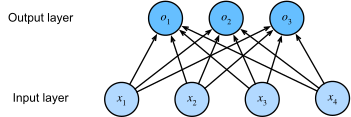
4.1.1 pav. Softmax regresija yra vieno sluoksnio neuroninis tinklas.
Glaustesniam žymėjimui naudojame vektorius ir matricas: daug geriau tinka matematikai ir kodui. Atkreipkite dėmesį, kad visus savo svorius surinkome į matricą, o visus poslinkius – į vektorių.
4.1.1.2 Softmax funkcija
Darydami prielaidą, kad turime tinkamą nuostolių funkciją, galėtume bandyti tiesiogiai minimizuoti skirtumą tarp ir žymenų . Nors pasirodo, kad klasifikavimo traktavimas kaip vektorinės reikšmės regresijos uždavinio veikia stebėtinai gerai, vis dėlto jis nėra patenkinamas šiais atžvilgiais:
- Nėra garantijos, kad išvestys sudės į taip, kaip tikimės iš tikimybių.
- Nėra garantijos, kad išvestys yra net neneigiamos, net jei jų suma lygi , arba kad jos neviršija .
Abu aspektai apsunkina vertinimo uždavinį ir daro sprendinį labai jautrų nuokrypiams. Pavyzdžiui, jei darome prielaidą, kad yra teigiama tiesinė priklausomybė tarp miegamųjų skaičiaus ir tikimybės, kad kas nors nupirks namą, tikimybė gali viršyti , kai kalbama apie dvaro pirkimą! Todėl mums reikia mechanizmo išvestims „suspausti".
Yra daug būdų šiam tikslui pasiekti. Pavyzdžiui, galėtume daryti prielaidą, kad išvestys yra iškraipytos versijos, kur iškraipymas atsiranda pridedant triukšmą , paimtą iš normaliojo skirstinio. Kitaip tariant, , kur . Tai vadinamasis probito modelis, pirmą kartą pristatytas (Fechner, 1860). Nors patrauklus, jis neveikia taip gerai ir neveda prie ypač gražaus optimizavimo uždavinio, palyginti su softmax.
Kitas būdas šiam tikslui pasiekti (ir užtikrinti neneigiamumą) yra naudoti eksponentinę funkciją . Tai iš tiesų tenkina reikalavimą, kad sąlyginė klasės tikimybė didėja didėjant , ji yra monotoninė, ir visos tikimybės yra neneigiamos. Tada šias reikšmes galime transformuoti taip, kad jos sudėtų į , kiekvieną padalydami iš jų sumos. Šis procesas vadinamas normalizavimu. Sujungus šias dvi dalis, gauname softmax funkciją:
Atkreipkite dėmesį, kad didžiausia koordinatė atitinka labiausiai tikėtiną klasę pagal . Be to, kadangi softmax operacija išsaugo savo argumentų tvarką, mums nereikia skaičiuoti softmax, kad nustatytume, kuriai klasei priskirta didžiausia tikimybė. Taigi,
Softmax idėja siekia (Gibbs, 1902), kuris pritaikė fizikos idėjas. Dar anksčiau Bolcmanas, šiuolaikinės statistinės fizikos tėvas, šį triuką naudojo energijos būsenų skirstiniui dujų molekulėse modeliuoti. Visų pirma jis atrado, kad energijos būsenos paplitimas termodinaminiame ansamblyje, pavyzdžiui, dujų molekulėse, yra proporcingas . Čia yra būsenos energija, – temperatūra, o – Bolcmano konstanta. Kai statistikai kalba apie statistinės sistemos „temperatūros" didinimą ar mažinimą, jie turi omenyje keitimą, siekiant palankesnių žemesnės ar aukštesnės energijos būsenų. Sekant Gibbso idėja, energija prilygsta paklaidai. Energija pagrįsti modeliai (Ranzato ir kt., 2007) šį požiūrį naudoja aprašydami giliojo mokymosi uždavinius.
4.1.1.3 Vektorizacija
Kad pagerintume skaičiavimo efektyvumą, skaičiavimus vektorizuojame duomenų minirinkiniuose. Tarkime, kad mums duotas minirinkinys iš pavyzdžių, kurių dimensija (įvesčių skaičius) . Be to, tarkime, kad išvestyje turime kategorijų. Tada svoriai tenkina , o poslinkis tenkina .
Tai pagreitina dominuojančią operaciją iki matricos ir matricos sandaugos . Be to, kadangi kiekviena eilutė atvaizduoja duomenų pavyzdį, pačią softmax operaciją galima apskaičiuoti eilutėmis: kiekvienai eilutei pakeliame eksponente visus įrašus ir tada normalizuojame juos suma. Tačiau atkreipkite dėmesį, kad reikia būti atsargiems, kad nebūtų keliami eksponente ir logaritmuojami dideli skaičiai, nes tai gali sukelti skaitinį perpildymą ar nepakankamumą. Giliojo mokymosi karkasai tuo pasirūpina automatiškai.
4.1.2 Nuostolių funkcija
Kai jau turime atvaizdį iš požymių į tikimybes , mums reikia būdo optimizuoti šio atvaizdžio tikslumą. Remsimės didžiausio tikėtinumo vertinimu, tuo pačiu metodu, su kuriuo susidūrėme, teikdami tikimybinį pagrindimą vidutinės kvadratinės paklaidos nuostoliams 3.1.3 skyrelis.
4.1.2.1 Logaritminis tikėtinumas
Softmax funkcija pateikia mums vektorių , kurį galime interpretuoti kaip (įvertintas) sąlygines tikimybes kiekvienos klasės, kai duota bet kuri įvestis , pavyzdžiui, = . Toliau darome prielaidą, kad duomenų rinkiniui su požymiais žymenys atvaizduojami fiktyviuoju žymenų vektoriumi. Įverčius galime palyginti su tikrove, patikrindami, kiek tikėtinos faktinės klasės pagal mūsų modelį, kai duoti požymiai:
Galime naudoti faktorizaciją, nes darome prielaidą, kad kiekvienas žymuo paimtas nepriklausomai iš savo atitinkamo skirstinio . Kadangi narių sandaugos maksimizavimas yra nepatogus, imame neigiamą logaritmą ir gauname ekvivalentų neigiamo logaritminio tikėtinumo minimizavimo uždavinį:
kur bet kuriai žymens ir modelio prognozės per klasių porai nuostolių funkcija yra
Dėl priežasčių, kurios paaiškinamos vėliau, nuostolių funkcija (4.1.3) paprastai vadinama kryžminės entropijos nuostoliais. Kadangi yra ilgio fiktyvusis vektorius, suma per visas jo koordinates išnyksta visiems nariams, išskyrus vieną. Atkreipkite dėmesį, kad nuostoliai yra apriboti iš apačios , kai tik yra tikimybių vektorius: nė vienas įrašas nėra didesnis nei , todėl jų neigiamas logaritmas negali būti mažesnis nei ; tik tada, jei prognozuojame faktinį žymenį su tikrumu. Taip niekada negali nutikti jokiam baigtiniam svorių nustatymui, nes softmax išvesties artinimas link reikalauja atitinkamos įvesties artinimo į begalybę (arba visų kitų išvesčių , kai , į neigiamą begalybę). Net jei mūsų modelis galėtų priskirti išvesties tikimybę , bet kokia klaida, padaryta priskiriant tokį didelį pasitikėjimą, sukeltų begalinius nuostolius ().
4.1.2.2 Softmax ir kryžminės entropijos nuostoliai
Kadangi softmax funkcija ir atitinkami kryžminės entropijos nuostoliai yra tokie dažni, verta šiek tiek geriau suprasti, kaip jie skaičiuojami. Įstatę (4.1.1) į nuostolių apibrėžimą (4.1.3) ir pasinaudoję softmax apibrėžimu, gauname
Kad šiek tiek geriau suprastume, kas vyksta, panagrinėkime išvestinę bet kurio logito atžvilgiu. Gauname
Kitaip tariant, išvestinė yra skirtumas tarp tikimybės, priskirtos mūsų modelio, išreikštos softmax operacija, ir to, kas iš tikrųjų įvyko, išreikšto fiktyviojo žymenų vektoriaus elementais. Šia prasme tai labai panašu į tai, ką matėme regresijoje, kur gradientas buvo skirtumas tarp stebinio ir įverčio . Tai nėra sutapimas. Bet kuriame eksponentinės šeimos modelyje logaritminio tikėtinumo gradientai yra išreiškiami būtent šiuo nariu. Šis faktas praktikoje palengvina gradientų skaičiavimą.
Dabar panagrinėkime atvejį, kai stebime ne tik vieną baigtį, bet visą baigčių skirstinį. Žymeniui galime naudoti tą patį atvaizdavimą kaip ir anksčiau. Vienintelis skirtumas yra tas, kad užuot turėję vektorių, kurio įrašai tik dvejetainiai, tarkime, , dabar turime bendrą tikimybių vektorių, tarkime, . Matematika, kurią anksčiau naudojome nuostoliams apibrėžti (4.1.3), vis dar gerai veikia, tik interpretacija yra šiek tiek bendresnė. Tai nuostolių tikėtina reikšmė žymenų skirstiniui. Šie nuostoliai vadinami kryžminės entropijos nuostoliais, ir tai yra vieni dažniausiai naudojamų klasifikavimo uždavinių nuostolių. Pavadinimą galime išmistifikuoti pristatę tik informacijos teorijos pagrindus. Trumpai tariant, jie matuoja bitų skaičių, reikalingą užkoduoti tai, ką matome, , palyginti su tuo, ką prognozuojame, kad turėtų nutikti, . Toliau pateikiame labai paprastą paaiškinimą. Daugiau detalių apie informacijos teoriją žr. (Cover ir Thomas, 1999) arba (MacKay, 2003).
4.1.3 Informacijos teorijos pagrindai
Daugelis giliojo mokymosi straipsnių naudoja intuiciją ir terminus iš informacijos teorijos. Kad juos suprastume, mums reikia kokios nors bendros kalbos. Tai išgyvenimo vadovas. Informacijos teorija nagrinėja informacijos (taip pat žinomos kaip duomenys) kodavimo, dekodavimo, perdavimo ir manipuliavimo ja problemą.
4.1.3.1 Entropija
Pagrindinė informacijos teorijos idėja yra kiekybiškai įvertinti duomenyse esančios informacijos kiekį. Tai nustato ribą mūsų gebėjimui suspausti duomenis. Skirstinio entropija, , apibrėžiama taip:
Viena iš fundamentalių informacijos teorijos teoremų teigia, kad norint užkoduoti duomenis, atsitiktinai paimtus iš skirstinio , mums reikia bent „natų" jiems užkoduoti (Shannon, ). Jei susimąstote, kas yra „nata", tai yra bito atitikmuo, bet naudojant kodą su pagrindu , o ne su pagrindu 2. Taigi viena nata yra bito.
4.1.3.2 Netikėtumas
Galbūt susimąstote, ką bendro suspaudimas turi su prognozavimu. Įsivaizduokite, kad turime duomenų srautą, kurį norime suspausti. Jei mums visada lengva prognozuoti kitą ženklą, tada šiuos duomenis lengva suspausti. Paimkime kraštutinį pavyzdį, kai kiekvienas srauto ženklas visada įgyja tą pačią reikšmę. Tai labai nuobodus duomenų srautas! Ir ne tik nuobodus, bet ir lengvai prognozuojamas. Kadangi ženklai visada tokie patys, mums nereikia perduoti jokios informacijos, kad perteiktume srauto turinį. Lengva prognozuoti, lengva suspausti.
Tačiau jei negalime tobulai prognozuoti kiekvieno įvykio, kartais galime būti nustebinti. Mūsų nustebimas didesnis, kai įvykiui priskirta mažesnė tikimybė. Claude'as Shannonas apsisprendė dėl , kad kiekybiškai įvertintų savo netikėtumą (angl. surprisal), stebint įvykį , kuriam priskyrė (subjektyvią) tikimybę . Entropija, apibrėžta (4.1.4), tada yra tikėtinas netikėtumas, kai priskiriamos teisingos tikimybės, tiksliai atitinkančios duomenis generuojantį procesą.
4.1.3.3 Dar kartą apie kryžminę entropiją
Taigi, jei entropija yra nustebimo lygis, kurį patiria žinantis tikrąją tikimybę, tai galbūt susimąstote, kas yra kryžminė entropija? Kryžminė entropija iš į , žymima , yra tikėtinas stebėtojo su subjektyviomis tikimybėmis netikėtumas, pamačius duomenis, kurie iš tikrųjų sugeneruoti pagal tikimybes . Ji duodama . Mažiausia galima kryžminė entropija pasiekiama, kai . Šiuo atveju kryžminė entropija iš į yra .
Trumpai tariant, kryžminės entropijos klasifikavimo tikslą galime suprasti dvejopai: (i) kaip stebėtų duomenų tikėtinumo maksimizavimą; ir (ii) kaip mūsų netikėtumo (ir taigi bitų skaičiaus), reikalingo žymenims perduoti, minimizavimą.
4.1.4 Santrauka ir diskusija
Šiame skyrelyje susidūrėme su pirmąja netrivialia nuostolių funkcija, leidžiančia optimizuoti diskrečiose išvesties erdvėse. Svarbiausia jos kūrime buvo tai, kad taikėme tikimybinį požiūrį, diskrečias kategorijas traktuodami kaip tikimybių skirstinio imčių egzempliorius. Kaip šalutinį poveikį, susidūrėme su softmax, patogia aktyvacijos funkcija, kuri paverčia įprasto neuroninio tinklo sluoksnio išvestis tinkamais diskrečiaisiais tikimybių skirstiniais. Matėme, kad kryžminės entropijos nuostolių išvestinė, kai derinama su softmax, elgiasi labai panašiai kaip kvadratinės paklaidos išvestinė; būtent, imant skirtumą tarp tikėtino elgesio ir jo prognozės. Ir nors pavyko tik paliesti paviršių, susidūrėme su įdomiais ryšiais su statistine fizika ir informacijos teorija.
Nors to pakanka, kad pradėtumėte, ir, tikimės, pakankamai, kad sužadintumėte apetitą, čia giliai nenėrėme. Be kita ko, praleidome skaičiavimo aspektus. Visų pirma bet kuriam pilnai sujungtam sluoksniui su įvesčių ir išvesčių parametrizavimo ir skaičiavimo kaštai yra , o tai praktikoje gali būti nepagrįstai didelė kaina. Laimei, šią įvesčių transformavimo į išvesčių kainą galima sumažinti aproksimacija ir suspaudimu. Pavyzdžiui, Deep Fried Convnets (Yang ir kt., 2015) naudoja permutacijų, Furjė transformacijų ir mastelio keitimo derinį, kad sumažintų kainą nuo kvadratinės iki logaritminės tiesinės. Panašūs metodai veikia pažangesniems struktūrinių matricų aproksimavimams (Sindhwani ir kt., 2015). Galiausiai galime naudoti į kvaternionus panašias dekompozicijas, kad sumažintume kainą iki , vėlgi, jei esame pasirengę aukoti nedidelį tikslumo kiekį skaičiavimo ir saugojimo kainos naudai (Zhang ir kt., 2021), remiantis suspaudimo koeficientu . Tai aktyvi tyrimų sritis. Sudėtinga tai, kad mes nebūtinai siekiame kompaktiškiausio atvaizdavimo ar mažiausio slankiojo kablelio operacijų skaičiaus, o veikiau sprendinio, kurį galima efektyviausiai vykdyti šiuolaikiniuose GPU.
4.1.5 Pratimai
- Galime šiek tiek giliau ištirti ryšį tarp eksponentinių šeimų ir softmax.
- Apskaičiuokite kryžminės entropijos nuostolių antrąją išvestinę softmax atveju.
- Apskaičiuokite skirstinio, duodamo , dispersiją ir parodykite, kad ji sutampa su aukščiau apskaičiuota antrąja išvestine.
- Tarkime, kad turime tris klases, kurios pasitaiko su vienoda tikimybe, t. y. tikimybių vektorius yra .
- Kokia problema kyla bandant jai sukurti dvejetainį kodą?
- Ar galite sukurti geresnį kodą? Užuomina: kas nutinka, jei bandome koduoti du nepriklausomus stebinius? O jei koduojame stebinių kartu?
- Koduodami signalus, perduodamus fiziniu laidu, inžinieriai ne visada naudoja dvejetainius kodus. Pavyzdžiui, PAM-3 naudoja tris signalo lygius , o ne du lygius . Kiek trejetainių vienetų jums reikia sveikajam skaičiui iš intervalo perduoti? Kodėl tai gali būti geresnė idėja elektronikos požiūriu?
- Bradley ir Terry modelis naudoja
logistinį modelį pirmenybėms užfiksuoti. Kad naudotojas rinktųsi tarp obuolių ir apelsinų,
daroma prielaida apie balus ir . Mūsų reikalavimai yra tokie, kad didesni balai turėtų lemti didesnį tikėtinumą pasirinkti susijusį elementą ir kad
elementas su didžiausiu balu yra labiausiai tikėtinas pasirinkimas (Bradley ir Terry, 1952).
- Įrodykite, kad softmax tenkina šį reikalavimą.
- Kas nutinka, jei norite leisti numatytąjį pasirinkimą – nei obuolių, nei apelsinų? Užuomina: dabar naudotojas turi tris pasirinkimus.
- Softmax savo pavadinimą gavo iš šio atvaizdžio: .
- Įrodykite, kad .
- Kiek mažą galite padaryti skirtumą tarp abiejų funkcijų? Užuomina: be bendrumo apribojimo galite nustatyti ir .
- Įrodykite, kad tai galioja , jei .
- Parodykite, kad kai , turime .
- Sukonstruokite analogišką softmin funkciją.
- Išplėskite tai daugiau nei dviem skaičiams.
- Funkcija kartais taip pat vadinama logaritmine statistine suma.
- Įrodykite, kad ši funkcija yra iškila. Užuomina: tam pasinaudokite faktu, kad pirmoji išvestinė lygi softmax funkcijos tikimybėms, ir parodykite, kad antroji išvestinė yra dispersija.
- Parodykite, kad yra invariantiška postūmiui, t. y. .
- Kas nutinka, jei kai kurios koordinatės yra labai didelės? Kas nutinka, jei jos visos labai mažos?
- Parodykite, kad jei pasirinksime , gausime skaitiškai stabilų įgyvendinimą.
- Tarkime, kad turime tam tikrą tikimybių skirstinį . Tarkime, pasirenkame kitą skirstinį su , kai .
- Kuris pasirinkimas atitinka temperatūros padvigubinimą? Kuris pasirinkimas atitinka jos perpus sumažinimą?
- Kas nutinka, jei leidžiame temperatūrai artėti prie ?
- Kas nutinka, jei leidžiame temperatūrai artėti prie ?