
3.6 Apibendrinimas
Įsivaizduokite du kolegijos studentus, stropiai besirengiančius baigiamajam egzaminui. Paprastai toks pasirengimas susideda iš įgūdžių lavinimo ir tikrinimosi sprendžiant ankstesnių metų egzaminus. Vis dėlto gerai išlaikyti praėjusių metų egzaminai negarantuoja, kad jie pasirodys puikiai, kai tai bus svarbu. Pavyzdžiui, įsivaizduokite studentę Nepaprastąją Eliją, kurios pasirengimas visiškai susidėjo iš ankstesnių metų egzamino klausimų atsakymų įsiminimo. Net jei Elija turėtų nepaprastą atmintį ir todėl galėtų tobulai prisiminti atsakymą į bet kurį anksčiau matytą klausimą, ji vis tiek gali sustingti, susidūrusi su nauju (anksčiau nematytu) klausimu. Palyginimui įsivaizduokite kitą studentę, Indukcinę Irenę, kurios įsiminimo įgūdžiai palyginti prasti, bet kuri turi gabumų pastebėti dėsningumus. Atkreipkite dėmesį, kad jei egzaminas tikrai susidėtų iš pernai metų klausimų, Elija lengvai pranoktų Irenę. Net jei Irenės išvesti dėsningumai duotų 90 % tikslumo prognozes, jie niekada negalėtų konkuruoti su Elijos 100 % prisiminimu. Tačiau net jei egzaminas susidėtų vien iš naujų klausimų, Irenė galėtų išlaikyti savo 90 % vidurkį.
Kaip mašininio mokymosi mokslininkų, mūsų tikslas yra atrasti dėsningumus. Bet kaip galime būti tikri, kad iš tiesų atradome bendrą dėsningumą, o ne tiesiog įsiminėme savo duomenis? Daugeliu atvejų mūsų prognozės naudingos tik tada, jei mūsų modelis atranda tokį dėsningumą. Mes nenorime prognozuoti vakarykščių akcijų kainų, o tik rytojaus. Mums nereikia atpažinti jau diagnozuotų ligų anksčiau matytiems pacientams, o veikiau anksčiau nediagnozuotus negalavimus anksčiau nematytiems pacientams. Ši problema – kaip atrasti dėsningumus, kurie apibendrinami – yra pagrindinė mašininio mokymosi problema ir, tikriausiai, visos statistikos. Šią problemą galėtume laikyti tik viena dalimi daug didesnio klausimo, apimančio visą mokslą: kada mes apskritai turime pagrindą peršokti nuo konkrečių stebinių prie bendresnių teiginių?
Realiame gyvenime savo modelius turime pritaikyti naudodami baigtinį duomenų rinkinį. Tipiniai tų duomenų mastai labai skiriasi įvairiose srityse. Daugeliui svarbių medicininių problemų galime pasiekti tik kelis tūkstančius duomenų taškų. Tyrinėjant retas ligas, gali pasisekti, jei pavyks gauti šimtus. Priešingai, didžiausi vieši duomenų rinkiniai, sudaryti iš pažymėtų nuotraukų, pvz., ImageNet (Deng ir kt., 2009), turi milijonus vaizdų. O kai kurie nepažymėtų vaizdų rinkiniai, tokie kaip Flickr YFC100M duomenų rinkinys, gali būti dar didesni, turintys daugiau nei 100 milijonų vaizdų (Thomee ir kt., 2016). Tačiau net ir esant tokiam ekstremaliam mastui, turimų duomenų taškų skaičius išlieka be galo mažas, palyginti su visų galimų megapikselio skyros vaizdų erdve. Kai tik dirbame su baigtinėmis imtimis, turime nepamiršti rizikos, kad galime pritaikyti savo apmokymo duomenis ir tik tada pamatyti, kad nepavyko atrasti apibendrinamo dėsningumo.
Reiškinys, kai modelis pritaikomas artimiau mūsų apmokymo duomenims, nei pagrindiniam skirstiniui, vadinamas persimokymu, o persimokymo prevencijos metodai dažnai vadinami reguliarizavimo metodais. Nors tai nepakeičia tinkamo įvado į statistinio mokymosi teoriją (žr. (V. Vapnik, ; Boucheron ir kt., 2005)), suteiksime pakankamai intuicijos, kad galėtumėte pradėti. Prie apibendrinimo sugrįšime daugelyje knygos skyrių, nagrinėdami tiek tai, kas žinoma apie apibendrinimo pagrindinius principus įvairiuose modeliuose, tiek euristinius metodus, kurie (empiriškai) padeda pagerinti apibendrinimą praktiškai svarbiose užduotyse.
3.6.1 Apmokymo paklaida ir apibendrinimo paklaida
Standartinėje prižiūrimo mokymo aplinkoje darome prielaidą, kad apmokymo duomenys ir testavimo duomenys paimti nepriklausomai iš identiškų skirstinių. Tai paprastai vadinama IID prielaida (nepriklausomi ir vienodai pasiskirstę). Nors ši prielaida stipri, verta pažymėti, kad be jokios tokios prielaidos būtume bejėgiai. Kodėl turėtume tikėti, kad apmokymo duomenys, paimti iš skirstinio , gali mums pasakyti, kaip daryti prognozes testavimo duomenims, sugeneruotiems kito skirstinio ? Pasirodo, tokiems šuoliams reikia stiprių prielaidų apie tai, kaip susiję ir . Vėliau aptarsime kai kurias prielaidas, leidžiančias skirstinio pokyčius, bet pirmiausia turime suprasti IID atvejį, kai .
Pirmiausia turime atskirti apmokymo paklaidą , kuri yra statistika, apskaičiuota apmokymo duomenų rinkinyje, ir apibendrinimo paklaidą , kuri yra vidurkis, paimtas pagal pagrindinį skirstinį. Apibendrinimo paklaidą galite įsivaizduoti kaip tai, ką pamatytumėte, jei pritaikytumėte savo modelį begaliniam papildomų duomenų pavyzdžių srautui, paimtam iš to paties pagrindinio duomenų skirstinio. Formaliai apmokymo paklaida išreiškiama suma (tuo pačiu žymėjimu kaip 3.1 skyrelis):
o apibendrinimo paklaida išreiškiama integralu:
Problema ta, kad apibendrinimo paklaidos niekada negalime apskaičiuoti tiksliai. Niekas niekada nepasako mums tikslios tankio funkcijos formos. Be to, negalime paimti begalinio duomenų taškų srauto. Todėl praktikoje apibendrinimo paklaidą turime įvertinti, taikydami savo modelį nepriklausomai testavimo aibei, sudarytai iš atsitiktinai parinktų pavyzdžių ir žymenų , kurie buvo atskirti nuo mūsų apmokymo aibės. Tai reiškia tos pačios formulės, kuri naudojama empirinei apmokymo paklaidai skaičiuoti, taikymą testavimo aibei .
Esminis dalykas: kai vertiname savo klasifikatorių testavimo aibėje, dirbame su fiksuotu klasifikatoriumi (jis nepriklauso nuo testavimo aibės imties), todėl jo paklaidos įvertinimas yra tiesiog vidurkio vertinimo uždavinys. Tačiau to paties negalima pasakyti apie apmokymo aibę. Atkreipkite dėmesį, kad galutinis modelis aiškiai priklauso nuo apmokymo aibės pasirinkimo, todėl apmokymo paklaida apskritai bus paslinktas tikrosios paklaidos pagrindinėje populiacijoje įvertis. Centrinis apibendrinimo klausimas yra, kada turėtume tikėtis, kad mūsų apmokymo paklaida bus artima populiacijos paklaidai (taigi ir apibendrinimo paklaidai).
3.6.1.1 Modelio sudėtingumas
Klasikinėje teorijoje, kai turime paprastus modelius ir gausybę duomenų, apmokymo ir apibendrinimo paklaidos paprastai būna artimos. Tačiau kai dirbame su sudėtingesniais modeliais ir (arba) mažiau pavyzdžių, tikimės, kad apmokymo paklaida sumažės, bet apibendrinimo atotrūkis padidės. Tai neturėtų stebinti. Įsivaizduokite modelių klasę, tokią raiškią, kad bet kuriam pavyzdžių duomenų rinkiniui galime rasti parametrų rinkinį, kuris gali tobulai pritaikyti savavališkus žymenis, net jei jie priskirti atsitiktinai. Tokiu atveju, net jei tobulai pritaikome savo apmokymo duomenis, kaip galime ką nors spręsti apie apibendrinimo paklaidą? Kiek mes žinome, mūsų apibendrinimo paklaida gali būti ne geresnė nei atsitiktinis spėliojimas.
Apskritai, neturint jokių apribojimų mūsų modelių klasei, negalime daryti išvados vien iš apmokymo duomenų pritaikymo, kad mūsų modelis atrado kokį nors apibendrinamą dėsningumą (Vapnik ir kt., 1994). Kita vertus, jei mūsų modelių klasė negalėjo pritaikyti savavališkų žymenų, tai jis turėjo atrasti dėsningumą. Mokymosi teorijos idėjos apie modelio sudėtingumą tam tikro įkvėpimo sėmėsi iš Karlo Popperio, įtakingo mokslo filosofo, idėjų, kuris formalizavo falsifikuojamumo kriterijų. Pasak Popperio, teorija, kuri gali paaiškinti bet kokius ir visus stebinius, iš viso nėra mokslinė teorija! Juk ką ji mums pasakė apie pasaulį, jei neatmetė jokios galimybės? Trumpai tariant, to, ko mes norime, yra hipotezė, kuri negalėtų paaiškinti jokių stebinių, kuriuos galime įsivaizduoti, ir vis dėlto pasitaiko, kad ji suderinama su tais stebiniais, kuriuos iš tikrųjų atliekame.
Kas tiksliai sudaro tinkamą modelio sudėtingumo sampratą, yra sudėtingas klausimas. Dažnai modeliai su daugiau parametrų gali pritaikyti didesnį skaičių savavališkai priskirtų žymenų. Tačiau tai nebūtinai tiesa. Pavyzdžiui, branduolių metodai veikia erdvėse su begaliniu parametrų skaičiumi, tačiau jų sudėtingumas valdomas kitais būdais (Scholkopf ir Smola, 2002). Viena sudėtingumo samprata, kuri dažnai pasirodo naudinga, yra reikšmių, kurias gali įgyti parametrai, diapazonas. Čia modelis, kurio parametrams leidžiama įgyti savavališkas reikšmes, būtų sudėtingesnis. Prie šios idėjos sugrįšime kitame skyrelyje, kai pristatysime svorių nykimą, jūsų pirmąjį praktinį reguliarizavimo metodą. Pažymėtina, kad gali būti sunku palyginti sudėtingumą tarp iš esmės skirtingų modelių klasių narių (tarkime, sprendimų medžių ir neuroninių tinklų).
Šioje vietoje turime pabrėžti dar vieną svarbų dalyką, prie kurio sugrįšime pristatydami gilius neuroninius tinklus. Kai modelis gali pritaikyti savavališkus žymenis, maža apmokymo paklaida nebūtinai reiškia mažą apibendrinimo paklaidą. Tačiau ji nebūtinai reiškia ir didelę apibendrinimo paklaidą! Vienintelis dalykas, kurį galime pasakyti užtikrintai, yra tas, kad vien maža apmokymo paklaida nepakanka mažai apibendrinimo paklaidai patvirtinti. Giliesiems neuroniniams tinklams būtent tokie modeliai ir yra: nors praktikoje jie gerai apibendrina, jie per galingi, kad galėtume daug ką spręsti vien pagal apmokymo paklaidą. Šiais atvejais turime labiau pasikliauti atskirtais duomenimis, kad patvirtintume apibendrinimą po fakto. Paklaida atskirtuose duomenyse, t. y. validavimo aibėje, vadinama validavimo paklaida.
3.6.2 Nepakankamas mokymasis ar persimokymas?
Lygindami apmokymo ir validavimo paklaidas, turime atkreipti dėmesį į dvi dažnas situacijas. Pirma, turime stebėti atvejus, kai ir apmokymo, ir validavimo paklaidos yra didelės, bet tarp jų yra nedidelis atotrūkis. Jei modelis negali sumažinti apmokymo paklaidos, tai gali reikšti, kad mūsų modelis yra per paprastas (t. y. nepakankamai raiškus), kad užfiksuotų dėsningumą, kurį bandome modeliuoti. Be to, kadangi apibendrinimo atotrūkis () tarp mūsų apmokymo ir apibendrinimo paklaidų yra mažas, turime pagrindo manyti, kad galėtume apsieiti su sudėtingesniu modeliu. Šis reiškinys žinomas kaip nepakankamas mokymasis (angl. underfitting).
Kita vertus, kaip aptarėme aukščiau, turime stebėti atvejus, kai mūsų apmokymo paklaida yra gerokai mažesnė nei validavimo paklaida, o tai rodo didelį persimokymą. Atkreipkite dėmesį, kad persimokymas ne visada yra blogas dalykas. Ypač giliajame mokyme geriausi prognozavimo modeliai dažnai veikia gerokai geriau apmokymo duomenyse nei atskirtuose duomenyse. Galiausiai paprastai mums rūpi sumažinti apibendrinimo paklaidą, o atotrūkis rūpi tik tiek, kiek jis tampa kliūtimi šiam tikslui. Atkreipkite dėmesį, kad jei apmokymo paklaida lygi nuliui, apibendrinimo atotrūkis tiksliai lygus apibendrinimo paklaidai, ir pažangos galime pasiekti tik mažindami atotrūkį.
3.6.2.1 Polinomo kreivės pritaikymas
Kad iliustruotume klasikinę intuiciją apie persimokymą ir modelio sudėtingumą, panagrinėkime tokį pavyzdį: turint apmokymo duomenis, sudarytus iš vieno požymio ir atitinkamo realiojo žymens , bandome rasti laipsnio polinomą
žymeniui įvertinti. Tai tiesiog tiesinės regresijos uždavinys, kuriame mūsų požymiai yra laipsniai, modelio svoriai yra , o poslinkis yra , nes visiems . Kadangi tai tiesiog tiesinės regresijos uždavinys, kaip nuostolių funkciją galime naudoti kvadratinę paklaidą.
Aukštesnės eilės polinominė funkcija yra sudėtingesnė nei žemesnės eilės polinominė funkcija, nes aukštesnės eilės polinomas turi daugiau parametrų ir modelio funkcijos pasirinkimo diapazonas platesnis. Fiksavus apmokymo duomenų rinkinį, aukštesnės eilės polinominės funkcijos visada turėtų pasiekti mažesnę (blogiausiu atveju lygią) apmokymo paklaidą, palyginti su žemesnio laipsnio polinomais. Tiesą sakant, kai kiekvienas duomenų pavyzdys turi skirtingą reikšmę, polinominė funkcija, kurios laipsnis lygus duomenų pavyzdžių skaičiui, gali tobulai pritaikyti apmokymo aibę. Polinomo laipsnio (modelio sudėtingumo) ryšį su nepakankamu mokymusi ir persimokymu palyginame 3.6.1 pav..
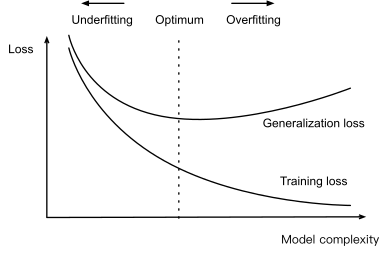
3.6.1 pav. Modelio sudėtingumo įtaka nepakankamam mokymuisi ir persimokymui.
3.6.2.2 Duomenų rinkinio dydis
Kaip jau rodo aukščiau pateikta riba, dar vienas svarbus aspektas, kurį reikia turėti galvoje, yra duomenų rinkinio dydis. Fiksavus savo modelį, kuo mažiau imčių turime apmokymo duomenų rinkinyje, tuo labiau tikėtina (ir tuo sunkesnis), kad susidursime su persimokymu. Didinant apmokymo duomenų kiekį, apibendrinimo paklaida paprastai mažėja. Be to, apskritai daugiau duomenų niekada nepakenkia. Fiksuotai užduočiai ir duomenų skirstiniui modelio sudėtingumas neturėtų didėti sparčiau nei duomenų kiekis. Turint daugiau duomenų, galime bandyti pritaikyti sudėtingesnį modelį. Nesant pakankamai duomenų, paprastesnių modelių gali būti sunkiau pranokti. Daugeliui užduočių giliasis mokymasis pranoksta tiesinius modelius tik tada, kai prieinama daug tūkstančių apmokymo pavyzdžių. Iš dalies dabartinė giliojo mokymosi sėkmė daug kuo yra skolinga didžiulių duomenų rinkinių gausai, atsiradusiai dėl interneto bendrovių, pigaus duomenų saugojimo, sujungtų įrenginių ir plačios ekonomikos skaitmenizacijos.
3.6.3 Modelio parinkimas
Paprastai galutinį modelį pasirenkame tik įvertinę kelis modelius, kurie skiriasi įvairiais aspektais (skirtingos architektūros, apmokymo tikslai, parinkti požymiai, duomenų išankstinis apdorojimas, mokymosi spartos ir t. t.). Pasirinkimas tarp daugelio modelių taikliai vadinamas modelio parinkimu.
Iš principo neturėtume liesti savo testavimo aibės, kol nepasirinksime visų savo hiperparametrų. Jei testavimo duomenis naudotume modelio parinkimo procese, kyla rizika, kad galime persimokyti testavimo duomenis. Tada turėtume rimtų problemų. Jei persimokome apmokymo duomenis, visada yra vertinimas testavimo duomenyse, kuris išlaiko mus sąžiningus. Bet jei persimokytume testavimo duomenis, kaip kada nors tai sužinotume? Pavyzdžio, kaip tai gali sukelti absurdiškus rezultatus net modeliams, kurių sudėtingumas gali būti griežtai kontroliuojamas, žr. (Ong ir kt., 2005).
Taigi niekada neturėtume remtis testavimo duomenimis modelio parinkimui. Ir vis dėlto negalime pasikliauti vien apmokymo duomenimis modelio parinkimui, nes negalime įvertinti apibendrinimo paklaidos tuose pačiuose duomenyse, kuriuos naudojame modeliui apmokyti.
Praktiniuose taikymuose vaizdas darosi miglotesnis. Nors idealiu atveju testavimo duomenų liestume tik vieną kartą, kad įvertintume pačią geriausią modelį arba palygintume nedidelį skaičių modelių tarpusavyje, realaus pasaulio testavimo duomenys retai išmetami po vieno panaudojimo. Retai galime sau leisti naują testavimo aibę kiekvienam eksperimentų ciklui. Tiesą sakant, dešimtmečius pakartotinai naudojami lyginamieji duomenys gali turėti didelį poveikį algoritmų kūrimui, pvz., vaizdų klasifikavimui ir optiniam simbolių atpažinimui.
Įprasta praktika sprendžiant apmokymo testavimo aibėje problemą yra skaidyti duomenis į tris dalis, be apmokymo ir testavimo duomenų rinkinių, įtraukiant validavimo aibę. Rezultatas yra miglotas reikalas, kuriame ribos tarp validavimo ir testavimo duomenų neramiai neaiškios. Jei aiškiai nenurodyta kitaip, šios knygos eksperimentuose iš tikrųjų dirbame su tuo, kas teisingai turėtų būti vadinama apmokymo duomenimis ir validavimo duomenimis, be tikrų testavimo aibių. Todėl kiekviename knygos eksperimente pateikiamas tikslumas iš tikrųjų yra validavimo tikslumas, o ne tikras testavimo aibės tikslumas.
3.6.3.1 Kryžminis validavimas
Kai apmokymo duomenų trūksta, galime net negalėti sau leisti atskirti pakankamai duomenų tinkamai validavimo aibei sudaryti. Vienas populiarus šios problemos sprendimas yra naudoti dalių kryžminį validavimą. Čia pradiniai apmokymo duomenys padalijami į nesikertančių poaibių. Tada modelio apmokymas ir validavimas vykdomi kartų, kiekvieną kartą apmokant su poaibiais ir validuojant su skirtingu poaibiu (tuo, kuris tame etape nebuvo naudojamas apmokymui). Galiausiai apmokymo ir validavimo paklaidos įvertinamos suvidurkinant eksperimentų rezultatus.
3.6.4 Santrauka
Šiame skyrelyje nagrinėjome kai kuriuos apibendrinimo mašininiame mokyme pagrindus. Kai kurios iš šių idėjų tampa sudėtingos ir prieštaraujančios intuicijai, kai pereiname prie gilesnių modelių; čia modeliai gali smarkiai persimokyti duomenis, o susijusios sudėtingumo sampratos gali būti ir neišreikštos, ir prieštaraujančios intuicijai (pvz., didesnės architektūros su daugiau parametrų geriau apibendrina). Paliekame jums kelias praktines taisykles:
- Modelio parinkimui naudokite validavimo aibes (arba dalių kryžminį validavimą);
- Sudėtingesniems modeliams dažnai reikia daugiau duomenų;
- Svarbios sudėtingumo sampratos apima ir parametrų skaičių, ir reikšmių, kurias jiems leidžiama įgyti, diapazoną;
- Visiems kitiems dalykams esant vienodiems, daugiau duomenų beveik visada veda prie geresnio apibendrinimo;
- Visas šis pokalbis apie apibendrinimą grindžiamas IID prielaida. Jei atsisakome šios prielaidos, leisdami skirstiniams pasikeisti tarp apmokymo ir testavimo laikotarpių, tada negalime nieko pasakyti apie apibendrinimą be tolesnės (galbūt švelnesnės) prielaidos.
3.6.5 Pratimai
- Kada galite tiksliai išspręsti polinominės regresijos uždavinį?
- Pateikite bent penkis pavyzdžius, kai priklausomi atsitiktiniai dydžiai daro netinkamą nagrinėti uždavinį kaip IID duomenis.
- Ar kada nors galite tikėtis matyti nulinę apmokymo paklaidą? Kokiomis aplinkybėmis pamatytumėte nulinę apibendrinimo paklaidą?
- Kodėl dalių kryžminį validavimą labai brangu apskaičiuoti?
- Kodėl dalių kryžminio validavimo paklaidos įvertis yra paslinktas?
- VC dimensija apibrėžiama kaip didžiausias taškų skaičius, kuriuos funkcijų klasės funkcija gali klasifikuoti su savavališkais žymenimis . Kodėl tai gali nebūti gera mintis matuojant, kiek sudėtinga funkcijų klasė? Užuomina: apsvarstykite funkcijų didumą.
- Jūsų vadovas duoda jums sunkų duomenų rinkinį, kuriame jūsų dabartinis algoritmas veikia nelabai gerai. Kaip jam pagrįstumėte, kad jums reikia daugiau duomenų? Užuomina: duomenų padidinti negalite, bet galite sumažinti.