
17.1 Markovo sprendimų procesas (MDP)
Šiame skyrelyje aptarsime, kaip formuluoti skatinamojo mokymosi uždavinius naudojant Markovo sprendimų procesus (MDP), ir išsamiai apibūdinsime įvairius MDP komponentus.
17.1.1 MDP apibrėžimas
Markovo sprendimų procesas (MDP) (Richard Bellman, 1957) yra modelis, aprašantis, kaip sistemos būsena kinta, kai sistemai taikomi skirtingi veiksmai. MDP sudaro keli skirtingi dydžiai.
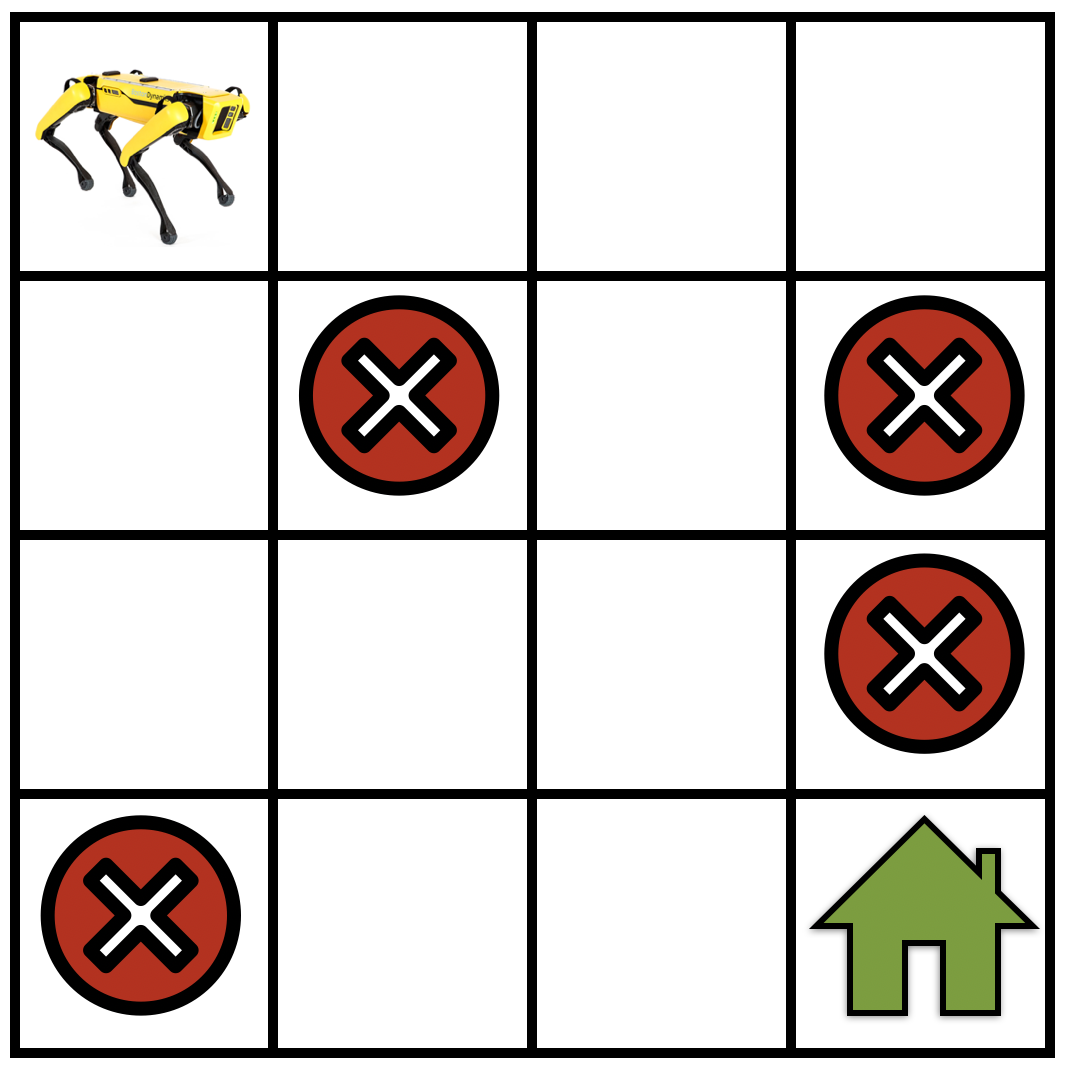
17.1.1 pav. Paprastas tinklelio pasaulio navigacijos uždavinys, kuriame robotas turi ne tik rasti kelią į tikslo vietą (parodyta kaip žalias namas), bet ir vengti spąstų vietų (parodyta kaip raudoni kryžiai).
- Tegu yra MDP būsenų aibė. Konkretų pavyzdį žr. 17.1.1 pav., kuriame robotas naviguoja tinklelio pasaulyje. Šiuo atveju atitinka vietų, kuriose robotas gali būti bet kuriuo laiko žingsniu, aibę.
- Tegu yra veiksmų, kuriuos robotas gali atlikti kiekvienoje būsenoje, aibė, pvz., „eiti pirmyn“, „sukti į dešinę“, „sukti į kairę“, „likti toje pačioje vietoje“ ir pan. Veiksmai gali pakeisti dabartinę roboto būseną į kitą aibės būseną.
- Gali būti, kad nežinome, kaip robotas juda tiksliai, o žinome tai tik apytiksliai. Skatinamajame mokyme šią situaciją modeliuojame taip: jei robotas atlieka veiksmą „eiti pirmyn“, gali būti nedidelė tikimybė, kad jis liks dabartinėje būsenoje, kita nedidelė tikimybė, kad jis „pasuks į kairę“, ir pan. Matematiškai tai reiškia „perėjimo funkcijos“ apibrėžimą taip, kad , naudojant sąlyginę tikimybę pasiekti būseną , kai robotas buvo būsenoje ir atliko veiksmą . Perėjimo funkcija yra tikimybių skirstinys, todėl visiems ir turime , t. y. robotas, atlikęs veiksmą, turi patekti į kokią nors būseną.
- Dabar sukonstruojame supratimą, kurie veiksmai yra naudingi, o kurie ne, naudodami „atlygio“ sąvoką . Sakome, kad robotas gauna atlygį , jei robotas būsenoje atlieka veiksmą . Jei atlygis didelis, tai rodo, kad veiksmas būsenoje yra naudingesnis roboto tikslui pasiekti, t. y. nueiti iki žaliojo namo. Jei atlygis mažas, tada veiksmas yra mažiau naudingas šiam tikslui pasiekti. Svarbu pažymėti, kad atlygį, atsižvelgdamas į tikslą, suprojektuoja naudotojas (asmuo, kuris kuria skatinamojo mokymosi algoritmą).
17.1.2 Grąža ir diskonto koeficientas
Aukščiau aprašyti komponentai kartu sudaro Markovo sprendimų procesą (MDP)
Dabar panagrinėkime situaciją, kai robotas pradeda nuo tam tikros būsenos ir toliau atlieka veiksmus, taip sudarydamas trajektoriją
Kiekvienu laiko žingsniu robotas yra būsenoje ir atlieka veiksmą , kuris lemia atlygį . Trajektorijos grąža yra bendras atlygis, kurį robotas gauna išilgai tokios trajektorijos
Skatinamojo mokymosi tikslas yra rasti trajektoriją, kurios grąža didžiausia.
Pagalvokite apie situaciją, kai robotas toliau keliauja tinklelio pasaulyje niekada nepasiekdamas tikslo vietos. Būsenų ir veiksmų seka trajektorijoje šiuo atveju gali būti be galo ilga, o bet kurios tokios be galo ilgos trajektorijos grąža bus begalinė. Kad skatinamojo mokymosi formuluotė išliktų prasminga net tokioms trajektorijoms, įvedame diskonto koeficiento sąvoką. Diskontuotą grąžą užrašome kaip
Atkreipkite dėmesį, kad jei labai mažas, atlygiai, kuriuos robotas gauna tolimoje ateityje, tarkime, kai , yra stipriai diskontuojami koeficientu . Tai skatina robotą rinktis trumpas trajektorijas, kuriomis pasiekiamas jo tikslas, būtent nueiti iki žaliojo namo tinklelio pasaulio pavyzdyje (žr. 17.1.1 pav.). Esant didelėms diskonto koeficiento reikšmėms, tarkime, , robotas skatinamas tyrinėti ir tada rasti geriausią trajektoriją į tikslo vietą.
17.1.3 Markovo prielaidos aptarimas
Pagalvokime apie naują robotą, kurio būsena yra vieta kaip aukščiau, bet veiksmas yra pagreitis, kurį robotas pritaiko savo ratams, o ne abstrakti komanda, pavyzdžiui, „eiti pirmyn“. Jei šis robotas būsenoje turi tam tikrą nenulinį greitį, tada kita vieta yra praėjusios vietos , pagreičio ir roboto greičio laiko momentu , kuris proporcingas , funkcija. Tai rodo, kad turėtume turėti
„tam tikra funkcija“ mūsų atveju būtų Niutono judėjimo dėsnis. Tai gana skiriasi nuo mūsų perėjimo funkcijos, kuri priklauso tik nuo ir .
Markovo sistemos yra visos sistemos, kuriose kita būsena yra tik dabartinės būsenos ir dabartinėje būsenoje atlikto veiksmo funkcija. Markovo sistemose kita būsena nepriklauso nuo to, kokie veiksmai buvo atlikti praeityje ar kokiose būsenose robotas buvo praeityje. Pavyzdžiui, naujasis robotas, kurio veiksmas yra pagreitis, nėra Markovo, nes kita vieta priklauso nuo ankstesnės būsenos per greitį. Gali atrodyti, kad sistemos Markovo prigimtis yra ribojanti prielaida, bet taip nėra. Markovo sprendimų procesai vis tiek geba modeliuoti labai didelę realių sistemų klasę. Pavyzdžiui, mūsų naujam robotui, jei savo būseną pasirinktume kaip kortežą , tada sistema yra Markovo, nes jos kita būsena priklauso tik nuo dabartinės būsenos ir dabartinėje būsenoje atlikto veiksmo .
17.1.4 Santrauka
Skatinamojo mokymosi uždavinys paprastai modeliuojamas naudojant Markovo sprendimų procesus. Markovo sprendimų procesas (MDP) apibrėžiamas keturių elementų kortežu , kur yra būsenų erdvė, yra veiksmų erdvė, yra perėjimo funkcija, koduojanti MDP perėjimo tikimybes, o yra betarpiškas atlygis, gaunamas atlikus veiksmą tam tikroje būsenoje.
17.1.5 Pratimai
- Tarkime, norime sukurti MDP MountainCar uždaviniui modeliuoti.
- Kokia būtų būsenų aibė?
- Kokia būtų veiksmų aibė?
- Kokios galėtų būti atlygio funkcijos?
- Kaip suprojektuotumėte MDP Atari žaidimui, pavyzdžiui, Pong žaidimui?