
8.8 Konvoliucinių tinklų architektūrų projektavimas
Ankstesni skyreliai mus supažindino su šiuolaikiniu tinklų dizainu kompiuterinei regai. Visų aptartų darbų bendras bruožas buvo tas, kad jie labai rėmėsi mokslininkų intuicija. Daugelį architektūrų stipriai lėmė žmogaus kūrybiškumas ir daug mažiau – sistemingas dizaino erdvės, kurią siūlo gilieji tinklai, tyrinėjimas. Vis dėlto šis tinklų inžinerijos požiūris buvo nepaprastai sėkmingas.
Nuo tada, kai AlexNet (8.1 skyrelis) įveikė įprastus kompiuterinės regos modelius su ImageNet, tapo populiaru kurti labai gilius tinklus, kraunant konvoliucijų blokus, visus suprojektuotus pagal tą patį šabloną. Visų pirma konvoliucijas išpopuliarino VGG tinklai (8.2 skyrelis). NiN (8.3 skyrelis) parodė, kad net konvoliucijos gali būti naudingos pridedant lokalius netiesiškumus. Be to, NiN išsprendė informacijos agregavimo tinklo galvoje problemą, agreguodamas per visas vietas. GoogLeNet (8.4 skyrelis) pridėjo kelias skirtingo konvoliucijų pločio šakas, savo Inception bloke sujungdamas VGG ir NiN privalumus. ResNet (8.6 skyrelis) pakeitė induktyvinį šališkumą link tapatybės atvaizdavimo (nuo ). Tai leido kurti labai gilius tinklus. Praėjus beveik dešimtmečiui, ResNet dizainas vis dar populiarus, o tai liudija apie jo kokybę. Galiausiai ResNeXt (8.6.5 skyrelis) pridėjo grupines konvoliucijas, pasiūlydamas geresnį kompromisą tarp parametrų ir skaičiavimų. Transformerių regai pirmtakai – suspaudimo ir sužadinimo tinklai (angl. Squeeze-and-Excitation Networks, SENet) – leidžia efektyviai perduoti informaciją tarp vietų (Hu ir kt., 2018). Tai pasiekta apskaičiuojant globalią dėmesio funkciją kiekvienam kanalui.
Iki šiol praleidome tinklus, gautus per neuroninių architektūrų paiešką (angl. neural architecture search, NAS) (Zoph ir Le, 2016; Liu ir kt., 2018). Taip pasirinkome todėl, kad jų kaina paprastai milžiniška, nes jie remiasi brutalios jėgos paieška, genetiniais algoritmais, skatinamuoju mokymusi ar kita hiperparametrų optimizavimo forma. Turint fiksuotą paieškos erdvę, NAS naudoja paieškos strategiją, kad automatiškai parinktų architektūrą pagal grąžinamą našumo įvertį. NAS rezultatas yra vienas tinklo egzempliorius. EfficientNet yra žymus šios paieškos rezultatas (Tan ir Le, 2019).
Toliau aptariame idėją, gana skirtingą nuo vienintelio geriausio tinklo paieškos. Ji skaičiavimo požiūriu santykinai pigi, pakeliui duoda mokslinių įžvalgų ir yra gana veiksminga rezultatų kokybės požiūriu. Apžvelkime (Radosavovic ir kt., 2020) strategiją projektuoti tinklo dizaino erdves. Strategija sujungia rankinio dizaino ir NAS stiprybes. Tai pasiekiama veikiant su tinklų skirstiniais ir optimizuojant skirstinius taip, kad būtų gautas geras visų tinklų šeimų našumas. Rezultatas yra RegNet tinklai, konkrečiai RegNetX ir RegNetY, plius kelių vadovaujančių principų rinkinys našių CNN projektavimui.
from d2l import mxnet as d2l
from mxnet import np, npx, init
from mxnet.gluon import nn

npx.set_np()
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F
import tensorflow as tf
from d2l import tensorflow as d2l
from d2l import jax as d2l
from flax import linen as nn
8.8.1 AnyNet dizaino erdvė
Toliau pateiktas aprašymas glaudžiai seka (Radosavovic ir kt., 2020) samprotavimą su kai kuriais sutrumpinimais, kad tilptų į knygos apimtį. Pradėkime nuo to, kad mums reikia šablono tyrinėjamai tinklų šeimai. Vienas iš šiame skyriuje aprašytų dizainų bendrų bruožų yra tas, kad tinklus sudaro pradžios dalis, korpusas ir galva. Pradžios dalis atlieka pradinį vaizdo apdorojimą, dažnai per konvoliucijas su didesniu lango dydžiu. Korpusą sudaro keli blokai, atliekantys didžiąją dalį transformacijų, reikalingų norint iš neapdorotų vaizdų gauti objektų atvaizdus. Galiausiai galva paverčia tai norimomis išvestimis, pavyzdžiui, per softmax regresorių daugiaklasei klasifikacijai. Savo ruožtu korpusą sudaro keli etapai, veikiantys vaizdą mažėjančia skyra. Iš tikrųjų ir pradžios dalis, ir kiekvienas paskesnis etapas ketvirtadaliu sumažina erdvinę skyrą. Galiausiai kiekvieną etapą sudaro vienas ar daugiau blokų. Šis šablonas bendras visiems tinklams, nuo VGG iki ResNeXt. Iš tikrųjų bendrų AnyNet tinklų dizainui (Radosavovic ir kt., 2020) naudojo ResNeXt bloką iš 8.6.5 pav..
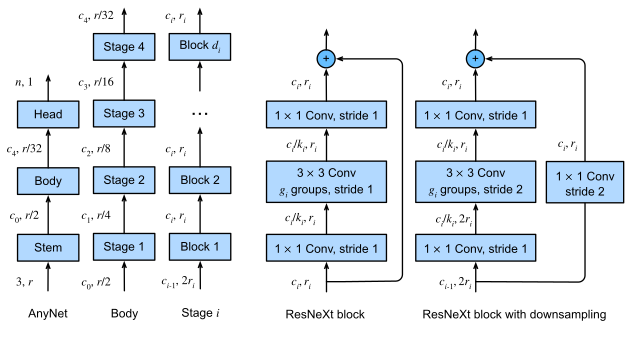
8.8.1 pav. AnyNet dizaino erdvė. Skaičiai prie kiekvienos rodyklės nurodo kanalų skaičių ir vaizdų skyrą tame taške. Iš kairės į dešinę: bendra tinklo struktūra, sudaryta iš pradžios dalies, korpuso ir galvos; korpusas, sudarytas iš keturių etapų; detali etapo struktūra; dvi alternatyvios blokų struktūros – viena be diskretizavimo dažnio mažinimo, kita perpus sumažinanti skyrą kiekvienoje dimensijoje. Dizaino pasirinkimai apima gylį , išvesties kanalų skaičių , grupių skaičių ir butelio kakliuko santykį bet kuriam etapui .
Išsamiai apžvelkime 8.8.1 pav. pateiktą struktūrą. Kaip minėta, AnyNet sudaro pradžios dalis, korpusas ir galva. Pradžios dalis kaip įvestį priima RGB vaizdus (3 kanalai), naudoja konvoliuciją su žingsniu , po kurios eina rinkinio normalizacija, kad perpus sumažintų skyrą iš į . Be to, ji generuoja kanalų, kurie tarnauja kaip korpuso įvestis.
Kadangi tinklas suprojektuotas gerai veikti su formos ImageNet vaizdais, korpusas tai sumažina iki per 4 etapus (prisiminkite, kad ), kurių kiekvienas turi galutinį žingsnį . Galiausiai galva naudoja visiškai standartinį dizainą su globaliu sutelkimu vidurkinant, panašiai kaip NiN (8.3 skyrelis), po kurio eina pilnai sujungtas sluoksnis dimensijų vektoriui išvesti klasių klasifikacijai.
Dauguma svarbių dizaino sprendimų yra būdingi tinklo korpusui. Jis veikia etapais, kur kiekvieną etapą sudaro to paties tipo ResNeXt blokai, kaip aptarėme 8.6.5 skyrelis. Dizainas ten vėl visiškai bendras: pradedame nuo bloko, kuris perpus sumažina skyrą naudodamas žingsnį (dešiniausias 8.8.1 pav.). Kad tai atitiktų, ResNeXt bloko liekamoji šaka turi praeiti per konvoliuciją. Po šio bloko eina kintamas skaičius papildomų ResNeXt blokų, nekeičiančių nei skyros, nei kanalų skaičiaus. Atkreipkite dėmesį, kad įprasta dizaino praktika yra pridėti nedidelį butelio kakliuką konvoliucinių blokų dizaine. Taigi su butelio kakliuko santykiu leidžiame sau tam tikrą kanalų skaičių, , kiekviename -ojo etapo bloke (kaip rodo eksperimentai, tai nelabai veiksminga ir to reikėtų atsisakyti). Galiausiai, kadangi turime reikalų su ResNeXt blokais, taip pat turime pasirinkti grupių skaičių grupinėms konvoliucijoms -ajame etape.
Ši iš pažiūros bendra dizaino erdvė vis dėlto suteikia mums daug parametrų: galime nustatyti bloko plotį (kanalų skaičių) , gylį (blokų skaičių) kiekviename etape , butelio kakliuko santykius ir grupių pločius (grupių skaičius) . Iš viso tai sudaro 17 parametrų, todėl gaunamas nepagrįstai didelis konfigūracijų, kurias būtų verta tyrinėti, skaičius. Mums reikia įrankių, kad veiksmingai sumažintume šią milžinišką dizaino erdvę. Čia ir atsiskleidžia konceptualus dizaino erdvių grožis. Prieš tai darydami, pirmiausia įgyvendinkime bendrą dizainą.
class AnyNet(d2l.Classifier):
    def stem(self, num_channels):
        net = nn.Sequential()
        net.add(nn.Conv2D(num_channels, kernel_size=3, padding=1, strides=2),
                nn.BatchNorm(), nn.Activation('relu'))
        return net
class AnyNet(d2l.Classifier):
    def stem(self, num_channels):
        return nn.Sequential(
            nn.LazyConv2d(num_channels, kernel_size=3, stride=2, padding=1),
            nn.LazyBatchNorm2d(), nn.ReLU())
class AnyNet(d2l.Classifier):
    def stem(self, num_channels):
        return tf.keras.models.Sequential([
            tf.keras.layers.Conv2D(num_channels, kernel_size=3, strides=2,
                                   padding='same'),
            tf.keras.layers.BatchNormalization(),
            tf.keras.layers.Activation('relu')])
class AnyNet(d2l.Classifier):
    arch: tuple
    stem_channels: int
    lr: float = 0.1
    num_classes: int = 10
    training: bool = True

    def setup(self):
        self.net = self.create_net()

    def stem(self, num_channels):
        return nn.Sequential([
            nn.Conv(num_channels, kernel_size=(3, 3), strides=(2, 2),
                    padding=(1, 1)),
            nn.BatchNorm(not self.training),
            nn.relu
        ])
Kiekvieną etapą sudaro depth ResNeXt blokų,
kur num_channels nurodo bloko plotį.
Atkreipkite dėmesį, kad pirmasis blokas perpus sumažina įvesties vaizdų aukštį ir plotį.
@d2l.add_to_class(AnyNet)
def stage(self, depth, num_channels, groups, bot_mul):
    net = nn.Sequential()
    for i in range(depth):
        if i == 0:
            net.add(d2l.ResNeXtBlock(
                num_channels, groups, bot_mul, use_1x1conv=True, strides=2))
        else:
            net.add(d2l.ResNeXtBlock(
                num_channels, num_channels, groups, bot_mul))
    return net
@d2l.add_to_class(AnyNet)
def stage(self, depth, num_channels, groups, bot_mul):
    blk = []
    for i in range(depth):
        if i == 0:
            blk.append(d2l.ResNeXtBlock(num_channels, groups, bot_mul,
                use_1x1conv=True, strides=2))
        else:
            blk.append(d2l.ResNeXtBlock(num_channels, groups, bot_mul))
    return nn.Sequential(*blk)
@d2l.add_to_class(AnyNet)
def stage(self, depth, num_channels, groups, bot_mul):
    net = tf.keras.models.Sequential()
    for i in range(depth):
        if i == 0:
            net.add(d2l.ResNeXtBlock(num_channels, groups, bot_mul,
                use_1x1conv=True, strides=2))
        else:
            net.add(d2l.ResNeXtBlock(num_channels, groups, bot_mul))
    return net
@d2l.add_to_class(AnyNet)
def stage(self, depth, num_channels, groups, bot_mul):
    blk = []
    for i in range(depth):
        if i == 0:
            blk.append(d2l.ResNeXtBlock(num_channels, groups, bot_mul,
                use_1x1conv=True, strides=(2, 2), training=self.training))
        else:
            blk.append(d2l.ResNeXtBlock(num_channels, groups, bot_mul,
                                        training=self.training))
    return nn.Sequential(blk)
Sujungę tinklo pradžios dalį, korpusą ir galvą, užbaigiame AnyNet įgyvendinimą.
@d2l.add_to_class(AnyNet)
def __init__(self, arch, stem_channels, lr=0.1, num_classes=10):
    super(AnyNet, self).__init__()
    self.save_hyperparameters()
    if tab.selected('mxnet'):
        self.net = nn.Sequential()
        self.net.add(self.stem(stem_channels))
        for i, s in enumerate(arch):
            self.net.add(self.stage(*s))
        self.net.add(nn.GlobalAvgPool2D(), nn.Dense(num_classes))
        self.net.initialize(init.Xavier())
    if tab.selected('pytorch'):
        self.net = nn.Sequential(self.stem(stem_channels))
        for i, s in enumerate(arch):
            self.net.add_module(f'stage{i+1}', self.stage(*s))
        self.net.add_module('head', nn.Sequential(
            nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(),
            nn.LazyLinear(num_classes)))
        self.net.apply(d2l.init_cnn)
    if tab.selected('tensorflow'):
        self.net = tf.keras.models.Sequential(self.stem(stem_channels))
        for i, s in enumerate(arch):
            self.net.add(self.stage(*s))
        self.net.add(tf.keras.models.Sequential([
            tf.keras.layers.GlobalAvgPool2D(),
            tf.keras.layers.Dense(units=num_classes)]))
@d2l.add_to_class(AnyNet)
def create_net(self):
    net = nn.Sequential([self.stem(self.stem_channels)])
    for i, s in enumerate(self.arch):
        net.layers.extend([self.stage(*s)])
    net.layers.extend([nn.Sequential([
        lambda x: nn.avg_pool(x, window_shape=x.shape[1:3],
                            strides=x.shape[1:3], padding='valid'),
        lambda x: x.reshape((x.shape[0], -1)),
        nn.Dense(self.num_classes)])])
    return net
8.8.2 Dizaino erdvių skirstiniai ir parametrai
Kaip ką tik aptarta 8.8.1 skyrelis, dizaino erdvės parametrai yra tos dizaino erdvės tinklų hiperparametrai. Panagrinėkime gerų parametrų nustatymo AnyNet dizaino erdvėje problemą. Galėtume bandyti rasti vienintelį geriausią parametrų pasirinkimą duotam skaičiavimų kiekiui (pvz., FLOPs ir skaičiavimo laikui). Jei leistume net tik dvi galimas kiekvieno parametro reikšmes, turėtume ištirti derinių, kad rastume geriausią sprendinį. Tai akivaizdžiai neįmanoma dėl pernelyg didelės kainos. Dar blogiau, iš šio pratimo iš tikrųjų nieko neišmokstame apie tai, kaip reikėtų projektuoti tinklą. Kitą kartą pridėję, tarkime, X etapą, postūmio operaciją ar panašiai, turėtume pradėti iš naujo. Dar blogiau, dėl apmokymo stochastiškumo (apvalinimo, maišymo, bitų klaidų) du paleidimai vargu ar duos visiškai tuos pačius rezultatus. Geresnė strategija būtų bandyti nustatyti bendras gaires, kaip turėtų būti susiję parametrų pasirinkimai. Pavyzdžiui, butelio kakliuko santykį, kanalų, blokų, grupių skaičių ar jų kitimą tarp sluoksnių idealiai turėtų valdyti paprastų taisyklių rinkinys. (Radosavovic ir kt., 2019) požiūris remiasi šiomis keturiomis prielaidomis:
- Darome prielaidą, kad bendri dizaino principai iš tikrųjų egzistuoja, todėl daug šiuos reikalavimus tenkinančių tinklų turėtų siūlyti gerą našumą. Todėl skirstinio per tinklus nustatymas gali būti pagrįsta strategija. Kitaip tariant, darome prielaidą, kad šieno kupetoje yra daug gerų adatų.
- Nereikia apmokyti tinklų iki konvergavimo, kad galėtume įvertinti, ar tinklas geras. Vietoj to pakanka naudoti tarpinius rezultatus kaip patikimą gaires galutiniam tikslumui. Naudojimas (apytikslių) pakaitinių dydžių tikslui optimizuoti vadinamas daugiatikslumo optimizavimu (Forrester ir kt., 2007). Todėl dizaino optimizavimas atliekamas pagal tikslumą, pasiektą po vos kelių perėjimų per duomenų rinkinį, taip gerokai sumažinant kainą.
- Rezultatai, gauti mažesniu mastu (mažesniems tinklams), apibendrinami didesniems. Todėl optimizavimas atliekamas struktūriškai panašiems tinklams, bet su mažesniu blokų, mažiau kanalų ir pan. Tik pabaigoje reikės patikrinti, ar taip rasti tinklai taip pat siūlo gerą našumą dideliu mastu.
- Dizaino aspektus galima apytiksliai išskaidyti, todėl galima gana nepriklausomai nustatyti jų poveikį rezultato kokybei. Kitaip tariant, optimizavimo uždavinys yra vidutiniškai lengvas.
Šios prielaidos leidžia pigiai išbandyti daug tinklų. Visų pirma galime imti imtį tolygiai iš konfigūracijų erdvės ir įvertinti jų našumą. Vėliau galime įvertinti parametrų pasirinkimo kokybę, apžvelgdami paklaidos / tikslumo, kurį galima pasiekti su minėtais tinklais, skirstinį. Pažymėkime kaupiamąją skirstinio funkciją (KSF) paklaidoms, kurias daro tam tikros dizaino erdvės tinklai, ištraukti naudojant tikimybių skirstinį . Tai yra,
Dabar mūsų tikslas yra rasti tinklų skirstinį , kad dauguma tinklų turėtų labai mažą paklaidos lygį ir kad atrama būtų glausta. Žinoma, to tiksliai atlikti skaičiavimo požiūriu neįmanoma. Griebiamės tinklų imties (atitinkamai su paklaidomis ) iš ir vietoj to naudojame empirinę KSF :
Kai vieno pasirinkimų rinkinio KSF majoruoja (arba sutampa su) kitą KSF, iš to išplaukia, kad jo parametrų pasirinkimas yra geresnis (arba abejingas). Atitinkamai (Radosavovic ir kt., 2020) eksperimentavo su bendru tinklo butelio kakliuko santykiu visiems tinklo etapams . Taip atsikratoma trijų iš keturių butelio kakliuko santykį valdančių parametrų. Kad įvertintume, ar tai (neigiamai) veikia našumą, galima ištraukti tinklus iš apribotojo ir iš neapribotojo skirstinio ir palyginti atitinkamas KSF. Paaiškėja, kad šis apribojimas visai nepaveikia tinklų skirstinio tikslumo, kaip matyti pirmajame 8.8.2 pav. skydelyje. Panašiai galėtume pasirinkti tą patį grupės plotį įvairiuose tinklo etapuose. Vėlgi tai neįtakoja našumo, kaip matyti antrajame 8.8.2 pav. skydelyje. Abu žingsniai kartu sumažina laisvųjų parametrų skaičių šešiais.
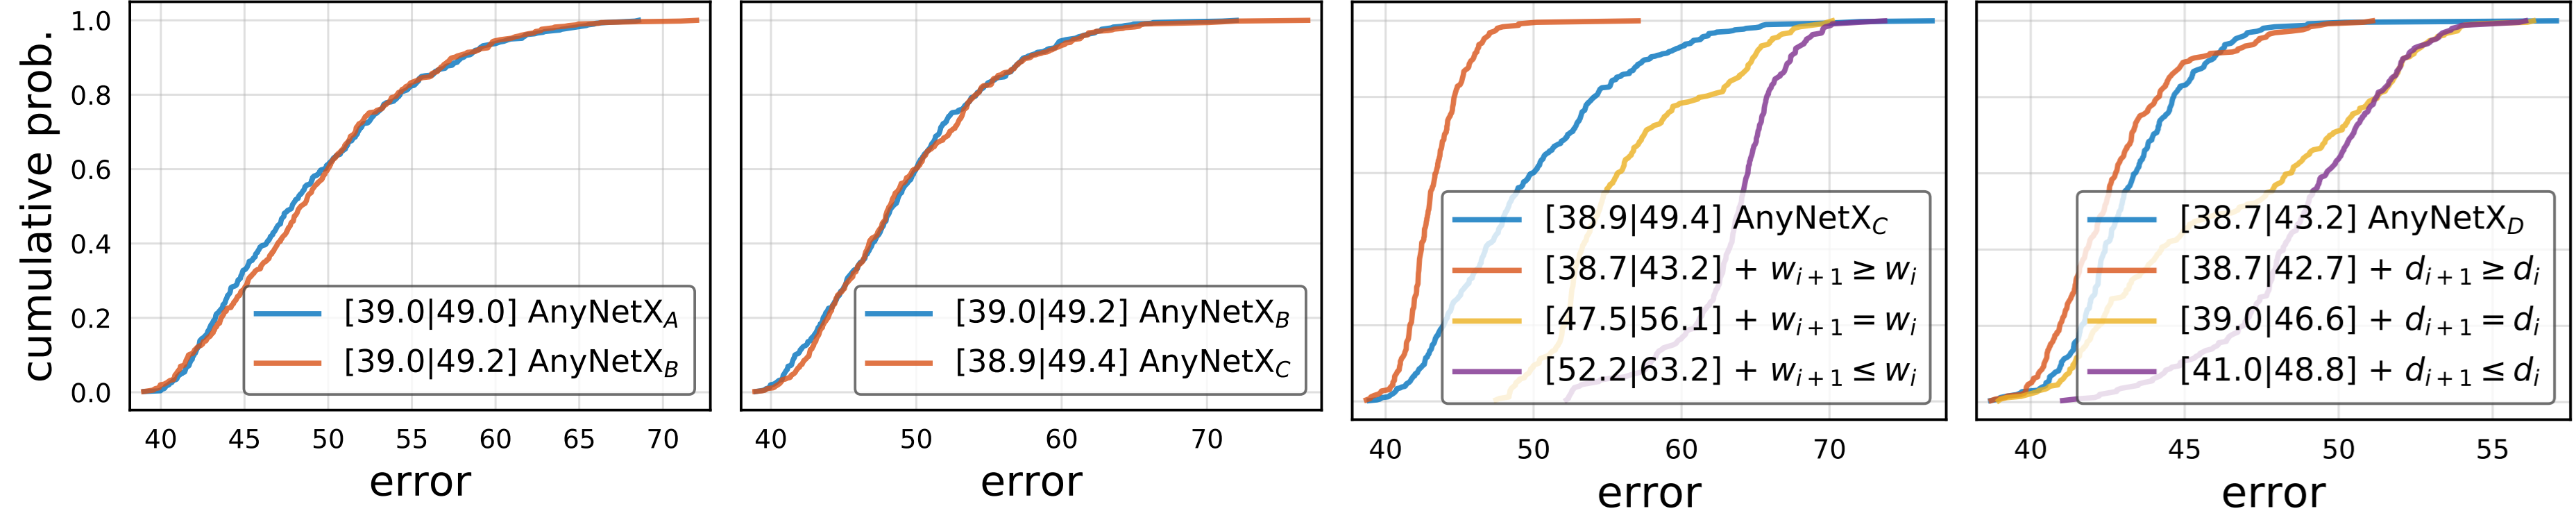
8.8.2 pav. Dizaino erdvių paklaidų empirinių skirstinio funkcijų palyginimas. yra originali dizaino erdvė; susieja butelio kakliuko santykius, taip pat susieja grupių plotį, didina tinklo gylį per etapus. Iš kairės į dešinę: (i) butelio kakliuko santykių susiejimas neturi poveikio našumui; (ii) grupių pločių susiejimas neturi poveikio našumui; (iii) tinklo pločių (kanalų) didinimas per etapus pagerina našumą; (iv) tinklo gylių didinimas per etapus pagerina našumą. Paveikslas atkurtas (Radosavovic ir kt., 2020) leidimu.
Toliau ieškome būdų sumažinti galimų etapų pločio ir gylio pasirinkimų daugybę. Pagrįsta prielaida, kad gilėjant kanalų skaičius turėtų didėti, t. y. ( pagal jų žymėjimą 8.8.2 pav.), gaunant . Panašiai lygiai taip pat pagrįsta manyti, kad etapams progresuojant jie turėtų gilėti, t. y. , gaunant . Tai galima eksperimentiškai patikrinti atitinkamai trečiajame ir ketvirtajame 8.8.2 pav. skydeliuose.
8.8.3 RegNet
Gauta dizaino erdvė susideda iš paprastų tinklų, besilaikančių lengvai interpretuojamų dizaino principų:
- Bendras butelio kakliuko santykis visiems etapams ;
- Bendras grupės plotis visiems etapams ;
- Didinamas tinklo plotis per etapus: ;
- Didinamas tinklo gylis per etapus: .
Taip lieka paskutinis pasirinkimų rinkinys: kaip parinkti konkrečias aukščiau minėtų galutinės dizaino erdvės parametrų reikšmes. Tyrinėjant geriausiai veikiančius tinklus iš skirstinio, galima pastebėti: tinklo plotis idealiai didėja tiesiškai su bloko indeksu per tinklą, t. y. , kur yra bloko indeksas, o nuolydis . Kadangi skirtingą bloko plotį galime rinktis tik kiekvienam etapui, gauname dalimis pastovią funkciją, sukonstruotą taip, kad atitiktų šią priklausomybę. Be to, eksperimentai taip pat rodo, kad butelio kakliuko santykis veikia geriausiai, t. y. patariama butelio kakliukų išvis nenaudoti.
Rekomenduojame norintiems skaitytojams susipažinti su tolesnėmis detalėmis, kaip projektuojami konkretūs tinklai skirtingiems skaičiavimų kiekiams, perskaitant (Radosavovic ir kt., 2020). Pavyzdžiui, veiksmingą 32 sluoksnių RegNetX variantą nusako (be butelio kakliuko), (grupės plotis yra 16), ir kanalų atitinkamai pirmajam ir antrajam etapui, parinkti ir blokų gylio. Nuostabi dizaino įžvalga yra ta, kad ji vis dar galioja net tiriant didesnio masto tinklus. Dar geriau, ji galioja net suspaudimo ir sužadinimo (SE) tinklų dizainams (RegNetY), turintiems globalią kanalų aktyvaciją (Hu ir kt., 2018).
class RegNetX32(AnyNet):
    def __init__(self, lr=0.1, num_classes=10):
        stem_channels, groups, bot_mul = 32, 16, 1
        depths, channels = (4, 6), (32, 80)
        super().__init__(
            ((depths[0], channels[0], groups, bot_mul),
             (depths[1], channels[1], groups, bot_mul)),
            stem_channels, lr, num_classes)
class RegNetX32(AnyNet):
    lr: float = 0.1
    num_classes: int = 10
    stem_channels: int = 32
    arch: tuple = ((4, 32, 16, 1), (6, 80, 16, 1))
Matome, kad kiekvienas RegNetX etapas palaipsniui mažina skyrą ir didina išvesties kanalus.
RegNetX32().layer_summary((1, 1, 96, 96))
RegNetX32().layer_summary((1, 96, 96, 1))
RegNetX32(training=False).layer_summary((1, 96, 96, 1))
8.8.4 Mokymas
32 sluoksnių RegNetX apmokymas su Fashion-MNIST duomenų rinkiniu vyksta kaip ir anksčiau.
model = RegNetX32(lr=0.05)
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128, resize=(96, 96))
trainer.fit(model, data)
trainer = d2l.Trainer(max_epochs=10)
data = d2l.FashionMNIST(batch_size=128, resize=(96, 96))
with d2l.try_gpu():
    model = RegNetX32(lr=0.01)
    trainer.fit(model, data)
8.8.5 Diskusija
Turėdami pageidaujamus induktyvinius šališkumus (prielaidas ar pirmenybes), tokius kaip lokalumas ir postūmio invariantiškumas (7.1 skyrelis), regai CNN buvo dominuojančios architektūros šioje srityje. Taip buvo nuo LeNet iki tol, kol transformeriai (11.7 skyrelis) (Dosovitskiy ir kt., 2021; Touvron ir kt., 2021) pradėjo pranokti CNN tikslumo požiūriu. Nors didelę dalį naujausios pažangos regos transformeriuose galima perkelti atgal į CNN (Liu ir kt., 2022), tai įmanoma tik didesne skaičiavimo kaina. Ne mažiau svarbu, kad naujausios aparatinės įrangos optimizacijos (NVIDIA Ampere ir Hopper) tik padidino skirtumą transformerių naudai.
Verta pažymėti, kad transformeriai turi gerokai mažesnį induktyvinio šališkumo link lokalumo ir postūmio invariantiškumo laipsnį nei CNN. Tai, kad išmoktos struktūros įgijo viršų, lemia, ne mažiausia, didelių vaizdų kolekcijų, tokių kaip LAION-400m ir LAION-5B (Schuhmann ir kt., 2022) su iki 5 milijardų vaizdų, prieinamumas. Gana netikėtai, kai kurie svarbesni šio konteksto darbai apima net MLP (Tolstikhin ir kt., 2021).
Apibendrinant, regos transformeriai (11.8 skyrelis) šiuo metu pirmauja pagal pažangiausią našumą didelio masto vaizdų klasifikavime, rodydami, kad mastelio keitimas nugali induktyvinius šališkumus (Dosovitskiy ir kt., 2021). Tai apima didelio masto transformerių išankstinį apmokymą (11.9 skyrelis) su lygiagrečia dėmesio sutelkimo transformacija sau pačiam (11.5 skyrelis). Kviečiame skaitytojus panirti į tuos skyrius, kuriuose pateikta daug išsamesnė diskusija.
8.8.6 Pratimai
- Padidinkite etapų skaičių iki keturių. Ar galite suprojektuoti gilesnį RegNetX, kuris veiktų geriau?
- Pašalinkite ResNeXt iš RegNet, pakeisdami ResNeXt bloką ResNet bloku. Kaip veikia jūsų naujas modelis?
- Įgyvendinkite kelis „VioNet“ šeimos egzempliorius pažeisdami RegNetX dizaino principus. Kaip jie veikia? Kuris iš (, , , ) yra svarbiausias veiksnys?
- Jūsų tikslas – suprojektuoti „tobulą“ MLP. Ar galite naudoti aukščiau pristatytus dizaino principus gerų architektūrų paieškai? Ar įmanoma ekstrapoliuoti iš mažų į didelius tinklus?