
11.8 Transformeriai regai
Transformerių architektūra iš pradžių buvo pasiūlyta sekos į seką mokymuisi, daugiausia dėmesio skiriant mašininiam vertimui. Vėliau transformeriai tapo pasirinktu modeliu įvairiose natūraliosios kalbos apdorojimo užduotyse (Radford ir kt., 2018; Radford ir kt., 2019; Brown ir kt., 2020; Devlin ir kt., 2018; Raffel ir kt., 2020). Tačiau kompiuterinės regos srityje dominuojanti architektūra liko CNN (8 skyrelis). Natūralu, kad tyrėjai pradėjo svarstyti, ar galima pasiekti geresnių rezultatų pritaikius transformerių modelius vaizdų duomenims. Šis klausimas sukėlė didžiulį susidomėjimą kompiuterinės regos bendruomenėje. Neseniai (Ramachandran ir kt., 2019) pasiūlė schemą, kaip konvoliuciją pakeisti saviraiške dėmesio sutelkimo transformacija. Tačiau dėl specialių šablonų naudojimo dėmesio sutelkime sunku didinti modelių mastelį aparatinės įrangos greitintuvuose. Tada (Cordonnier ir kt., 2020) teoriškai įrodė, kad saviraiškė dėmesio sutelkimo transformacija gali išmokti elgtis panašiai kaip konvoliucija. Empiriškai kaip įvestys buvo imami vaizdo fragmentai (angl. patches), tačiau dėl mažo fragmento dydžio modelis tinka tik žemos skiriamosios gebos vaizdų duomenims.
Be specialių fragmento dydžio apribojimų, regimieji transformeriai (angl. vision Transformers, ViT) išskiria fragmentus iš vaizdų ir paduoda juos į transformerio kodavimo bloką, kad gautų globalų vaizdą, kuris galiausiai transformuojamas klasifikavimui (Dosovitskiy ir kt., 2021). Pažymėtina, kad transformeriai rodo geresnį mastelio didinimą nei CNN: apmokant didesnius modelius didesniuose duomenų rinkiniuose, regimieji transformeriai pranoksta ResNet žymia persvara. Panašiai kaip tinklų architektūros projektavimo kraštovaizdyje natūraliosios kalbos apdorojime, transformeriai taip pat tapo lūžio tašku kompiuterinėje regoje.
from d2l import torch as d2l
import torch
from torch import nn
from d2l import jax as d2l
from flax import linen as nn
import jax
from jax import numpy as jnp
11.8.1 Modelis
11.8.1 pav. pavaizduota regimųjų transformerių modelio architektūra. Šią architektūrą sudaro įvadas (angl. stem), kuris suskaido vaizdus į fragmentus, kūnas, pagrįstas daugiasluoksniu transformerio kodavimo bloku, ir galva, kuri paverčia globalų vaizdą išvesties žymeniu.
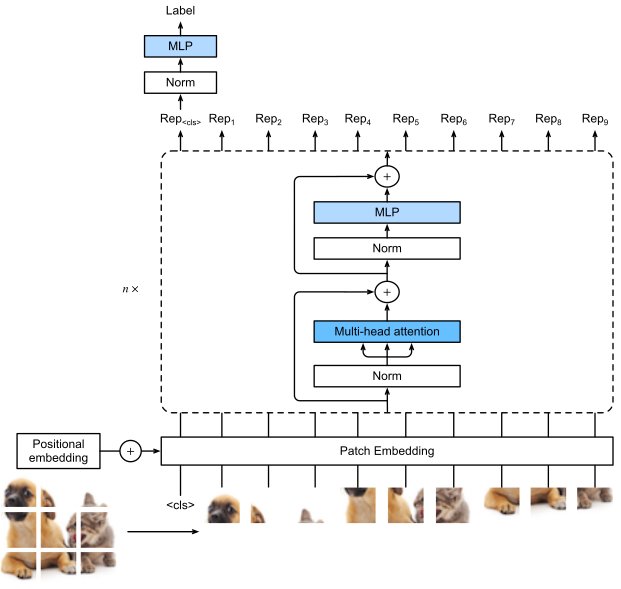
11.8.1 pav. Regimojo transformerio architektūra. Šiame pavyzdyje vaizdas padalytas į devynis fragmentus. Specialus „<cls>“ teksto vienetas ir devyni išlyginti vaizdo fragmentai per fragmentų įterpimą ir transformerio kodavimo bloko blokų paverčiami atitinkamai dešimčia vaizdų. „<cls>“ vaizdas toliau paverčiamas išvesties žymeniu.
Apsvarstykime įvesties vaizdą, kurio aukštis , plotis ir kanalų. Nurodžius, kad fragmento aukštis ir plotis abu yra , vaizdas suskaidomas į fragmentų seką, kur kiekvienas fragmentas išlyginamas į ilgio vektorių. Taip transformerio kodavimo blokai gali traktuoti vaizdo fragmentus panašiai kaip teksto sekų teksto vienetus. Specialus „<cls>“ (klasės) teksto vienetas ir išlygintų vaizdo fragmentų tiesiškai projektuojami į vektorių seką, sudedamą su mokomais poziciniais įterpiniais. Daugiasluoksnis transformerio kodavimo blokas transformuoja įvesties vektorių į tiek pat to paties ilgio išvesties vektorių vaizdų. Jis veikia lygiai taip pat kaip originalus transformerio kodavimo blokas 11.7.1 pav., skiriasi tik normalizacijos vieta. Kadangi „<cls>“ teksto vienetas sutelkia dėmesį į visus vaizdo fragmentus per saviraišką dėmesio sutelkimo transformaciją (žr. 11.6.1 pav.), jo vaizdas iš transformerio kodavimo bloko išvesties bus toliau paverčiamas išvesties žymeniu.
11.8.2 Fragmentų įterpimas
Kad įgyvendintume regimąjį transformerį, pradėkime nuo fragmentų įterpimo 11.8.1 pav.. Vaizdo suskaidymą į fragmentus ir šių išlygintų fragmentų tiesinį projektavimą galima supaprastinti iki vienos konvoliucijos operacijos, kur ir branduolio dydis, ir žingsnio dydis nustatomi lygūs fragmento dydžiui.
class PatchEmbedding(nn.Module):
    def __init__(self, img_size=96, patch_size=16, num_hiddens=512):
        super().__init__()
        def _make_tuple(x):
            if not isinstance(x, (list, tuple)):
                return (x, x)
            return x
        img_size, patch_size = _make_tuple(img_size), _make_tuple(patch_size)
        self.num_patches = (img_size[0] // patch_size[0]) * (
            img_size[1] // patch_size[1])
        self.conv = nn.LazyConv2d(num_hiddens, kernel_size=patch_size,
                                  stride=patch_size)

    def forward(self, X):
        # Output shape: (batch size, no. of patches, no. of channels)
        return self.conv(X).flatten(2).transpose(1, 2)
class PatchEmbedding(nn.Module):
    img_size: int = 96
    patch_size: int = 16
    num_hiddens: int = 512

    def setup(self):
        def _make_tuple(x):
            if not isinstance(x, (list, tuple)):
                return (x, x)
            return x
        img_size, patch_size = _make_tuple(self.img_size), _make_tuple(self.patch_size)
        self.num_patches = (img_size[0] // patch_size[0]) * (
            img_size[1] // patch_size[1])
        self.conv = nn.Conv(self.num_hiddens, kernel_size=patch_size,
                            strides=patch_size, padding='SAME')

    def __call__(self, X):
        # Output shape: (batch size, no. of patches, no. of channels)
        X = self.conv(X)
        return X.reshape((X.shape[0], -1, X.shape[3]))
Toliau pateiktame pavyzdyje, kaip įvestis imant vaizdus, kurių aukštis ir plotis yra img_size,
fragmentų įterpimas išveda (img_size//patch_size)**2 fragmentų,
kurie tiesiškai projektuojami į num_hiddens ilgio vektorius.
img_size, patch_size, num_hiddens, batch_size = 96, 16, 512, 4
patch_emb = PatchEmbedding(img_size, patch_size, num_hiddens)
X = d2l.zeros(batch_size, 3, img_size, img_size)
d2l.check_shape(patch_emb(X),
                (batch_size, (img_size//patch_size)**2, num_hiddens))
img_size, patch_size, num_hiddens, batch_size = 96, 16, 512, 4
patch_emb = PatchEmbedding(img_size, patch_size, num_hiddens)
X = d2l.zeros((batch_size, img_size, img_size, 3))
output, _ = patch_emb.init_with_output(d2l.get_key(), X)
d2l.check_shape(output, (batch_size, (img_size//patch_size)**2, num_hiddens))
11.8.3 Regimojo transformerio kodavimo blokas
Regimojo transformerio kodavimo bloko MLP šiek tiek skiriasi nuo originalaus transformerio kodavimo bloko pozicinio tiesioginio sklidimo tinklo (žr. 11.7.2 skyrelis). Pirma, čia aktyvacijos funkcija naudoja Gauso paklaidos tiesinį vienetą (GELU), kurį galima laikyti glotnesne ReLU versija (Hendrycks ir Gimpel, 2016). Antra, reguliarizacijai dropout taikomas kiekvieno pilnai sujungto MLP sluoksnio išvesčiai.
class ViTMLP(nn.Module):
    def __init__(self, mlp_num_hiddens, mlp_num_outputs, dropout=0.5):
        super().__init__()
        self.dense1 = nn.LazyLinear(mlp_num_hiddens)
        self.gelu = nn.GELU()
        self.dropout1 = nn.Dropout(dropout)
        self.dense2 = nn.LazyLinear(mlp_num_outputs)
        self.dropout2 = nn.Dropout(dropout)

    def forward(self, x):
        return self.dropout2(self.dense2(self.dropout1(self.gelu(
            self.dense1(x)))))
class ViTMLP(nn.Module):
    mlp_num_hiddens: int
    mlp_num_outputs: int
    dropout: float = 0.5

    @nn.compact
    def __call__(self, x, training=False):
        x = nn.Dense(self.mlp_num_hiddens)(x)
        x = nn.gelu(x)
        x = nn.Dropout(self.dropout, deterministic=not training)(x)
        x = nn.Dense(self.mlp_num_outputs)(x)
        x = nn.Dropout(self.dropout, deterministic=not training)(x)
        return x
Regimojo transformerio kodavimo bloko bloko įgyvendinimas tiesiog seka išankstinės normalizacijos dizainą 11.8.1 pav., kur normalizacija taikoma iškart prieš lygiagrečią dėmesio sutelkimo transformaciją arba MLP. Skirtingai nei po-normalizacija („sudėk ir normalizuok“ 11.7.1 pav.), kai normalizacija dedama iškart po liekamųjų jungčių, išankstinė normalizacija lemia veiksmingesnį ar efektyvesnį transformerių apmokymą (Baevski ir Auli, 2018; Wang ir kt., 2019; Xiong ir kt., 2020).
class ViTBlock(nn.Module):
    def __init__(self, num_hiddens, norm_shape, mlp_num_hiddens,
                 num_heads, dropout, use_bias=False):
        super().__init__()
        self.ln1 = nn.LayerNorm(norm_shape)
        self.attention = d2l.MultiHeadAttention(num_hiddens, num_heads,
                                                dropout, use_bias)
        self.ln2 = nn.LayerNorm(norm_shape)
        self.mlp = ViTMLP(mlp_num_hiddens, num_hiddens, dropout)

    def forward(self, X, valid_lens=None):
        X = X + self.attention(*([self.ln1(X)] * 3), valid_lens)
        return X + self.mlp(self.ln2(X))
class ViTBlock(nn.Module):
    num_hiddens: int
    mlp_num_hiddens: int
    num_heads: int
    dropout: float
    use_bias: bool = False

    def setup(self):
        self.attention = d2l.MultiHeadAttention(self.num_hiddens, self.num_heads,
                                                self.dropout, self.use_bias)
        self.mlp = ViTMLP(self.mlp_num_hiddens, self.num_hiddens, self.dropout)

    @nn.compact
    def __call__(self, X, valid_lens=None, training=False):
        X = X + self.attention(*([nn.LayerNorm()(X)] * 3),
                               valid_lens, training=training)[0]
        return X + self.mlp(nn.LayerNorm()(X), training=training)
Kaip ir 11.7.4 skyrelis, joks regimojo transformerio kodavimo bloko blokas nekeičia savo įvesties formos.
X = d2l.ones((2, 100, 24))
encoder_blk = ViTBlock(24, 24, 48, 8, 0.5)
encoder_blk.eval()
d2l.check_shape(encoder_blk(X), X.shape)
X = d2l.ones((2, 100, 24))
encoder_blk = ViTBlock(24, 48, 8, 0.5)
d2l.check_shape(encoder_blk.init_with_output(d2l.get_key(), X)[0], X.shape)
11.8.4 Viskas kartu
Toliau pateiktas regimųjų transformerių tiesioginis sklidimas yra paprastas.
Pirmiausia įvesties vaizdai paduodami į PatchEmbedding egzempliorių,
kurio išvestis sujungiama su „<cls>“ teksto vieneto įterpiniu.
Jie sudedami su mokomais poziciniais įterpiniais prieš dropout.
Tada išvestis paduodama į transformerio kodavimo bloką, kuris sukrauna num_blks klasės ViTBlock egzempliorių.
Galiausiai „<cls>“ teksto vieneto vaizdą projektuoja tinklo galva.
class ViT(d2l.Classifier):
    """Vision Transformer."""
    def __init__(self, img_size, patch_size, num_hiddens, mlp_num_hiddens,
                 num_heads, num_blks, emb_dropout, blk_dropout, lr=0.1,
                 use_bias=False, num_classes=10):
        super().__init__()
        self.save_hyperparameters()
        self.patch_embedding = PatchEmbedding(
            img_size, patch_size, num_hiddens)
        self.cls_token = nn.Parameter(d2l.zeros(1, 1, num_hiddens))
        num_steps = self.patch_embedding.num_patches + 1  # Add the cls token
        # Positional embeddings are learnable
        self.pos_embedding = nn.Parameter(
            torch.randn(1, num_steps, num_hiddens))
        self.dropout = nn.Dropout(emb_dropout)
        self.blks = nn.Sequential()
        for i in range(num_blks):
            self.blks.add_module(f"{i}", ViTBlock(
                num_hiddens, num_hiddens, mlp_num_hiddens,
                num_heads, blk_dropout, use_bias))
        self.head = nn.Sequential(nn.LayerNorm(num_hiddens),
                                  nn.Linear(num_hiddens, num_classes))

    def forward(self, X):
        X = self.patch_embedding(X)
        X = d2l.concat((self.cls_token.expand(X.shape[0], -1, -1), X), 1)
        X = self.dropout(X + self.pos_embedding)
        for blk in self.blks:
            X = blk(X)
        return self.head(X[:, 0])
class ViT(d2l.Classifier):
    """Vision Transformer."""
    img_size: int
    patch_size: int
    num_hiddens: int
    mlp_num_hiddens: int
    num_heads: int
    num_blks: int
    emb_dropout: float
    blk_dropout: float
    lr: float = 0.1
    use_bias: bool = False
    num_classes: int = 10
    training: bool = False

    def setup(self):
        self.patch_embedding = PatchEmbedding(self.img_size, self.patch_size,
                                              self.num_hiddens)
        self.cls_token = self.param('cls_token', nn.initializers.zeros,
                                    (1, 1, self.num_hiddens))
        num_steps = self.patch_embedding.num_patches + 1  # Add the cls token
        # Positional embeddings are learnable
        self.pos_embedding = self.param('pos_embed', nn.initializers.normal(),
                                        (1, num_steps, self.num_hiddens))
        self.blks = [ViTBlock(self.num_hiddens, self.mlp_num_hiddens,
                              self.num_heads, self.blk_dropout, self.use_bias)
                    for _ in range(self.num_blks)]
        self.head = nn.Sequential([nn.LayerNorm(), nn.Dense(self.num_classes)])

    @nn.compact
    def __call__(self, X):
        X = self.patch_embedding(X)
        X = d2l.concat((jnp.tile(self.cls_token, (X.shape[0], 1, 1)), X), 1)
        X = nn.Dropout(emb_dropout, deterministic=not self.training)(X + self.pos_embedding)
        for blk in self.blks:
            X = blk(X, training=self.training)
        return self.head(X[:, 0])
11.8.5 Mokymas
Regimojo transformerio apmokymas Fashion-MNIST duomenų rinkinyje yra tarsi CNN apmokymas 8 skyrelis.
img_size, patch_size = 96, 16
num_hiddens, mlp_num_hiddens, num_heads, num_blks = 512, 2048, 8, 2
emb_dropout, blk_dropout, lr = 0.1, 0.1, 0.1
model = ViT(img_size, patch_size, num_hiddens, mlp_num_hiddens, num_heads,
            num_blks, emb_dropout, blk_dropout, lr)
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128, resize=(img_size, img_size))
trainer.fit(model, data)
11.8.6 Santrauka ir diskusija
Galbūt pastebėjote, kad mažuose duomenų rinkiniuose, tokiuose kaip Fashion-MNIST, mūsų įgyvendintas regimasis transformeris nepralenkia ResNet iš 8.6 skyrelis. Panašių pastebėjimų galima padaryti net ImageNet duomenų rinkinyje (1,2 milijono vaizdų). Taip yra todėl, kad transformeriams trūksta tų naudingų konvoliucijos principų, tokių kaip postūmio invariantiškumas ir lokalumas (7.1 skyrelis). Tačiau vaizdas pasikeičia apmokant didesnius modelius didesniuose duomenų rinkiniuose (pvz., 300 milijonų vaizdų), kur regimieji transformeriai vaizdų klasifikavime pranoksta ResNet didele persvara, parodydami būdingą transformerių pranašumą mastelio didinimo prasme (Dosovitskiy ir kt., 2021). Regimųjų transformerių pristatymas pakeitė tinklų projektavimo vaizdų duomenims modeliuoti kraštovaizdį. Netrukus buvo parodyta, kad jie veiksmingi ImageNet duomenų rinkinyje su duomenis taupančiomis DeiT apmokymo strategijomis (Touvron ir kt., 2021). Tačiau saviraiškės dėmesio sutelkimo transformacijos kvadratinis sudėtingumas (11.6 skyrelis) daro transformerių architektūrą mažiau tinkamą didesnės skiriamosios gebos vaizdams. Siekdami bendrosios paskirties pagrindinio tinklo kompiuterinėje regoje, Swin transformeriai sprendė kvadratinį skaičiavimo sudėtingumą vaizdo dydžio atžvilgiu (11.6.2 skyrelis) ir grąžino į konvoliuciją panašias prielaidas, išplėsdami transformerių pritaikomumą įvairioms kompiuterinės regos užduotims, ne tik vaizdų klasifikavimui, su pažangiausiais rezultatais (Liu ir kt., 2021).
11.8.7 Pratimai
- Kaip
img_sizereikšmė veikia apmokymo laiką? - Užuot projektavus „<cls>“ teksto vieneto vaizdą į išvestį, kaip projektuotumėte vidurkintus fragmentų vaizdus? Įgyvendinkite šį pakeitimą ir pažiūrėkite, kaip jis veikia tikslumą.
- Ar galite pakeisti hiperparametrus, kad pagerintumėte regimojo transformerio tikslumą?