
11.3 Dėmesio vertinimo funkcijos
11.2 skyrelis naudojome keletą skirtingų atstumu pagrįstų branduolių, įskaitant Gauso branduolį, modeliuoti sąveikoms tarp užklausų ir raktų. Pasirodo, atstumo funkcijas skaičiuoti šiek tiek brangiau nei skaliarines sandaugas. Todėl, naudojant softmax operaciją neneigiamiems dėmesio svoriams užtikrinti, daug darbo buvo skirta dėmesio vertinimo funkcijoms (11.1.2) ir 11.3.1 pav., kurias paprasčiau apskaičiuoti.
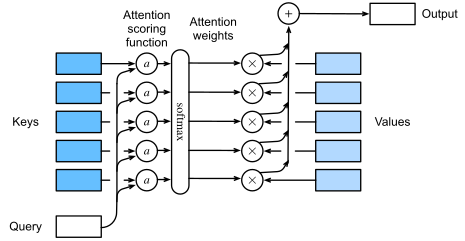
11.3.1 pav. Dėmesio sutelkimo išvesties apskaičiavimas kaip reikšmių svertinio vidurkio, kur svoriai apskaičiuojami su dėmesio vertinimo funkcija ir softmax operacija.
import math
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
from d2l import torch as d2l
import math
import torch
from torch import nn
from d2l import tensorflow as d2l
import tensorflow as tf
from d2l import jax as d2l
from flax import linen as nn
from jax import numpy as jnp
import jax
import math
11.3.1 Skaliarinės sandaugos dėmesys
Trumpam peržvelkime dėmesio funkciją (be eksponentinimo), gautą iš Gauso branduolio:
Pirma, atkreipkite dėmesį, kad paskutinis narys priklauso tik nuo . Todėl jis vienodas visoms poroms . Dėmesio svorių normalizavimas iki , kaip daroma (11.1.2), užtikrina, kad šis narys visiškai išnyksta. Antra, atkreipkite dėmesį, kad ir rinkinio, ir sluoksnio normalizacija (aptarsime vėliau) lemia aktyvacijas, kurių normos yra gerai apribotos ir dažnai pastovios. Taip yra, pavyzdžiui, kai raktus sukūrė sluoksnio normalizacija. Todėl galime jį išmesti iš apibrėžimo be didesnių rezultato pokyčių.
Galiausiai turime kontroliuoti eksponentinės funkcijos argumentų dydžio eilę. Tarkime, kad visi užklausos ir rakto elementai yra nepriklausomi ir vienodai pasiskirstę atsitiktiniai dydžiai su nuliniu vidurkiu ir vienetine dispersija. Abiejų vektorių skaliarinė sandauga turi nulinį vidurkį ir dispersiją . Kad skaliarinės sandaugos dispersija vis dar išliktų nepriklausomai nuo vektoriaus ilgio, naudojame mastelio keičiamos skaliarinės sandaugos dėmesio vertinimo funkciją. T. y. skaliarinę sandaugą perskaliuojame per . Taip prieiname prie pirmosios dažnai naudojamos dėmesio funkcijos, naudojamos, pvz., transformeriuose (Vaswani ir kt., 2017):
Atkreipkite dėmesį, kad dėmesio svorius vis dar reikia normalizuoti. Tai galime dar labiau supaprastinti per (11.1.2), naudodami softmax operaciją:
Pasirodo, visi populiarūs dėmesio sutelkimo mechanizmai naudoja softmax, todėl likusioje šio skyriaus dalyje apsiribosime juo.
11.3.2 Pagalbinės funkcijos
Mums reikia kelių funkcijų, kad dėmesio sutelkimo mechanizmą būtų efektyvu diegti. Tai apima įrankius kintamo ilgio eilutėms tvarkyti (įprasta natūraliosios kalbos apdorojime) ir įrankius efektyviam vertinimui minirinkiniuose (rinkinio matricų daugyba).
11.3.2.1 Maskuota softmax operacija
Vienas populiariausių dėmesio sutelkimo mechanizmo taikymų yra sekų modeliai. Todėl turime gebėti tvarkyti skirtingo ilgio sekas. Kai kuriais atvejais tokios sekos gali patekti į tą patį minirinkinį, todėl trumpesnes sekas reikia užpildyti netikrais teksto vienetais (pavyzdį žr. 10.5 skyrelis). Šie specialūs teksto vienetai neturi prasmės. Pavyzdžiui, tarkime, kad turime tokius tris sakinius:
Dive  into  Deep    Learning
Learn to    code    <blank>
Hello world <blank> <blank>
Kadangi savo dėmesio modelyje nenorime tuščių vietų, tiesiog turime apriboti iki , kad ir koks ilgas, , būtų faktinis sakinys. Kadangi tai tokia dažna problema, ji turi pavadinimą: maskuota softmax operacija.
Įgyvendinkime ją. Iš tiesų įgyvendinimas šiek tiek sukčiauja, nustatydamas reikšmes, kai , į nulį. Be to, jis nustato dėmesio svorius į didelį neigiamą skaičių, pvz., , kad jų indėlis į gradientus ir reikšmes praktikoje išnyktų. Tai daroma todėl, kad tiesinės algebros branduoliai ir operatoriai yra labai optimizuoti GPU, ir greičiau yra šiek tiek švaistyti skaičiavimus, nei turėti kodą su sąlygos (if then else) sakiniais.
def masked_softmax(X, valid_lens):  #@save
    """Perform softmax operation by masking elements on the last axis."""
    # X: 3D tensor, valid_lens: 1D or 2D tensor
    if valid_lens is None:
        return npx.softmax(X)
    else:
        shape = X.shape
        if valid_lens.ndim == 1:
            valid_lens = valid_lens.repeat(shape[1])
        else:
            valid_lens = valid_lens.reshape(-1)
        # On the last axis, replace masked elements with a very large negative
        # value, whose exponentiation outputs 0
        X = npx.sequence_mask(X.reshape(-1, shape[-1]), valid_lens, True,
                              value=-1e6, axis=1)
        return npx.softmax(X).reshape(shape)
def masked_softmax(X, valid_lens):  #@save
    """Perform softmax operation by masking elements on the last axis."""
    # X: 3D tensor, valid_lens: 1D or 2D tensor
    def _sequence_mask(X, valid_len, value=0):
        maxlen = X.size(1)
        mask = torch.arange((maxlen), dtype=torch.float32,
                            device=X.device)[None, :] < valid_len[:, None]
        X[~mask] = value
        return X

    if valid_lens is None:
        return nn.functional.softmax(X, dim=-1)
    else:
        shape = X.shape
        if valid_lens.dim() == 1:
            valid_lens = torch.repeat_interleave(valid_lens, shape[1])
        else:
            valid_lens = valid_lens.reshape(-1)
        # On the last axis, replace masked elements with a very large negative
        # value, whose exponentiation outputs 0
        X = _sequence_mask(X.reshape(-1, shape[-1]), valid_lens, value=-1e6)
        return nn.functional.softmax(X.reshape(shape), dim=-1)
def masked_softmax(X, valid_lens):  #@save
    """Perform softmax operation by masking elements on the last axis."""
    # X: 3D tensor, valid_lens: 1D or 2D tensor
    def _sequence_mask(X, valid_len, value=0):
        maxlen = X.shape[1]
        mask = tf.range(start=0, limit=maxlen, dtype=tf.float32)[
            None, :] < tf.cast(valid_len[:, None], dtype=tf.float32)

        if len(X.shape) == 3:
            return tf.where(tf.expand_dims(mask, axis=-1), X, value)
        else:
            return tf.where(mask, X, value)

    if valid_lens is None:
        return tf.nn.softmax(X, axis=-1)
    else:
        shape = X.shape
        if len(valid_lens.shape) == 1:
            valid_lens = tf.repeat(valid_lens, repeats=shape[1])

        else:
            valid_lens = tf.reshape(valid_lens, shape=-1)
        # On the last axis, replace masked elements with a very large negative
        # value, whose exponentiation outputs 0
        X = _sequence_mask(tf.reshape(X, shape=(-1, shape[-1])), valid_lens,
                           value=-1e6)
        return tf.nn.softmax(tf.reshape(X, shape=shape), axis=-1)
def masked_softmax(X, valid_lens):  #@save
    """Perform softmax operation by masking elements on the last axis."""
    # X: 3D tensor, valid_lens: 1D or 2D tensor
    def _sequence_mask(X, valid_len, value=0):
        maxlen = X.shape[1]
        mask = jnp.arange((maxlen),
                          dtype=jnp.float32)[None, :] < valid_len[:, None]
        return jnp.where(mask, X, value)

    if valid_lens is None:
        return nn.softmax(X, axis=-1)
    else:
        shape = X.shape
        if valid_lens.ndim == 1:
            valid_lens = jnp.repeat(valid_lens, shape[1])
        else:
            valid_lens = valid_lens.reshape(-1)
        # On the last axis, replace masked elements with a very large negative
        # value, whose exponentiation outputs 0
        X = _sequence_mask(X.reshape(-1, shape[-1]), valid_lens, value=-1e6)
        return nn.softmax(X.reshape(shape), axis=-1)
Kad iliustruotume, kaip veikia ši funkcija, apsvarstykime dviejų pavyzdžių minirinkinį, kurio dydis , o jų galiojantys ilgiai yra atitinkamai ir . Dėl maskuotos softmax operacijos reikšmės už kiekvienos vektorių poros galiojančių ilgių ribų yra užmaskuojamos nuliais.
masked_softmax(np.random.uniform(size=(2, 2, 4)), d2l.tensor([2, 3]))
masked_softmax(torch.rand(2, 2, 4), torch.tensor([2, 3]))
masked_softmax(tf.random.uniform(shape=(2, 2, 4)), tf.constant([2, 3]))
masked_softmax(jax.random.uniform(d2l.get_key(), (2, 2, 4)), jnp.array([2, 3]))
Jei reikia smulkesnės kontrolės, kad nurodytume galiojantį ilgį kiekvienam iš dviejų kiekvieno pavyzdžio vektorių, tiesiog naudojame dvimatį galiojančių ilgių tenzorių. Tai duoda:
masked_softmax(np.random.uniform(size=(2, 2, 4)),
               d2l.tensor([[1, 3], [2, 4]]))
masked_softmax(torch.rand(2, 2, 4), d2l.tensor([[1, 3], [2, 4]]))
masked_softmax(tf.random.uniform((2, 2, 4)), tf.constant([[1, 3], [2, 4]]))
masked_softmax(jax.random.uniform(d2l.get_key(), (2, 2, 4)),
               jnp.array([[1, 3], [2, 4]]))
11.3.2.2 Rinkinio matricų daugyba
Kita dažnai naudojama operacija yra matricų rinkinių daugyba tarpusavyje. Tai pravartu, kai turime užklausų, raktų ir reikšmių minirinkinius. Konkrečiau, tarkime, kad
Tada rinkinio matricų daugyba (BMM) apskaičiuoja elementų lygmens sandaugą
Pažiūrėkime, kaip tai veikia giliojo mokymosi karkase.
Q = d2l.ones((2, 3, 4))
K = d2l.ones((2, 4, 6))
d2l.check_shape(npx.batch_dot(Q, K), (2, 3, 6))
Q = d2l.ones((2, 3, 4))
K = d2l.ones((2, 4, 6))
d2l.check_shape(torch.bmm(Q, K), (2, 3, 6))
Q = d2l.ones((2, 3, 4))
K = d2l.ones((2, 4, 6))
d2l.check_shape(tf.matmul(Q, K).numpy(), (2, 3, 6))
Q = d2l.ones((2, 3, 4))
K = d2l.ones((2, 4, 6))
d2l.check_shape(jax.lax.batch_matmul(Q, K), (2, 3, 6))
11.3.3 Mastelio keičiamos skaliarinės sandaugos dėmesys
Grįžkime prie skaliarinės sandaugos dėmesio, pristatyto (11.3.1). Apskritai jis reikalauja, kad ir užklausa, ir raktas turėtų tą patį vektoriaus ilgį, tarkime , nors tai galima lengvai išspręsti pakeitus į , kur yra matrica, tinkamai pasirinkta pereiti tarp abiejų erdvių. Kol kas tarkime, kad dimensijos sutampa.
Praktikoje dėl efektyvumo dažnai galvojame apie minirinkinius, pavyzdžiui, apskaičiuojame dėmesį užklausų ir raktų ir reikšmių porų, kur užklausų ir raktų ilgis , o reikšmių ilgis . Užklausų , raktų ir reikšmių mastelio keičiamos skaliarinės sandaugos dėmesį taigi galima užrašyti kaip
Atkreipkite dėmesį, kad taikydami tai minirinkiniui, turime naudoti rinkinio matricų daugybą, pristatytą (11.3.3). Toliau pateiktame mastelio keičiamos skaliarinės sandaugos dėmesio įgyvendinime modelio reguliarizacijai naudojame dropout.
class DotProductAttention(nn.Block):  #@save
    """Scaled dot product attention."""
    def __init__(self, dropout):
        super().__init__()
        self.dropout = nn.Dropout(dropout)

    # Shape of queries: (batch_size, no. of queries, d)
    # Shape of keys: (batch_size, no. of key-value pairs, d)
    # Shape of values: (batch_size, no. of key-value pairs, value dimension)
    # Shape of valid_lens: (batch_size,) or (batch_size, no. of queries)
    def forward(self, queries, keys, values, valid_lens=None):
        d = queries.shape[-1]
        # Set transpose_b=True to swap the last two dimensions of keys
        scores = npx.batch_dot(queries, keys, transpose_b=True) / math.sqrt(d)
        self.attention_weights = masked_softmax(scores, valid_lens)
        return npx.batch_dot(self.dropout(self.attention_weights), values)
class DotProductAttention(nn.Module):  #@save
    """Scaled dot product attention."""
    def __init__(self, dropout):
        super().__init__()
        self.dropout = nn.Dropout(dropout)

    # Shape of queries: (batch_size, no. of queries, d)
    # Shape of keys: (batch_size, no. of key-value pairs, d)
    # Shape of values: (batch_size, no. of key-value pairs, value dimension)
    # Shape of valid_lens: (batch_size,) or (batch_size, no. of queries)
    def forward(self, queries, keys, values, valid_lens=None):
        d = queries.shape[-1]
        # Swap the last two dimensions of keys with keys.transpose(1, 2)
        scores = torch.bmm(queries, keys.transpose(1, 2)) / math.sqrt(d)
        self.attention_weights = masked_softmax(scores, valid_lens)
        return torch.bmm(self.dropout(self.attention_weights), values)
class DotProductAttention(tf.keras.layers.Layer):  #@save
    """Scaled dot product attention."""
    def __init__(self, dropout):
        super().__init__()
        self.dropout = tf.keras.layers.Dropout(dropout)

    # Shape of queries: (batch_size, no. of queries, d)
    # Shape of keys: (batch_size, no. of key-value pairs, d)
    # Shape of values: (batch_size, no. of key-value pairs, value dimension)
    # Shape of valid_lens: (batch_size,) or (batch_size, no. of queries)
    def call(self, queries, keys, values, valid_lens=None, **kwargs):
        d = queries.shape[-1]
        scores = tf.matmul(queries, keys, transpose_b=True)/tf.math.sqrt(
            tf.cast(d, dtype=tf.float32))
        self.attention_weights = masked_softmax(scores, valid_lens)
        return tf.matmul(self.dropout(self.attention_weights, **kwargs), values)
class DotProductAttention(nn.Module):  #@save
    """Scaled dot product attention."""
    dropout: float

    # Shape of queries: (batch_size, no. of queries, d)
    # Shape of keys: (batch_size, no. of key-value pairs, d)
    # Shape of values: (batch_size, no. of key-value pairs, value dimension)
    # Shape of valid_lens: (batch_size,) or (batch_size, no. of queries)
    @nn.compact
    def __call__(self, queries, keys, values, valid_lens=None,
                 training=False):
        d = queries.shape[-1]
        # Swap the last two dimensions of keys with keys.swapaxes(1, 2)
        scores = queries@(keys.swapaxes(1, 2)) / math.sqrt(d)
        attention_weights = masked_softmax(scores, valid_lens)
        dropout_layer = nn.Dropout(self.dropout, deterministic=not training)
        return dropout_layer(attention_weights)@values, attention_weights
Kad iliustruotume, kaip veikia klasė DotProductAttention,
naudojame tuos pačius raktus, reikšmes ir galiojančius ilgius iš ankstesnio žaislinio adityvinio dėmesio pavyzdžio. Savo pavyzdžio tikslais tarkime, kad minirinkinio dydis yra , iš viso yra raktų ir reikšmių, o reikšmių dimensija yra . Galiausiai tarkime, kad galiojantis ilgis kiekvienam stebėjimui yra atitinkamai ir . Atsižvelgiant į tai, tikimės, kad išvestis bus tenzorius, t. y. po vieną eilutę kiekvienam minirinkinio pavyzdžiui.
queries = d2l.normal(0, 1, (2, 1, 2))
keys = d2l.normal(0, 1, (2, 10, 2))
values = d2l.normal(0, 1, (2, 10, 4))
valid_lens = d2l.tensor([2, 6])

attention = DotProductAttention(dropout=0.5)
attention.initialize()
d2l.check_shape(attention(queries, keys, values, valid_lens), (2, 1, 4))
queries = d2l.normal(0, 1, (2, 1, 2))
keys = d2l.normal(0, 1, (2, 10, 2))
values = d2l.normal(0, 1, (2, 10, 4))
valid_lens = d2l.tensor([2, 6])

attention = DotProductAttention(dropout=0.5)
attention.eval()
d2l.check_shape(attention(queries, keys, values, valid_lens), (2, 1, 4))
queries = tf.random.normal(shape=(2, 1, 2))
keys = tf.random.normal(shape=(2, 10, 2))
values = tf.random.normal(shape=(2, 10, 4))
valid_lens = tf.constant([2, 6])

attention = DotProductAttention(dropout=0.5)
d2l.check_shape(attention(queries, keys, values, valid_lens, training=False),
                (2, 1, 4))
queries = jax.random.normal(d2l.get_key(), (2, 1, 2))
keys = jax.random.normal(d2l.get_key(), (2, 10, 2))
values = jax.random.normal(d2l.get_key(), (2, 10, 4))
valid_lens = d2l.tensor([2, 6])

attention = DotProductAttention(dropout=0.5)
(output, attention_weights), params = attention.init_with_output(
    d2l.get_key(), queries, keys, values, valid_lens)
print(output)
Patikrinkime, ar dėmesio svoriai iš tiesų išnyksta viskam, kas yra už atitinkamai antro ir šešto stulpelių (nes galiojantis ilgis nustatytas ir ).
d2l.show_heatmaps(d2l.reshape(attention.attention_weights, (1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
d2l.show_heatmaps(d2l.reshape(attention_weights, (1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
11.3.4 Adityvinis dėmesys
Kai užklausos ir raktai yra skirtingų dimensijų vektoriai, galime arba naudoti matricą neatitikčiai spręsti per , arba galime naudoti adityvinį dėmesį kaip vertinimo funkciją. Kitas privalumas yra tas, kad, kaip rodo pavadinimas, dėmesys yra adityvinis. Tai gali lemti nedidelį skaičiavimų sutaupymą. Duotai užklausai ir raktui adityvinio dėmesio vertinimo funkcija (Bahdanau ir kt., 2014) yra
kur , ir yra mokomi parametrai. Šis narys toliau paduodamas į softmax, kad būtų užtikrintas ir neneigiamumas, ir normalizacija. Ekvivalentiška (11.3.5) interpretacija yra ta, kad užklausa ir raktas sujungiami ir paduodami į MLP su vienu paslėptuoju sluoksniu. Naudodami kaip aktyvacijos funkciją ir išjungdami poslinkio narius, adityvinį dėmesį įgyvendiname taip:
class AdditiveAttention(nn.Block):  #@save
    """Additive attention."""
    def __init__(self, num_hiddens, dropout, **kwargs):
        super(AdditiveAttention, self).__init__(**kwargs)
        # Use flatten=False to only transform the last axis so that the
        # shapes for the other axes are kept the same
        self.W_k = nn.Dense(num_hiddens, use_bias=False, flatten=False)
        self.W_q = nn.Dense(num_hiddens, use_bias=False, flatten=False)
        self.w_v = nn.Dense(1, use_bias=False, flatten=False)
        self.dropout = nn.Dropout(dropout)

    def forward(self, queries, keys, values, valid_lens):
        queries, keys = self.W_q(queries), self.W_k(keys)
        # After dimension expansion, shape of queries: (batch_size, no. of
        # queries, 1, num_hiddens) and shape of keys: (batch_size, 1,
        # no. of key-value pairs, num_hiddens). Sum them up with
        # broadcasting
        features = np.expand_dims(queries, axis=2) + np.expand_dims(
            keys, axis=1)
        features = np.tanh(features)
        # There is only one output of self.w_v, so we remove the last
        # one-dimensional entry from the shape. Shape of scores:
        # (batch_size, no. of queries, no. of key-value pairs)
        scores = np.squeeze(self.w_v(features), axis=-1)
        self.attention_weights = masked_softmax(scores, valid_lens)
        # Shape of values: (batch_size, no. of key-value pairs, value
        # dimension)
        return npx.batch_dot(self.dropout(self.attention_weights), values)
class AdditiveAttention(nn.Module):  #@save
    """Additive attention."""
    def __init__(self, num_hiddens, dropout, **kwargs):
        super(AdditiveAttention, self).__init__(**kwargs)
        self.W_k = nn.LazyLinear(num_hiddens, bias=False)
        self.W_q = nn.LazyLinear(num_hiddens, bias=False)
        self.w_v = nn.LazyLinear(1, bias=False)
        self.dropout = nn.Dropout(dropout)

    def forward(self, queries, keys, values, valid_lens):
        queries, keys = self.W_q(queries), self.W_k(keys)
        # After dimension expansion, shape of queries: (batch_size, no. of
        # queries, 1, num_hiddens) and shape of keys: (batch_size, 1, no. of
        # key-value pairs, num_hiddens). Sum them up with broadcasting
        features = queries.unsqueeze(2) + keys.unsqueeze(1)
        features = torch.tanh(features)
        # There is only one output of self.w_v, so we remove the last
        # one-dimensional entry from the shape. Shape of scores: (batch_size,
        # no. of queries, no. of key-value pairs)
        scores = self.w_v(features).squeeze(-1)
        self.attention_weights = masked_softmax(scores, valid_lens)
        # Shape of values: (batch_size, no. of key-value pairs, value
        # dimension)
        return torch.bmm(self.dropout(self.attention_weights), values)
class AdditiveAttention(tf.keras.layers.Layer):  #@save
    """Additive attention."""
    def __init__(self, key_size, query_size, num_hiddens, dropout, **kwargs):
        super().__init__(**kwargs)
        self.W_k = tf.keras.layers.Dense(num_hiddens, use_bias=False)
        self.W_q = tf.keras.layers.Dense(num_hiddens, use_bias=False)
        self.w_v = tf.keras.layers.Dense(1, use_bias=False)
        self.dropout = tf.keras.layers.Dropout(dropout)

    def call(self, queries, keys, values, valid_lens, **kwargs):
        queries, keys = self.W_q(queries), self.W_k(keys)
        # After dimension expansion, shape of queries: (batch_size, no. of
        # queries, 1, num_hiddens) and shape of keys: (batch_size, 1, no. of
        # key-value pairs, num_hiddens). Sum them up with broadcasting
        features = tf.expand_dims(queries, axis=2) + tf.expand_dims(
            keys, axis=1)
        features = tf.nn.tanh(features)
        # There is only one output of self.w_v, so we remove the last
        # one-dimensional entry from the shape. Shape of scores: (batch_size,
        # no. of queries, no. of key-value pairs)
        scores = tf.squeeze(self.w_v(features), axis=-1)
        self.attention_weights = masked_softmax(scores, valid_lens)
        # Shape of values: (batch_size, no. of key-value pairs, value
        # dimension)
        return tf.matmul(self.dropout(
            self.attention_weights, **kwargs), values)
class AdditiveAttention(nn.Module):  #@save
    num_hiddens: int
    dropout: float

    def setup(self):
        self.W_k = nn.Dense(self.num_hiddens, use_bias=False)
        self.W_q = nn.Dense(self.num_hiddens, use_bias=False)
        self.w_v = nn.Dense(1, use_bias=False)

    @nn.compact
    def __call__(self, queries, keys, values, valid_lens, training=False):
        queries, keys = self.W_q(queries), self.W_k(keys)
        # After dimension expansion, shape of queries: (batch_size, no. of
        # queries, 1, num_hiddens) and shape of keys: (batch_size, 1, no. of
        # key-value pairs, num_hiddens). Sum them up with broadcasting
        features = jnp.expand_dims(queries, axis=2) + jnp.expand_dims(keys, axis=1)
        features = nn.tanh(features)
        # There is only one output of self.w_v, so we remove the last
        # one-dimensional entry from the shape. Shape of scores: (batch_size,
        # no. of queries, no. of key-value pairs)
        scores = self.w_v(features).squeeze(-1)
        attention_weights = masked_softmax(scores, valid_lens)
        dropout_layer = nn.Dropout(self.dropout, deterministic=not training)
        # Shape of values: (batch_size, no. of key-value pairs, value
        # dimension)
        return dropout_layer(attention_weights)@values, attention_weights
Pažiūrėkime, kaip veikia AdditiveAttention. Savo žaisliniame pavyzdyje pasirenkame užklausas, raktus ir reikšmes, kurių dydžiai atitinkamai
, ir . Tai tapatu mūsų pasirinkimui DotProductAttention, tik dabar užklausos yra matmenų. Panašiai minirinkinio sekoms galiojančiais ilgiais pasirenkame .
queries = d2l.normal(0, 1, (2, 1, 20))

attention = AdditiveAttention(num_hiddens=8, dropout=0.1)
attention.initialize()
d2l.check_shape(attention(queries, keys, values, valid_lens), (2, 1, 4))
queries = d2l.normal(0, 1, (2, 1, 20))

attention = AdditiveAttention(num_hiddens=8, dropout=0.1)
attention.eval()
d2l.check_shape(attention(queries, keys, values, valid_lens), (2, 1, 4))
queries = tf.random.normal(shape=(2, 1, 20))

attention = AdditiveAttention(key_size=2, query_size=20, num_hiddens=8,
                              dropout=0.1)
d2l.check_shape(attention(queries, keys, values, valid_lens, training=False),
                (2, 1, 4))
queries = jax.random.normal(d2l.get_key(), (2, 1, 20))
attention = AdditiveAttention(num_hiddens=8, dropout=0.1)
(output, attention_weights), params = attention.init_with_output(
    d2l.get_key(), queries, keys, values, valid_lens)
print(output)
Peržiūrėdami dėmesio funkciją matome elgesį, kokybiškai gana panašų į DotProductAttention. T. y. tik nariai pasirinktuose galiojančiuose ilgiuose yra nenuliniai.
d2l.show_heatmaps(d2l.reshape(attention.attention_weights, (1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
d2l.show_heatmaps(d2l.reshape(attention_weights, (1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
11.3.5 Santrauka
Šiame skyrelyje pristatėme dvi pagrindines dėmesio vertinimo funkcijas: skaliarinės sandaugos ir adityvinį dėmesį. Tai veiksmingi įrankiai agreguoti per kintamo ilgio sekas. Visų pirma skaliarinės sandaugos dėmesys yra šiuolaikinių transformerių architektūrų pagrindas. Kai užklausos ir raktai yra skirtingų ilgių vektoriai, vietoj to galime naudoti adityvinio dėmesio vertinimo funkciją. Šių sluoksnių optimizavimas yra viena pagrindinių pažangos sričių pastaraisiais metais. Pavyzdžiui, NVIDIA transformerių biblioteka ir „Megatron“ (Shoeybi ir kt., 2019) iš esmės remiasi efektyviais dėmesio sutelkimo mechanizmo variantais. Tai aptarsime gerokai išsamiau, nagrinėdami transformerius vėlesniuose skyreliuose.
11.3.6 Pratimai
- Įgyvendinkite atstumu pagrįstą dėmesį modifikuodami
DotProductAttentionkodą. Atkreipkite dėmesį, kad efektyviam įgyvendinimui reikia tik raktų kvadratinių normų . - Modifikuokite skaliarinės sandaugos dėmesį, kad jis leistų skirtingų dimensijų užklausas ir raktus, naudojant matricą dimensijoms pritaikyti.
- Kaip skaičiavimo kaina keičiasi priklausomai nuo raktų, užklausų, reikšmių dimensijos ir jų skaičiaus? O kaip atminties pralaidumo reikalavimai?