
11.1 Užklausos, raktai ir reikšmės
Iki šiol visi mūsų apžvelgti tinklai iš esmės rėmėsi tuo, kad įvestis yra aiškiai apibrėžto dydžio. Pavyzdžiui, ImageNet vaizdai yra pikselių dydžio, o CNN specialiai pritaikyti šiam dydžiui. Net natūraliosios kalbos apdorojime RNN įvesties dydis yra aiškiai apibrėžtas ir fiksuotas. Kintamas dydis sprendžiamas nuosekliai apdorojant po vieną teksto vienetą arba specialiai suprojektuotais konvoliucijos branduoliais (Kalchbrenner ir kt., 2014). Šis požiūris gali sukelti didelių problemų, kai įvestis iš tiesų yra kintamo dydžio su kintamu informacijos kiekiu, pavyzdžiui, teksto transformavime 10.7 skyrelis (Sutskever ir kt., 2014). Visų pirma ilgoms sekoms tampa gana sunku sekti viską, kas jau buvo sugeneruota ar net peržiūrėta tinklo. Net aiškios sekimo euristikos, tokios kaip pasiūlytos (Yang ir kt., 2016), suteikia tik ribotą naudą.
Palyginkite tai su duomenų bazėmis. Paprasčiausia forma jos yra raktų () ir reikšmių () rinkiniai. Pavyzdžiui, mūsų duomenų bazę gali sudaryti poros {("Zhang", "Aston"), ("Lipton", "Zachary"), ("Li", "Mu"), ("Smola", "Alex"), ("Hu", "Rachel"), ("Werness", "Brent")}, kur pavardė yra raktas, o vardas – reikšmė. Su galime atlikti operacijas, pavyzdžiui, tikslią užklausą () „Li“, kuri grąžintų reikšmę „Mu“. Jei („Li“, „Mu“) nebūtų įrašas, galiojančio atsakymo nebūtų. Jei taip pat leistume apytikslius atitikmenis, vietoj to gautume („Lipton“, „Zachary“). Šis gana paprastas ir trivialus pavyzdys vis dėlto moko mus keleto naudingų dalykų:
- Galime projektuoti užklausas , veikiančias (,) poras taip, kad jos galiotų nepriklausomai nuo duomenų bazės dydžio.
- Ta pati užklausa gali gauti skirtingus atsakymus, priklausomai nuo duomenų bazės turinio.
- „Kodas“, vykdomas didelei būsenų erdvei (duomenų bazei) apdoroti, gali būti gana paprastas (pvz., tikslus atitikimas, apytikslis atitikimas, top-).
- Nereikia suspausti ar supaprastinti duomenų bazės, kad operacijos būtų veiksmingos.
Akivaizdu, kad čia nepristatytume paprastos duomenų bazės, jei ne giliojo mokymosi paaiškinimo tikslais. Iš tiesų tai veda prie vienos įdomiausių per pastarąjį dešimtmetį giliajame mokymesi pristatytų sąvokų: dėmesio sutelkimo mechanizmo (Bahdanau ir kt., 2014). Jo taikymo mašininiam vertimui specifiką aptarsime vėliau. Kol kas tiesiog apsvarstykite štai ką: pažymėkime duomenų bazę iš raktų ir reikšmių porų. Be to, pažymėkime užklausą. Tada dėmesio sutelkimą atžvilgiu galime apibrėžti kaip
kur () yra skaliariniai dėmesio svoriai. Pati operacija paprastai vadinama dėmesio sutelkimu (angl. attention pooling). Pavadinimas dėmesys kyla iš to, kad operacija kreipia ypatingą dėmesį į narius, kuriems svoris yra reikšmingas (t. y. didelis). Taigi dėmesio sutelkimas atžvilgiu sukuria duomenų bazėje esančių reikšmių tiesinį darinį. Tiesą sakant, tai apima aukščiau pateiktą pavyzdį kaip ypatingą atvejį, kai visi svoriai, išskyrus vieną, yra nuliai. Turime keletą ypatingų atvejų:
- Svoriai yra neneigiami. Šiuo atveju dėmesio sutelkimo mechanizmo išvestis priklauso iškiliajam kūgiui, kurį generuoja reikšmės .
- Svoriai sudaro iškilų derinį, t. y. ir visiems . Tai dažniausia nuostata giliajame mokymesi.
- Lygiai vienas iš svorių yra , o visi kiti yra . Tai panašu į tradicinę duomenų bazės užklausą.
- Visi svoriai yra lygūs, t. y. visiems . Tai prilygsta vidurkinimui per visą duomenų bazę, giliajame mokymesi dar vadinamam sutelkimu vidurkinant.
Įprasta strategija užtikrinti, kad svoriai sumuotųsi į , yra juos normalizuoti per
Visų pirma, kad svoriai taip pat būtų neneigiami, galima griebtis eksponentinimo. Tai reiškia, kad dabar galime pasirinkti bet kurią funkciją ir tada pritaikyti jai softmax operaciją, naudojamą daugianariams modeliams, per
Ši operacija lengvai pasiekiama visuose giliojo mokymosi karkasuose. Ji diferencijuojama, o jos gradientas niekada neišnyksta – visos šios savybės pageidautinos modelyje. Vis dėlto atkreipkite dėmesį, kad aukščiau pristatytas dėmesio sutelkimo mechanizmas nėra vienintelis pasirinkimas. Pavyzdžiui, galime suprojektuoti nediferencijuojamą dėmesio sutelkimo modelį, kurį galima apmokyti skatinamojo mokymosi metodais (Mnih ir kt., 2014). Kaip ir galima tikėtis, tokio modelio apmokymas yra gana sudėtingas. Todėl didžioji šiuolaikinių dėmesio sutelkimo tyrimų dalis laikosi 11.1 skyrelis apibrėžto karkaso. Todėl savo pateikimą sutelkiame į šią diferencijuojamų mechanizmų šeimą.
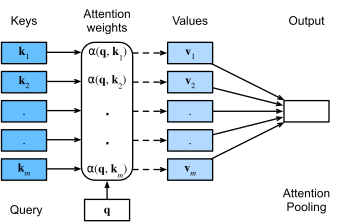
Gana nuostabu tai, kad tikrasis „kodas“, vykdomas raktų ir reikšmių aibei, būtent užklausa, gali būti gana glaustas, nors erdvė, kurioje veikiama, yra didelė. Tai pageidautina tinklo sluoksnio savybė, nes nereikia išmokti per daug parametrų. Ne mažiau patogu ir tai, kad dėmesio sutelkimas gali veikti savavališkai dideles duomenų bazes nekeičiant, kaip atliekama dėmesio sutelkimo operacija.
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
from d2l import torch as d2l
import torch
from d2l import tensorflow as d2l
import tensorflow as tf
from d2l import jax as d2l
from jax import numpy as jnp
11.1.1 Vizualizavimas
Vienas dėmesio sutelkimo mechanizmo privalumų yra tas, kad jis gali būti gana intuityvus, ypač kai svoriai yra neneigiami ir sumuojasi į . Šiuo atveju galime interpretuoti didelius svorius kaip būdą modeliui išrinkti svarbius komponentus. Nors tai gera intuicija, svarbu atminti, kad tai tik tai – intuicija. Bet kuriuo atveju galime norėti vizualizuoti jo poveikį duotai raktų aibei taikant įvairias skirtingas užklausas. Ši funkcija mums pravers vėliau.
Todėl apibrėžiame funkciją show_heatmaps. Atkreipkite dėmesį, kad ji kaip įvesties nepriima (dėmesio svorių) matricos, o tenzorių su keturiomis ašimis, leidžiantį turėti skirtingų užklausų ir svorių masyvą. Todėl įvestis matrices turi formą (rodomų eilučių skaičius, rodomų stulpelių skaičius, užklausų skaičius, raktų skaičius). Tai pravers vėliau, kai norėsime vizualizuoti veikimą, kurį projektuojame transformeriams.
#@save
def show_heatmaps(matrices, xlabel, ylabel, titles=None, figsize=(2.5, 2.5),
                  cmap='Reds'):
    """Show heatmaps of matrices."""
    d2l.use_svg_display()
    num_rows, num_cols, _, _ = matrices.shape
    fig, axes = d2l.plt.subplots(num_rows, num_cols, figsize=figsize,
                                 sharex=True, sharey=True, squeeze=False)
    for i, (row_axes, row_matrices) in enumerate(zip(axes, matrices)):
        for j, (ax, matrix) in enumerate(zip(row_axes, row_matrices)):
            if tab.selected('pytorch', 'mxnet', 'tensorflow'):
                pcm = ax.imshow(d2l.numpy(matrix), cmap=cmap)
            if tab.selected('jax'):
                pcm = ax.imshow(matrix, cmap=cmap)
            if i == num_rows - 1:
                ax.set_xlabel(xlabel)
            if j == 0:
                ax.set_ylabel(ylabel)
            if titles:
                ax.set_title(titles[j])
    fig.colorbar(pcm, ax=axes, shrink=0.6);
Kaip trumpas patikrinimas vizualizuokime vienetinę matricą, vaizduojančią atvejį, kai dėmesio svoris yra tik tada, kai užklausa ir raktas yra tas pats.
attention_weights = d2l.reshape(d2l.eye(10), (1, 1, 10, 10))
show_heatmaps(attention_weights, xlabel='Keys', ylabel='Queries')
11.1.2 Santrauka
Dėmesio sutelkimo mechanizmas leidžia mums agreguoti duomenis iš daugelio (raktas, reikšmė) porų. Iki šiol mūsų diskusija buvo gana abstrakti, tiesiog aprašanti duomenų sutelkimo būdą. Dar nepaaiškinome, iš kur gali atsirasti tos paslaptingos užklausos, raktai ir reikšmės. Kai kuri intuicija čia gali padėti: pavyzdžiui, regresijos nuostatoje užklausa gali atitikti vietą, kurioje turėtų būti atliekama regresija. Raktai yra vietos, kuriose buvo stebimi ankstesni duomenys, o reikšmės yra pačios (regresijos) reikšmės. Tai vadinamasis Nadaraya–Watsono įvertis (Nadaraya, 1964; Watson, 1964), kurį nagrinėsime kitame skyrelyje.
Pagal dizainą dėmesio sutelkimo mechanizmas suteikia diferencijuojamą valdymo būdą, kuriuo neuroninis tinklas gali pasirinkti elementus iš aibės ir sudaryti susijusią vaizdų svertinę sumą.
11.1.3 Pratimai
- Tarkime, norėtumėte iš naujo įgyvendinti apytikslius (raktas, užklausa) atitikmenis, naudojamus klasikinėse duomenų bazėse; kokią dėmesio funkciją pasirinktumėte?
- Tarkime, kad dėmesio funkcija yra ir kad , kai . Pažymėkime raktų tikimybių skirstinį, naudojant softmax normalizaciją (11.1.2). Įrodykite, kad .
- Suprojektuokite diferencijuojamą paieškos variklį naudodami dėmesio sutelkimo mechanizmą.
- Peržiūrėkite „Squeeze and Excitation“ tinklų dizainą (Hu ir kt., 2018) ir interpretuokite juos per dėmesio sutelkimo mechanizmo prizmę.