
5.3 Tiesioginis sklidimas, atgalinis sklidimas ir skaičiavimo grafai
Iki šiol savo modelius apmokėme minirinkinio stochastiniu gradientiniu nusileidimu. Tačiau įgyvendindami algoritmą, rūpinomės tik skaičiavimais, susijusiais su tiesioginiu sklidimu per modelį. Kai atėjo laikas apskaičiuoti gradientus, tiesiog iškvietėme atgalinio sklidimo funkciją, kurią suteikia giliojo mokymosi karkasas.
Automatinis gradientų skaičiavimas iš esmės supaprastina giliojo mokymosi algoritmų įgyvendinimą. Prieš atsirandant automatiniam diferencijavimui, net nedideli sudėtingų modelių pakeitimai reikalavo rankomis perskaičiuoti sudėtingas išvestines. Stebėtinai dažnai moksliniuose straipsniuose tekdavo skirti daugybę puslapių atnaujinimo taisyklėms išvesti. Nors turime ir toliau remtis automatiniu diferencijavimu, kad galėtume susitelkti į įdomiąsias dalis, turėtumėte žinoti, kaip šie gradientai apskaičiuojami „po gaubtu“, jei norite peržengti paviršutinišką giliojo mokymosi supratimą.
Šiame skyrelyje gilinamės į atgalinio sklidimo (dažniau vadinamo atgaliniu skleidimu) detales. Kad suteiktume įžvalgų apie metodus ir jų įgyvendinimą, remiamės elementaria matematika ir skaičiavimo grafais. Pradžioje savo pateikimą sutelkiame į vieno paslėptojo sluoksnio MLP su svorių nykimu ( reguliarizavimu, kuris bus aprašytas tolesniuose skyriuose).
5.3.1 Tiesioginis sklidimas
Tiesioginis sklidimas (arba tiesioginis praėjimas) reiškia tarpinių kintamųjų (įskaitant išvestis) skaičiavimą ir saugojimą neuroniniam tinklui iš eilės nuo įvesties sluoksnio iki išvesties sluoksnio. Dabar žingsnis po žingsnio išnagrinėsime neuroninio tinklo su vienu paslėptuoju sluoksniu mechaniką. Tai gali pasirodyti nuobodu, bet pagal funko virtuozo Jameso Browno amžinuosius žodžius, turite „sumokėti kainą, kad taptumėte bosu“.
Paprastumo dėlei tarkime, kad įvesties pavyzdys yra , o mūsų paslėptasis sluoksnis neturi poslinkio nario. Čia tarpinis kintamasis yra:
kur yra paslėptojo sluoksnio svorių parametras. Praleidę tarpinį kintamąjį per aktyvacijos funkciją , gauname savo paslėptųjų aktyvacijų vektorių, kurio ilgis :
Paslėptojo sluoksnio išvestis taip pat yra tarpinis kintamasis. Tarkime, kad išvesties sluoksnio parametrai turi tik svorį , tada galime gauti išvesties sluoksnio kintamąjį, kuris yra ilgio vektorius:
Tarkime, kad nuostolių funkcija yra , o pavyzdžio žymuo yra , tada galime apskaičiuoti nuostolių narį vienam duomenų pavyzdžiui:
Kaip pamatysime iš vėliau pristatomo reguliarizavimo apibrėžimo, turint hiperparametrą , reguliarizavimo narys yra
kur matricos Frobenijaus norma yra tiesiog norma, pritaikyta suplokštinus matricą į vektorių. Galiausiai modelio reguliarizuoti nuostoliai duotam duomenų pavyzdžiui yra:
Toliau diskusijoje vadinsime tikslo funkcija.
5.3.2 Tiesioginio sklidimo skaičiavimo grafas
Skaičiavimo grafų braižymas padeda vizualizuoti operatorių ir kintamųjų priklausomybes skaičiavimo viduje. 5.3.1 pav. pateiktas grafas, susijęs su aukščiau aprašytu paprastu tinklu, kuriame kvadratai žymi kintamuosius, o apskritimai – operatorius. Apatinis kairysis kampas žymi įvestį, o viršutinis dešinysis – išvestį. Atkreipkite dėmesį, kad rodyklių kryptys (iliustruojančios duomenų srautą) daugiausia yra į dešinę ir aukštyn.
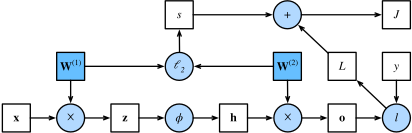
5.3.1 pav. Tiesioginio sklidimo skaičiavimo grafas.
5.3.3 Atgalinis sklidimas
Atgalinis sklidimas reiškia neuroninio tinklo parametrų gradiento skaičiavimo metodą. Trumpai tariant, metodas apeina tinklą atvirkštine tvarka, nuo išvesties iki įvesties sluoksnio, pagal grandinės taisyklę iš matematinės analizės. Algoritmas saugo bet kuriuos tarpinius kintamuosius (dalines išvestines), reikalingus skaičiuojant gradientą kokių nors parametrų atžvilgiu. Tarkime, kad turime funkcijas ir , kuriose įvestis ir išvestis yra savavališkų formų tenzoriai. Naudodami grandinės taisyklę, galime apskaičiuoti išvestinę atžvilgiu pagal
Čia naudojame operatorių , kad sudaugintume jo argumentus atlikus reikiamas operacijas, tokias kaip transponavimas ir įvesties pozicijų sukeitimas. Vektoriams tai paprasta: tai tiesiog matricų daugyba. Aukštesnių dimensijų tenzoriams naudojame atitinkamą analogą. Operatorius paslepia visą žymėjimo naštą.
Prisiminkite, kad paprasto tinklo su vienu paslėptuoju sluoksniu, kurio skaičiavimo grafas pateiktas 5.3.1 pav., parametrai yra ir . Atgalinio sklidimo tikslas yra apskaičiuoti gradientus ir . Tam taikome grandinės taisyklę ir paeiliui skaičiuojame kiekvieno tarpinio kintamojo ir parametro gradientą. Skaičiavimų tvarka yra atvirkštinė nei atliekama tiesioginio sklidimo metu, nes turime pradėti nuo skaičiavimo grafo rezultato ir judėti link parametrų. Pirmasis žingsnis yra apskaičiuoti tikslo funkcijos gradientus nuostolių nario ir reguliarizavimo nario atžvilgiu:
Toliau, pagal grandinės taisyklę, apskaičiuojame tikslo funkcijos gradientą išvesties sluoksnio kintamojo atžvilgiu:
Toliau apskaičiuojame reguliarizavimo nario gradientus abiejų parametrų atžvilgiu:
Dabar galime apskaičiuoti arčiausiai išvesties sluoksnio esančių modelio parametrų gradientą . Naudodami grandinės taisyklę gauname:
Kad gautume gradientą atžvilgiu, turime tęsti atgalinį sklidimą nuo išvesties sluoksnio iki paslėptojo sluoksnio. Gradientas paslėptojo sluoksnio išvesties atžvilgiu yra
Kadangi aktyvacijos funkcija taikoma elementas po elemento, tarpinio kintamojo gradiento skaičiavimui reikia naudoti elementų daugybos operatorių, kurį žymime :
Galiausiai galime gauti arčiausiai įvesties sluoksnio esančių modelio parametrų gradientą . Pagal grandinės taisyklę gauname
5.3.4 Neuroninių tinklų apmokymas
Apmokant neuroninius tinklus, tiesioginis ir atgalinis sklidimai priklauso vienas nuo kito. Visų pirma, tiesioginio sklidimo metu apeiname skaičiavimo grafą priklausomybių kryptimi ir apskaičiuojame visus kintamuosius jo kelyje. Jie vėliau naudojami atgaliniam sklidimui, kai skaičiavimo tvarka grafe apverčiama.
Kaip iliustracinį pavyzdį paimkime minėtą paprastą tinklą. Viena vertus, reguliarizavimo nario (5.3.1) skaičiavimas tiesioginio sklidimo metu priklauso nuo dabartinių modelio parametrų ir reikšmių. Jas pateikia optimizavimo algoritmas pagal atgalinį sklidimą paskutinėje iteracijoje. Kita vertus, parametro gradiento skaičiavimas (5.3.2) atgalinio sklidimo metu priklauso nuo dabartinės paslėptojo sluoksnio išvesties reikšmės, kurią pateikia tiesioginis sklidimas.
Todėl apmokant neuroninius tinklus, kai tik modelio parametrai inicializuoti, kaitaliojame tiesioginį sklidimą su atgaliniu sklidimu, atnaujindami modelio parametrus naudodami gradientus, gautus atgalinio sklidimo metu. Atkreipkite dėmesį, kad atgalinis sklidimas pakartotinai naudoja išsaugotas tarpines reikšmes iš tiesioginio sklidimo, kad išvengtų dubliuotų skaičiavimų. Viena iš pasekmių yra ta, kad turime išlaikyti tarpines reikšmes, kol atgalinis sklidimas bus baigtas. Tai taip pat viena iš priežasčių, kodėl apmokymui reikia gerokai daugiau atminties nei paprastai prognozei. Be to, tokių tarpinių reikšmių dydis yra maždaug proporcingas tinklo sluoksnių skaičiui ir paketo dydžiui. Todėl apmokant gilesnius tinklus su didesniais paketų dydžiais lengviau susiduriama su atminties trūkumo klaidomis.
5.3.5 Santrauka
Tiesioginis sklidimas nuosekliai apskaičiuoja ir saugo tarpinius kintamuosius neuroninio tinklo apibrėžtame skaičiavimo grafe. Jis vyksta nuo įvesties iki išvesties sluoksnio. Atgalinis sklidimas nuosekliai apskaičiuoja ir saugo tarpinių kintamųjų ir parametrų gradientus neuroniniame tinkle atvirkštine tvarka. Apmokant giliojo mokymosi modelius, tiesioginis ir atgalinis sklidimai yra tarpusavyje priklausomi, o apmokymui reikia gerokai daugiau atminties nei prognozei.
5.3.6 Pratimai
- Tarkime, kad kokios nors skaliarinės funkcijos įvestys yra matricos. Kokia yra gradiento atžvilgiu dimensija?
- Pridėkite poslinkį prie šiame skyrelyje aprašyto modelio paslėptojo sluoksnio (poslinkio į reguliarizavimo narį įtraukti nereikia).
- Nubraižykite atitinkamą skaičiavimo grafą.
- Išveskite tiesioginio ir atgalinio sklidimo lygtis.
- Apskaičiuokite atminties apimtį apmokymui ir prognozei šiame skyrelyje aprašytame modelyje.
- Tarkime, kad norite apskaičiuoti antrąsias išvestines. Kas nutinka skaičiavimo grafui? Kiek laiko tikitės, kad užtruks skaičiavimas?
- Tarkime, kad skaičiavimo grafas per didelis jūsų GPU.
- Ar galite jį išskaidyti per daugiau nei vieną GPU?
- Kokie pranašumai ir trūkumai, palyginti su apmokymu mažesniu minirinkiniu?