
5.1 Daugiasluoksniai perceptronai
4.1 skyrelis pristatėme softmax regresiją, įgyvendindami algoritmą nuo nulio (4.4 skyrelis) ir naudodami aukšto lygio API (4.5 skyrelis). Tai leido mums apmokyti klasifikatorius, gebančius atpažinti 10 drabužių kategorijų iš mažos skyros vaizdų. Šio proceso metu išmokome tvarkyti duomenis, versti savo išvestis į tinkamą tikimybių skirstinį, taikyti tinkamą nuostolių funkciją ir minimizuoti ją pagal savo modelio parametrus. Dabar, kai įvaldėme šią mechaniką paprastų tiesinių modelių kontekste, galime pradėti giliųjų neuroninių tinklų tyrinėjimą – palyginti turtingos modelių klasės, kuriai ir skirta ši knyga.
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, np, npx
npx.set_np()
%matplotlib inline
from d2l import torch as d2l
import torch
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
%matplotlib inline
from d2l import jax as d2l
import jax
from jax import numpy as jnp
from jax import grad, vmap
5.1.1 Paslėptieji sluoksniai
Afinines transformacijas 3.1.1.1 skyrelis aprašėme kaip tiesines transformacijas su pridėtu poslinkiu. Pradėkime prisimindami modelio architektūrą, atitinkančią mūsų softmax regresijos pavyzdį, pavaizduotą 4.1.1 pav.. Šis modelis atvaizduoja įvestis tiesiogiai į išvestis per vieną afininę transformaciją, po kurios seka softmax operacija. Jei mūsų žymenys iš tiesų būtų susiję su įvesties duomenimis paprasta afinine transformacija, tada šio metodo pakaktų. Tačiau tiesiškumas (afininėse transformacijose) yra stipri prielaida.
5.1.1.1 Tiesinių modelių apribojimai
Pavyzdžiui, tiesiškumas reiškia silpnesnę monotoniškumo prielaidą, t. y. kad bet koks mūsų požymio padidėjimas turi arba visada sukelti modelio išvesties padidėjimą (jei atitinkamas svoris teigiamas), arba visada sukelti modelio išvesties sumažėjimą (jei atitinkamas svoris neigiamas). Kartais tai prasminga. Pavyzdžiui, jei bandytume prognozuoti, ar asmuo grąžins paskolą, galėtume pagrįstai manyti, kad kitiems dalykams esant vienodiems, didesnes pajamas gaunantis pareiškėjas visada labiau tikėtinai grąžins, nei gaunantis mažesnes pajamas. Nors tai monotoniška, šis ryšys greičiausiai nėra tiesiškai susijęs su grąžinimo tikimybe. Pajamų padidėjimas nuo $0 iki $50 000 greičiausiai atitinka didesnį grąžinimo tikimybės padidėjimą nei padidėjimas nuo $1 milijono iki $1,05 milijono. Vienas būdas tai išspręsti galėtų būti rezultato paskesnis apdorojimas, kad tiesiškumas taptų labiau tikėtinas, naudojant logistinį atvaizdį (taigi ir rezultato tikimybės logaritmą).
Atkreipkite dėmesį, kad lengvai galime sugalvoti pavyzdžių, pažeidžiančių monotoniškumą. Tarkime, pavyzdžiui, kad norime prognozuoti sveikatą kaip kūno temperatūros funkciją. Asmenims, kurių normali kūno temperatūra yra aukščiau 37 °C (98,6 °F), aukštesnė temperatūra rodo didesnę riziką. Tačiau jei kūno temperatūra nukrenta žemiau 37 °C, žemesnė temperatūra rodo didesnę riziką! Vėlgi, problemą galėtume išspręsti kokiu nors gudriu išankstiniu apdorojimu, pavyzdžiui, naudodami atstumą nuo 37 °C kaip požymį.
O kaip klasifikuoti kačių ir šunų vaizdus? Ar pikselio vietoje (13, 17) intensyvumo didinimas visada turėtų didinti (arba visada mažinti) tikimybę, kad vaizde pavaizduotas šuo? Pasikliovimas tiesiniu modeliu atitinka numanomą prielaidą, kad vienintelis reikalavimas katėms ir šunims atskirti yra įvertinti atskirų pikselių ryškumą. Šis metodas pasmerktas nesėkmei pasaulyje, kuriame vaizdo invertavimas išsaugo kategoriją.
Ir vis dėlto, nepaisant akivaizdaus tiesiškumo absurdiškumo čia, palyginti su ankstesniais pavyzdžiais, mažiau akivaizdu, ar galėtume spręsti problemą paprastu išankstinio apdorojimo pataisymu. Taip yra todėl, kad bet kurio pikselio reikšmingumas sudėtingais būdais priklauso nuo jo konteksto (aplinkinių pikselių reikšmių). Nors gali egzistuoti mūsų duomenų atvaizdas, kuris atsižvelgtų į svarbias sąveikas tarp mūsų požymių ir kuriame tiesinis modelis būtų tinkamas, mes tiesiog nežinome, kaip jį apskaičiuoti rankomis. Su giliaisiais neuroniniais tinklais naudojome stebėjimo duomenis, kad kartu išmoktume ir atvaizdą per paslėptuosius sluoksnius, ir tiesinį prognozuotoją, veikiantį pagal tą atvaizdą.
Ši netiesiškumo problema nagrinėjama bent jau šimtmetį (Fisher, 1925). Pavyzdžiui, sprendimų medžiai pačia paprasčiausia forma naudoja dvejetainių sprendimų seką, kad nuspręstų dėl priklausymo klasei (Quinlan, 1993). Panašiai branduolių metodai jau daugelį dešimtmečių naudojami netiesinėms priklausomybėms modeliuoti (Aronszajn, 1950). Tai rado kelią į neparametrinius splainų modelius (Wahba, 1990) ir branduolių metodus (Scholkopf ir Smola, 2002). Tai taip pat yra tai, ką smegenys sprendžia visiškai natūraliai. Juk neuronai maitina kitus neuronus, kurie, savo ruožtu, vėl maitina kitus neuronus (Ramon y Cajal ir Azoulay, 1894). Todėl turime santykinai paprastų transformacijų seką.
5.1.1.2 Paslėptųjų sluoksnių įtraukimas
Tiesinių modelių apribojimus galime įveikti įtraukdami vieną ar kelis paslėptuosius sluoksnius. Lengviausias būdas tai padaryti yra sukrauti daug pilnai sujungtų sluoksnių vieną ant kito. Kiekvienas sluoksnis maitina aukščiau esantį sluoksnį, kol sugeneruojame išvestis. Pirmuosius sluoksnius galime laikyti savo atvaizdu, o paskutinį sluoksnį – savo tiesiniu prognozuotoju. Ši architektūra paprastai vadinama daugiasluoksniu perceptronu, dažnai sutrumpintai MLP (5.1.1 pav.).
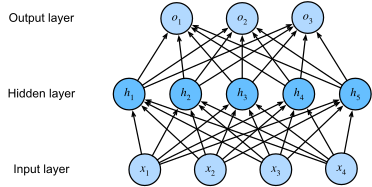
5.1.1 pav. MLP su paslėptuoju sluoksniu iš penkių paslėptųjų vienetų.
Šis MLP turi keturias įvestis, tris išvestis, o jo paslėptajame sluoksnyje yra penki paslėptieji vienetai. Kadangi įvesties sluoksnis neatlieka jokių skaičiavimų, išvestims šiuo tinklu gauti reikia įgyvendinti skaičiavimus ir paslėptajam, ir išvesties sluoksniams; todėl šio MLP sluoksnių skaičius yra du. Atkreipkite dėmesį, kad abu sluoksniai yra pilnai sujungti. Kiekviena įvestis veikia kiekvieną paslėptojo sluoksnio neuroną, o kiekvienas iš jų, savo ruožtu, veikia kiekvieną išvesties sluoksnio neuroną. Deja, dar nesame visai baigę.
5.1.1.3 Nuo tiesinio iki netiesinio
Kaip ir anksčiau, matrica žymime pavyzdžių minirinkinį, kur kiekvienas pavyzdys turi įvesčių (požymių). Vieno paslėptojo sluoksnio MLP, kurio paslėptasis sluoksnis turi paslėptųjų vienetų, paslėptojo sluoksnio išvestis žymime , kurios yra paslėptieji atvaizdai. Kadangi paslėptasis ir išvesties sluoksniai yra pilnai sujungti, turime paslėptojo sluoksnio svorius ir poslinkius bei išvesties sluoksnio svorius ir poslinkius . Tai leidžia mums apskaičiuoti vieno paslėptojo sluoksnio MLP išvestis taip:
Atkreipkite dėmesį, kad pridėjus paslėptąjį sluoksnį, mūsų modeliui dabar reikia sekti ir atnaujinti papildomas parametrų aibes. Taigi ką gavome mainais? Galbūt nustebsite sužinoję, kad – aukščiau apibrėžtame modelyje – nieko negavome už savo vargus! Priežastis aiški. Aukščiau esantys paslėptieji vienetai gaunami afinine įvesčių funkcija, o išvestys (prieš softmax) yra tiesiog afininė paslėptųjų vienetų funkcija. Afininė afininės funkcijos funkcija pati yra afininė funkcija. Be to, mūsų tiesinis modelis jau galėjo atvaizduoti bet kurią afininę funkciją.
Kad tai pamatytume formaliai, galime tiesiog suskleisti paslėptąjį sluoksnį aukščiau pateiktame apibrėžime, gaudami ekvivalentų vieno sluoksnio modelį su parametrais ir :
Kad realizuotume daugiasluoksnių architektūrų potencialą, mums reikia dar vieno esminio ingrediento: netiesinės aktyvacijos funkcijos , taikomos kiekvienam paslėptajam vienetui po afininės transformacijos. Pavyzdžiui, populiarus pasirinkimas yra ReLU (angl. rectified linear unit, tiesinis lygintuvas) aktyvacijos funkcija (Nair ir Hinton, 2010) , veikianti savo argumentus elementas po elemento. Aktyvacijos funkcijų išvestys vadinamos aktyvacijomis. Apskritai, esant aktyvacijos funkcijoms, nebegalima suskleisti mūsų MLP į tiesinį modelį:
Kadangi kiekviena eilutė atitinka minirinkinio pavyzdį, šiek tiek laisvai vartodami žymėjimą, apibrėžiame netiesiškumą taip, kad jis būtų taikomas savo įvestims eilutėmis, t. y. po vieną pavyzdį vienu metu. Atkreipkite dėmesį, kad tą patį žymėjimą naudojome softmax, kai žymėjome eilutėmis atliekamą operaciją 4.1.1.3 skyrelis. Gana dažnai mūsų naudojamos aktyvacijos funkcijos taikomos ne tik eilutėmis, bet ir elementas po elemento. Tai reiškia, kad apskaičiavę tiesinę sluoksnio dalį, galime apskaičiuoti kiekvieną aktyvaciją, nežiūrėdami į kitų paslėptųjų vienetų įgyjamas reikšmes.
Kad sukurtume bendresnius MLP, galime toliau krauti tokius paslėptuosius sluoksnius, pvz., ir , vieną ant kito, gaudami vis raiškesnius modelius.
5.1.1.4 Universalieji aproksimatoriai
Žinome, kad smegenys geba atlikti labai sudėtingą statistinę analizę. Todėl verta paklausti, kokio galingumo gali būti gilusis tinklas. Į šį klausimą buvo atsakyta ne kartą, pvz., (Cybenko, 1989) MLP kontekste ir (Micchelli, 1984) atkuriančiojo branduolio Hilberto erdvių kontekste, kurį galima laikyti radialinių bazinių funkcijų (RBF) tinklais su vienu paslėptuoju sluoksniu. Šie (ir susiję) rezultatai rodo, kad net su vieno paslėptojo sluoksnio tinklu, turint pakankamai mazgų (galbūt absurdiškai daug) ir tinkamą svorių rinkinį, galime modeliuoti bet kurią funkciją. Tačiau iš tiesų išmokti tą funkciją yra sunkioji dalis. Savo neuroninį tinklą galite įsivaizduoti šiek tiek kaip programavimo kalbą C. Ši kalba, kaip ir bet kuri kita šiuolaikinė kalba, geba išreikšti bet kurią apskaičiuojamą programą. Bet iš tiesų sugalvoti programą, atitinkančią jūsų specifikacijas, yra sunkioji dalis.
Be to, tai, kad vieno paslėptojo sluoksnio tinklas gali išmokti bet kurią funkciją, nereiškia, kad turėtumėte bandyti išspręsti visas savo problemas su tokiu tinklu. Tiesą sakant, šiuo atveju branduolių metodai yra gerokai efektyvesni, nes jie geba išspręsti problemą tiksliai net begalinės dimensijos erdvėse (G.~S.~Kimeldorf ir G.~Wahba, ; B.~Scholkopf ir kt., ). Iš tikrųjų daugelį funkcijų galime aproksimuoti daug kompaktiškiau naudodami gilesnius (o ne platesnius) tinklus (Simonyan ir Zisserman, 2014). Prie griežtesnių argumentų grįšime tolesniuose skyriuose.
5.1.2 Aktyvacijos funkcijos
Aktyvacijos funkcijos nusprendžia, ar neuronas turėtų būti aktyvuotas, ar ne, apskaičiuodamos svertinę sumą ir prie jos pridėdamos poslinkį. Tai diferencijuojami operatoriai, transformuojantys įvesties signalus į išvestis, o dauguma jų prideda netiesiškumo. Kadangi aktyvacijos funkcijos yra fundamentalios giliajam mokymuisi, (trumpai apžvelkime kai kurias dažniausias).
5.1.2.1 ReLU funkcija
Populiariausias pasirinkimas, dėl įgyvendinimo paprastumo ir gero veikimo įvairiose prognozavimo užduotyse, yra tiesinis lygintuvas (angl. rectified linear unit, ReLU) (Nair ir Hinton, 2010). ReLU suteikia labai paprastą netiesinę transformaciją. Turint elementą , funkcija apibrėžiama kaip to elemento ir maksimumas:
Neformaliai ReLU funkcija išsaugo tik teigiamus elementus ir atmeta visus neigiamus elementus, nustatydama atitinkamas aktyvacijas lygias 0. Kad įgytume šiek tiek intuicijos, galime nubraižyti funkciją. Kaip matote, aktyvacijos funkcija yra dalimis tiesinė.
x = np.arange(-8.0, 8.0, 0.1)
x.attach_grad()
with autograd.record():
    y = npx.relu(x)
d2l.plot(x, y, 'x', 'relu(x)', figsize=(5, 2.5))
x = torch.arange(-8.0, 8.0, 0.1, requires_grad=True)
y = torch.relu(x)
d2l.plot(x.detach(), y.detach(), 'x', 'relu(x)', figsize=(5, 2.5))
x = tf.Variable(tf.range(-8.0, 8.0, 0.1), dtype=tf.float32)
y = tf.nn.relu(x)
d2l.plot(x.numpy(), y.numpy(), 'x', 'relu(x)', figsize=(5, 2.5))
x = jnp.arange(-8.0, 8.0, 0.1)
y = jax.nn.relu(x)
d2l.plot(x, y, 'x', 'relu(x)', figsize=(5, 2.5))
Kai įvestis neigiama, ReLU funkcijos išvestinė yra 0, o kai įvestis teigiama, ReLU funkcijos išvestinė yra 1. Atkreipkite dėmesį, kad ReLU funkcija nėra diferencijuojama, kai įvestis įgyja reikšmę tiksliai lygią 0. Tokiais atvejais numatytuoju laikome kairiąją išvestinę ir sakome, kad išvestinė yra 0, kai įvestis yra 0. Tai galime padaryti, nes įvestis gali niekada nebūti lygi nuliui (matematikai sakytų, kad ji nediferencijuojama nulinio mato aibėje). Yra sena patarlė, kad jei svarbios subtilios ribinės sąlygos, tikriausiai užsiimame (tikrąja) matematika, o ne inžinerija. Ši įprasta išmintis gali būti taikoma čia, arba bent jau tai, kad neatliekame apribotojo optimizavimo (O.~L.~Mangasarian, ; R.~T.~Rockafellar, ). Žemiau nubraižome ReLU funkcijos išvestinę.
y.backward()
d2l.plot(x, x.grad, 'x', 'grad of relu', figsize=(5, 2.5))
y.backward(torch.ones_like(x), retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of relu', figsize=(5, 2.5))
with tf.GradientTape() as t:
    y = tf.nn.relu(x)
d2l.plot(x.numpy(), t.gradient(y, x).numpy(), 'x', 'grad of relu',
         figsize=(5, 2.5))
grad_relu = vmap(grad(jax.nn.relu))
d2l.plot(x, grad_relu(x), 'x', 'grad of relu', figsize=(5, 2.5))
ReLU naudojimo priežastis yra ta, kad jos išvestinės yra ypač gerai elgiasi: jos arba išnyksta, arba tiesiog praleidžia argumentą. Dėl to optimizavimas elgiasi geriau, ir tai sušvelnino gerai dokumentuotą nykstančių gradientų problemą, kuri kamavo ankstesnes neuroninių tinklų versijas (apie tai vėliau).
Atkreipkite dėmesį, kad yra daug ReLU funkcijos variantų, įskaitant parametrizuotą ReLU (pReLU) funkciją (He ir kt., 2015). Šis variantas prideda tiesinį narį prie ReLU, todėl šiek tiek informacijos vis tiek praeina, net kai argumentas neigiamas:
5.1.2.2 Sigmoidinė funkcija
Sigmoidinė funkcija transformuoja tas įvestis, kurių reikšmės yra srityje , (į išvestis, esančias intervale (0, 1).) Dėl šios priežasties sigmoidinė funkcija dažnai vadinama spaudimo funkcija: ji suspaudžia bet kurią įvestį diapazone (-inf, inf) į kokią nors reikšmę diapazone (0, 1):
Ankstyviausiuose neuroniniuose tinkluose mokslininkai domėjosi biologinių neuronų, kurie arba šauna, arba nešauna, modeliavimu. Todėl šios srities pradininkai, siekiantys net McCullocho ir Pittso, dirbtinio neurono išradėjų, sutelkė dėmesį į slenkstinius vienetus (McCulloch ir Pitts, 1943). Slenkstinė aktyvacija įgyja reikšmę 0, kai jos įvestis yra žemiau tam tikro slenksčio, ir reikšmę 1, kai įvestis viršija slenkstį.
Kai dėmesys persikėlė į gradientinį mokymąsi, sigmoidinė funkcija buvo natūralus pasirinkimas, nes ji yra glotni, diferencijuojama slenkstinio vieneto aproksimacija. Sigmoidinės funkcijos vis dar plačiai naudojamos kaip aktyvacijos funkcijos išvesties vienetuose, kai norime interpretuoti išvestis kaip tikimybes dvejetainio klasifikavimo uždaviniuose: sigmoidinę funkciją galite laikyti atskiru softmax atveju. Tačiau sigmoidinę funkciją daugiausia pakeitė paprastesnė ir lengviau apmokoma ReLU, daugumai naudojimų paslėptuosiuose sluoksniuose. Tai daugiausia susiję su tuo, kad sigmoidinė funkcija kelia iššūkių optimizavimui (LeCun ir kt., 1998), nes jos gradientas išnyksta didelėms teigiamoms ir neigiamoms argumentų reikšmėms. Tai gali sukelti plynaukštes, iš kurių sunku išsivaduoti. Vis dėlto sigmoidinės funkcijos yra svarbios. Vėlesniuose skyriuose (pvz., 10.1 skyrelis) apie rekurentinius neuroninius tinklus aprašysime architektūras, naudojančias sigmoidinius vienetus informacijos srautui per laiką valdyti.
Žemiau nubraižome sigmoidinę funkciją. Atkreipkite dėmesį, kad kai įvestis artima 0, sigmoidinė funkcija artėja prie tiesinės transformacijos.
with autograd.record():
    y = npx.sigmoid(x)
d2l.plot(x, y, 'x', 'sigmoid(x)', figsize=(5, 2.5))
y = torch.sigmoid(x)
d2l.plot(x.detach(), y.detach(), 'x', 'sigmoid(x)', figsize=(5, 2.5))
y = tf.nn.sigmoid(x)
d2l.plot(x.numpy(), y.numpy(), 'x', 'sigmoid(x)', figsize=(5, 2.5))
y = jax.nn.sigmoid(x)
d2l.plot(x, y, 'x', 'sigmoid(x)', figsize=(5, 2.5))
Sigmoidinės funkcijos išvestinė duodama šia lygtimi:
Sigmoidinės funkcijos išvestinė nubraižyta žemiau. Atkreipkite dėmesį, kad kai įvestis yra 0, sigmoidinės funkcijos išvestinė pasiekia didžiausią reikšmę 0,25. Kai įvestis tolsta nuo 0 bet kuria kryptimi, išvestinė artėja prie 0.
y.backward()
d2l.plot(x, x.grad, 'x', 'grad of sigmoid', figsize=(5, 2.5))
# Clear out previous gradients
x.grad.data.zero_()
y.backward(torch.ones_like(x),retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of sigmoid', figsize=(5, 2.5))
with tf.GradientTape() as t:
    y = tf.nn.sigmoid(x)
d2l.plot(x.numpy(), t.gradient(y, x).numpy(), 'x', 'grad of sigmoid',
         figsize=(5, 2.5))
grad_sigmoid = vmap(grad(jax.nn.sigmoid))
d2l.plot(x, grad_sigmoid(x), 'x', 'grad of sigmoid', figsize=(5, 2.5))
5.1.2.3 Tanh funkcija
Kaip ir sigmoidinė funkcija, tanh (hiperbolinio tangento) funkcija taip pat suspaudžia savo įvestis, paversdama jas elementais intervale (tarp ir ):
Žemiau nubraižome tanh funkciją. Atkreipkite dėmesį, kad kai įvestis artėja prie 0, tanh funkcija artėja prie tiesinės transformacijos. Nors funkcijos forma panaši į sigmoidinės funkcijos, tanh funkcija pasižymi taškine simetrija koordinačių sistemos pradžios atžvilgiu (Kalman ir Kwasny, 1992).
with autograd.record():
    y = np.tanh(x)
d2l.plot(x, y, 'x', 'tanh(x)', figsize=(5, 2.5))
y = torch.tanh(x)
d2l.plot(x.detach(), y.detach(), 'x', 'tanh(x)', figsize=(5, 2.5))
y = tf.nn.tanh(x)
d2l.plot(x.numpy(), y.numpy(), 'x', 'tanh(x)', figsize=(5, 2.5))
y = jax.nn.tanh(x)
d2l.plot(x, y, 'x', 'tanh(x)', figsize=(5, 2.5))
Tanh funkcijos išvestinė yra:
Ji nubraižyta žemiau. Kai įvestis artėja prie 0, tanh funkcijos išvestinė artėja prie didžiausios reikšmės 1. Ir kaip matėme su sigmoidine funkcija, kai įvestis tolsta nuo 0 bet kuria kryptimi, tanh funkcijos išvestinė artėja prie 0.
y.backward()
d2l.plot(x, x.grad, 'x', 'grad of tanh', figsize=(5, 2.5))
# Clear out previous gradients
x.grad.data.zero_()
y.backward(torch.ones_like(x),retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of tanh', figsize=(5, 2.5))
with tf.GradientTape() as t:
    y = tf.nn.tanh(x)
d2l.plot(x.numpy(), t.gradient(y, x).numpy(), 'x', 'grad of tanh',
         figsize=(5, 2.5))
grad_tanh = vmap(grad(jax.nn.tanh))
d2l.plot(x, grad_tanh(x), 'x', 'grad of tanh', figsize=(5, 2.5))
5.1.3 Santrauka ir diskusija
Dabar žinome, kaip įtraukti netiesiškumus, kad sukurtume raiškias daugiasluoksnes neuroninių tinklų architektūras. Pastebėsime, kad jūsų žinios jau suteikia jums panašų įrankių rinkinį kaip specialistui apie 1990 m. Tam tikrais atžvilgiais turite pranašumą prieš bet ką, dirbusį tada, nes galite pasinaudoti galingais atvirojo kodo giliojo mokymosi karkasais, kad greitai kurtumėte modelius naudodami vos kelias kodo eilutes. Anksčiau šiems tinklams apmokyti tyrėjai turėdavo aiškiai užkoduoti sluoksnius ir išvestines C, Fortran ar net Lisp kalbomis (LeNet atveju).
Antrinė nauda yra ta, kad ReLU yra gerokai geriau pritaikyta optimizavimui nei sigmoidinė ar tanh funkcija. Galima teigti, kad tai buvo viena pagrindinių naujovių, padėjusių giliojo mokymosi atgimimui per pastarąjį dešimtmetį. Tačiau atkreipkite dėmesį, kad aktyvacijos funkcijų tyrimai nesustojo. Pavyzdžiui, GELU (angl. Gaussian error linear unit, Gauso paklaidos tiesinis vienetas) aktyvacijos funkcija , kurią pasiūlė (Hendrycks ir Gimpel, 2016) ( yra standartinė Gauso kaupiamojo skirstinio funkcija), ir Swish aktyvacijos funkcija , pasiūlyta (Ramachandran ir kt., 2017), daugeliu atvejų gali duoti geresnį tikslumą.
5.1.4 Pratimai
- Parodykite, kad sluoksnių pridėjimas prie tiesinio gilaus tinklo, t. y. tinklo be netiesiškumo , niekada negali padidinti tinklo raiškos galios. Pateikite pavyzdį, kai jis aktyviai ją sumažina.
- Apskaičiuokite pReLU aktyvacijos funkcijos išvestinę.
- Apskaičiuokite Swish aktyvacijos funkcijos išvestinę.
- Parodykite, kad MLP, naudojantis tik ReLU (arba pReLU), sukonstruoja tolydžią dalimis tiesinę funkciją.
- Sigmoidinė ir tanh funkcijos yra labai panašios.
- Parodykite, kad .
- Įrodykite, kad abiejų netiesiškumų parametrizuotos funkcijų klasės yra identiškos. Užuomina: afininiai sluoksniai taip pat turi poslinkio narius.
- Tarkime, kad turime netiesiškumą, kuris taikomas vienam minirinkiniui vienu metu, pvz., paketinė normalizacija (Ioffe ir Szegedy, 2015). Kokių problemų tikitės dėl to?
- Pateikite pavyzdį, kai sigmoidinės aktyvacijos funkcijos gradientai išnyksta.