
15.2 Apytikris apmokymas
Prisiminkite mūsų diskusijas 15.1 skyrelis. Pagrindinė skip-gram modelio idėja yra naudoti softmax operacijas, kad būtų apskaičiuota sąlyginė tikimybė generuoti konteksto žodį remiantis duotu centriniu žodžiu (15.1.1), kurios atitinkamas logaritminis nuostolis pateiktas (15.1.2) priešingu dydžiu.
Dėl softmax operacijos prigimties, kadangi konteksto žodis gali būti bet kuris žodyno žodis, (15.1.2) priešingas dydis apima narių sumą, kurios narių skaičius lygus visam žodyno dydžiui. Todėl skip-gram modelio gradiento skaičiavimas (15.1.3) ir nuolatinio žodžių krepšio modelio gradiento skaičiavimas (15.1.5) abu apima šią sumą. Deja, tokių gradientų, sumuojančių per didelį žodyną (dažnai su šimtais tūkstančių ar milijonais žodžių), skaičiavimo sąnaudos yra milžiniškos!
Kad sumažintume minėtą skaičiavimo sudėtingumą, šiame skyrelyje pristatysime du apytikrio apmokymo metodus: neigiamų pavyzdžių atranką ir hierarchinę softmax. Dėl skip-gram modelio ir nuolatinio žodžių krepšio modelio panašumo šiems dviem apytikrio apmokymo metodams aprašyti tiesiog imsime skip-gram modelį kaip pavyzdį.
15.2.1 Neigiamų pavyzdžių atranka
Neigiamų pavyzdžių atranka modifikuoja pradinę tikslo funkciją. Turint centrinio žodžio konteksto langą, faktas, kad bet kuris (konteksto) žodis yra iš šio konteksto lango, laikomas įvykiu, kurio tikimybė modeliuojama
kur naudoja sigmoidinės aktyvinimo funkcijos apibrėžimą:
Pradėkime maksimizuodami bendrąją visų tokių įvykių tikimybę teksto sekose, kad apmokytume žodžių įterpinius. Konkrečiai, turint ilgio teksto seką, pažymėkime žodį laiko žingsnyje , o konteksto lango dydį – ; panagrinėkime bendrosios tikimybės maksimizavimą
Tačiau (15.2.2) nagrinėja tik tuos įvykius, kurie apima teigiamus pavyzdžius. Todėl bendroji tikimybė (15.2.2) maksimizuojama iki 1 tik tada, jei visi žodžių vektoriai yra lygūs begalybei. Žinoma, tokie rezultatai yra beprasmiai. Kad tikslo funkcija taptų prasmingesnė, neigiamų pavyzdžių atranka prideda neigiamų pavyzdžių, atrinktų iš iš anksto apibrėžto pasiskirstymo.
Pažymėkime įvykį, kad konteksto žodis yra iš centrinio žodžio konteksto lango. Šiam įvykiui, apimančiam , iš iš anksto apibrėžto pasiskirstymo atrenkame triukšmo žodžių, kurie nėra iš šio konteksto lango. Pažymėkime įvykį, kad triukšmo žodis () nėra iš konteksto lango. Tarkime, kad šie įvykiai, apimantys ir teigiamą pavyzdį, ir neigiamus pavyzdžius, yra tarpusavyje nepriklausomi. Neigiamų pavyzdžių atranka perrašo bendrąją tikimybę (apimančią tik teigiamus pavyzdžius) (15.2.2) kaip
kur sąlyginė tikimybė aproksimuojama per įvykius :
Pažymėkime ir atitinkamai žodžio laiko žingsnyje teksto sekoje ir triukšmo žodžio indeksus. Logaritminis nuostolis sąlyginių tikimybių (15.2.3) atžvilgiu yra
Matome, kad dabar gradientų skaičiavimo sąnaudos kiekviename apmokymo žingsnyje nieko bendra neturi su žodyno dydžiu, bet tiesiškai priklauso nuo . Kai hiperparametras nustatomas į mažesnę reikšmę, gradientų skaičiavimo sąnaudos kiekviename apmokymo žingsnyje su neigiamų pavyzdžių atranka yra mažesnės.
15.2.2 Hierarchinė softmax
Kaip alternatyvus apytikrio apmokymo metodas, hierarchinė softmax naudoja dvejetainį medį, duomenų struktūrą, iliustruotą 15.2.1 pav., kur kiekvienas medžio lapo mazgas vaizduoja žodyno žodį.
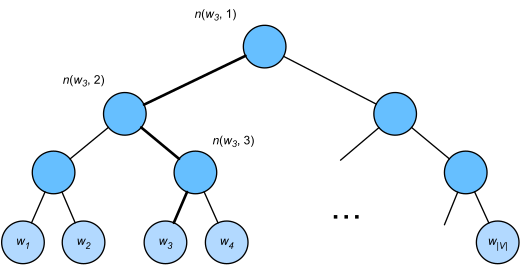
15.2.1 pav. Hierarchinė softmax apytikriam apmokymui, kur kiekvienas medžio lapo mazgas vaizduoja žodyno žodį.
Pažymėkime mazgų (įskaitant abu galus) skaičių kelyje nuo šakninio mazgo iki lapo mazgo, vaizduojančio žodį , dvejetainiame medyje. Tegul yra -asis šio kelio mazgas, kurio konteksto žodžio vektorius yra . Pavyzdžiui, 15.2.1 pav.. Hierarchinė softmax aproksimuoja sąlyginę tikimybę (15.1.1) kaip
kur funkcija apibrėžta (15.2.1), o yra mazgo kairysis vaiko mazgas: jei teisinga, ; kitaip .
Kad iliustruotume, apskaičiuokime sąlyginę tikimybę generuoti žodį turint žodį 15.2.1 pav.. Tam reikia skaliarinių sandaugų tarp žodžio vektoriaus žodžio ir ne lapo mazgų vektorių kelyje (kelias paryškintas 15.2.1 pav.) nuo šaknies iki , kuris einamas kairėn, dešinėn, tada kairėn:
Kadangi , teisinga, kad sąlyginės tikimybės generuoti visus žodyno žodžius remiantis bet kuriuo žodžiu sumuojasi į vienetą:
Laimei, kadangi dėl dvejetainio medžio struktūros yra eilės, kai žodyno dydis yra milžiniškas, kiekvieno apmokymo žingsnio skaičiavimo sąnaudos naudojant hierarchinę softmax yra gerokai sumažintos, palyginti su tomis, kai apytikris apmokymas nenaudojamas.
15.2.3 Santrauka
- Neigiamų pavyzdžių atranka sukonstruoja nuostolių funkciją nagrinėdama tarpusavyje nepriklausomus įvykius, apimančius ir teigiamus, ir neigiamus pavyzdžius. Apmokymo skaičiavimo sąnaudos tiesiškai priklauso nuo triukšmo žodžių skaičiaus kiekviename žingsnyje.
- Hierarchinė softmax sukonstruoja nuostolių funkciją naudodama kelią nuo šakninio mazgo iki lapo mazgo dvejetainiame medyje. Apmokymo skaičiavimo sąnaudos kiekviename žingsnyje priklauso nuo žodyno dydžio logaritmo.
15.2.4 Pratimai
- Kaip galime atrinkti triukšmo žodžius neigiamų pavyzdžių atrankoje?
- Patikrinkite, ar teisinga (15.2.4).
- Kaip apmokyti nuolatinio žodžių krepšio modelį naudojant atitinkamai neigiamų pavyzdžių atranką ir hierarchinę softmax?