
15.1 Žodžių įterpiniai (word2vec)
Natūralioji kalba yra sudėtinga sistema, naudojama reikšmėms reikšti. Šioje sistemoje žodžiai yra pagrindinis reikšmės vienetas. Kaip rodo pavadinimas, žodžių vektoriai yra vektoriai, naudojami žodžiams vaizduoti, ir juos taip pat galima laikyti žodžių požymių vektoriais arba vaizdavimais. Žodžių atvaizdavimo realiaisiais vektoriais technika vadinama žodžių įterpimu (angl. word embedding). Pastaraisiais metais žodžių įterpimas pamažu tapo natūraliosios kalbos apdorojimo pagrindinėmis žiniomis.
15.1.1 Fiktyvūs vektoriai yra prastas pasirinkimas
9.5 skyrelis žodžiams (simboliai yra žodžiai) vaizduoti naudojome fiktyvius vektorius. Tarkime, kad skirtingų žodžių skaičius žodyne (žodyno dydis) yra , o kiekvienas žodis atitinka skirtingą sveikąjį skaičių (indeksą) nuo iki . Kad gautume bet kurio žodžio su indeksu fiktyvaus vektoriaus vaizdavimą, sukuriame ilgio vektorių, sudarytą iš nulių, ir padėties elementą nustatome į 1. Taip kiekvienas žodis vaizduojamas ilgio vektoriumi, ir jį galima tiesiogiai naudoti neuroniniuose tinkluose.
Nors fiktyvius žodžių vektorius lengva sukonstruoti, jie paprastai nėra geras pasirinkimas. Pagrindinė priežastis ta, kad fiktyvūs žodžių vektoriai negali tiksliai išreikšti skirtingų žodžių panašumo, pavyzdžiui, kosinuso panašumo, kurį dažnai naudojame. Vektorių kosinuso panašumas yra kampo tarp jų kosinusas:
Kadangi bet kurių dviejų skirtingų žodžių fiktyvių vektorių kosinuso panašumas yra 0, fiktyvūs vektoriai negali užkoduoti žodžių panašumų.
15.1.2 Savaime prižiūrimas word2vec
Įrankis word2vec buvo pasiūlytas aukščiau minėtai problemai spręsti. Jis kiekvieną žodį atvaizduoja fiksuoto ilgio vektoriumi, ir šie vektoriai gali geriau išreikšti skirtingų žodžių panašumą ir analogijos sąryšį. Įrankį word2vec sudaro du modeliai, būtent skip-gram (Mikolov ir kt., 2013) ir nuolatinis žodžių krepšys (angl. continuous bag of words, CBOW) (Mikolov ir kt., 2013). Kad vaizdavimai būtų semantiškai prasmingi, jų apmokymas remiasi sąlyginėmis tikimybėmis, kurias galima laikyti kai kurių žodžių prognozavimu naudojant kai kuriuos jų aplinkinius žodžius tekstynuose. Kadangi priežiūra gaunama iš duomenų be žymenų, ir skip-gram, ir nuolatinis žodžių krepšys yra savaime prižiūrimi modeliai.
Toliau pristatysime šiuos du modelius ir jų apmokymo metodus.
15.1.3 Skip-gram modelis
Skip-gram modelis daro prielaidą, kad žodį galima naudoti jo aplinkiniams žodžiams teksto sekoje generuoti. Paimkime teksto seką „the“, „man“, „loves“, „his“, „son“ kaip pavyzdį. Pasirinkime „loves“ kaip centrinį žodį ir nustatykime konteksto lango dydį 2. Kaip parodyta 15.1.1 pav., turint centrinį žodį „loves“, skip-gram modelis nagrinėja sąlyginę tikimybę generuoti konteksto žodžius: „the“, „man“, „his“ ir „son“, kurie nuo centrinio žodžio nutolę ne daugiau kaip 2 žodžiais:
Tarkime, kad konteksto žodžiai generuojami nepriklausomai turint centrinį žodį (t. y. sąlyginis nepriklausomumas). Tokiu atveju aukščiau pateiktą sąlyginę tikimybę galima perrašyti kaip
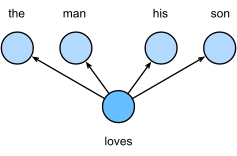
15.1.1 pav. Skip-gram modelis nagrinėja sąlyginę tikimybę generuoti aplinkinius konteksto žodžius turint centrinį žodį.
Skip-gram modelyje kiekvienas žodis turi du dimensijų vektorių vaizdavimus sąlyginėms tikimybėms apskaičiuoti. Konkrečiau, bet kuriam žodžiui su indeksu žodyne pažymėkime ir du jo vektorius, kai jis naudojamas atitinkamai kaip centrinis žodis ir konteksto žodis. Sąlyginę tikimybę generuoti bet kurį konteksto žodį (su indeksu žodyne) turint centrinį žodį (su indeksu žodyne) galima modeliuoti softmax operacija vektorių skaliarinėms sandaugoms:
kur žodyno indeksų aibė . Duota ilgio teksto seka, kurioje žodis laiko žingsnyje žymimas . Tarkime, kad konteksto žodžiai generuojami nepriklausomai turint bet kurį centrinį žodį. Kai konteksto lango dydis yra , skip-gram modelio tikėtinumo funkcija yra tikimybė generuoti visus konteksto žodžius turint bet kurį centrinį žodį:
kur bet kurį laiko žingsnį, mažesnį už arba didesnį už , galima praleisti.
15.1.3.1 Apmokymas
Skip-gram modelio parametrai yra kiekvieno žodyno žodžio centrinio žodžio vektorius ir konteksto žodžio vektorius. Apmokymo metu modelio parametrus išmokstame maksimizuodami tikėtinumo funkciją (t. y. maksimalaus tikėtinumo vertinimas). Tai ekvivalentu minimizuoti šią nuostolių funkciją:
Naudodami stochastinį gradientinį nusileidimą nuostoliui minimizuoti, kiekvienoje iteracijoje galime atsitiktinai atrinkti trumpesnę posekį ir apskaičiuoti šio posekio (stochastinį) gradientą modelio parametrams atnaujinti. Kad apskaičiuotume šį (stochastinį) gradientą, turime gauti logaritminės sąlyginės tikimybės gradientus centrinio žodžio vektoriaus ir konteksto žodžio vektoriaus atžvilgiu. Apskritai pagal (15.1.1) logaritminė sąlyginė tikimybė, apimanti bet kurią centrinio žodžio ir konteksto žodžio porą, yra
Diferencijuodami galime gauti jos gradientą centrinio žodžio vektoriaus atžvilgiu:
Atkreipkite dėmesį, kad skaičiavimui (15.1.3) reikia visų žodyno žodžių sąlyginių tikimybių, kai centrinis žodis yra . Kitų žodžių vektorių gradientus galima gauti tokiu pačiu būdu.
Po apmokymo bet kuriam žodžiui su indeksu žodyne gauname abu žodžio vektorius (kaip centrinio žodžio) ir (kaip konteksto žodžio). Natūraliosios kalbos apdorojimo taikymuose skip-gram modelio centrinių žodžių vektoriai paprastai naudojami kaip žodžių vaizdavimai.
15.1.4 Nuolatinio žodžių krepšio (CBOW) modelis
Nuolatinio žodžių krepšio (CBOW) modelis panašus į skip-gram modelį. Pagrindinis skirtumas nuo skip-gram modelio yra tas, kad nuolatinio žodžių krepšio modelis daro prielaidą, kad centrinis žodis generuojamas remiantis jo aplinkiniais konteksto žodžiais teksto sekoje. Pavyzdžiui, toje pačioje teksto sekoje „the“, „man“, „loves“, „his“ ir „son“, kai „loves“ yra centrinis žodis, o konteksto lango dydis yra 2, nuolatinio žodžių krepšio modelis nagrinėja sąlyginę tikimybę generuoti centrinį žodį „loves“ remiantis konteksto žodžiais „the“, „man“, „his“ ir „son“ (kaip parodyta 15.1.2 pav.), kuri yra
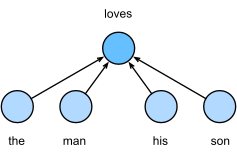
15.1.2 pav. Nuolatinio žodžių krepšio modelis nagrinėja sąlyginę tikimybę generuoti centrinį žodį turint jo aplinkinius konteksto žodžius.
Kadangi nuolatinio žodžių krepšio modelyje yra keli konteksto žodžiai, šių konteksto žodžių vektoriai vidurkinami skaičiuojant sąlyginę tikimybę. Konkrečiau, bet kuriam žodžiui su indeksu žodyne pažymėkime ir du jo vektorius, kai jis naudojamas atitinkamai kaip konteksto žodis ir centrinis žodis (reikšmės sukeistos, palyginti su skip-gram modeliu). Sąlyginę tikimybę generuoti bet kurį centrinį žodį (su indeksu žodyne) turint jo aplinkinius konteksto žodžius (su indeksais žodyne) galima modeliuoti kaip
Trumpumo dėlei tegul ir . Tada (15.1.4) galima supaprastinti iki
Duota ilgio teksto seka, kurioje žodis laiko žingsnyje žymimas . Kai konteksto lango dydis yra , nuolatinio žodžių krepšio modelio tikėtinumo funkcija yra tikimybė generuoti visus centrinius žodžius turint jų konteksto žodžius:
15.1.4.1 Apmokymas
Nuolatinio žodžių krepšio modelių apmokymas beveik toks pat kaip skip-gram modelių apmokymas. Nuolatinio žodžių krepšio modelio maksimalaus tikėtinumo vertinimas ekvivalentus šios nuostolių funkcijos minimizavimui:
Atkreipkite dėmesį, kad
Diferencijuodami galime gauti jos gradientą bet kurio konteksto žodžio vektoriaus () atžvilgiu:
Kitų žodžių vektorių gradientus galima gauti tokiu pačiu būdu. Skirtingai nei skip-gram modelis, nuolatinio žodžių krepšio modelis paprastai kaip žodžių vaizdavimus naudoja konteksto žodžių vektorius.
15.1.5 Santrauka
- Žodžių vektoriai yra vektoriai, naudojami žodžiams vaizduoti, ir juos taip pat galima laikyti žodžių požymių vektoriais arba vaizdavimais. Žodžių atvaizdavimo realiaisiais vektoriais technika vadinama žodžių įterpimu.
- Įrankį word2vec sudaro ir skip-gram, ir nuolatinio žodžių krepšio modeliai.
- Skip-gram modelis daro prielaidą, kad žodį galima naudoti jo aplinkiniams žodžiams teksto sekoje generuoti; o nuolatinio žodžių krepšio modelis daro prielaidą, kad centrinis žodis generuojamas remiantis jo aplinkiniais konteksto žodžiais.
15.1.6 Pratimai
- Koks yra kiekvieno gradiento apskaičiavimo skaičiavimo sudėtingumas? Kokia gali būti problema, jei žodyno dydis yra milžiniškas?
- Kai kurios fiksuotos anglų kalbos frazės sudarytos iš kelių žodžių, pavyzdžiui, „new york“. Kaip apmokyti jų žodžių vektorius? Užuomina: žr. word2vec straipsnio 4 skyrių (Mikolov ir kt., 2013).
- Apmąstykime word2vec dizainą imdami skip-gram modelį kaip pavyzdį. Koks yra sąryšis tarp dviejų žodžių vektorių skaliarinės sandaugos skip-gram modelyje ir kosinuso panašumo? Kodėl panašios semantikos žodžių porai jų žodžių vektorių (apmokytų skip-gram modeliu) kosinuso panašumas gali būti didelis?