
10.8 Spindulio paieška
10.7 skyrelis pristatėme kodavimo ir dekodavimo architektūrą ir standartines jų apmokymo nuo pradžios iki galo technikas. Tačiau kalbėdami apie prognozavimą tikrinimo metu, minėjome tik godžiąją strategiją, kai kiekviename laiko žingsnyje pasirenkame teksto vienetą, kuriam prognozuojama didžiausia tikimybė būti kitam, kol kuriame nors laiko žingsnyje nuspėjame specialų sekos pabaigos „<eos>“ teksto vienetą. Šiame skyrelyje pradėsime formalizuodami šią godžiąją paiešką ir nustatydami kai kurias problemas, su kuriomis praktikai paprastai susiduria. Vėliau palyginsime šią strategiją su dviem alternatyvomis: pilna paieška (iliustratyvi, bet nepraktiška) ir spindulio paieška (standartinis metodas praktikoje).
Pradėkime nustatydami savo matematinį žymėjimą, pasiskolindami sutartis iš 10.7 skyrelis. Bet kuriuo laiko žingsniu dekodavimo blokas išveda prognozes, vaizduojančias kiekvieno žodyno teksto vieneto tikimybę būti kitam sekoje (tikėtina reikšmė), sąlygojamą ankstesnių teksto vienetų ir konteksto kintamojo , kurį sukuria kodavimo blokas įvesties sekai pavaizduoti. Skaičiavimo kainai įvertinti pažymėkime išvesties žodyną (įskaitant specialų sekos pabaigos teksto vienetą „<eos>“). Taip pat nurodykime didžiausią išvesties sekos teksto vienetų skaičių kaip . Mūsų tikslas yra ieškoti idealios išvesties tarp visų galimų išvesties sekų. Atkreipkite dėmesį, kad tai šiek tiek pervertina skirtingų išvesčių skaičių, nes pasirodžius „<eos>“ teksto vienetui paskesnių teksto vienetų nėra. Tačiau mūsų tikslams šis skaičius apytiksliai atspindi paieškos erdvės dydį.
10.8.1 Godžioji paieška
Apsvarstykime paprastą godžiosios paieškos strategiją iš 10.7 skyrelis. Čia bet kuriuo laiko žingsniu tiesiog pasirenkame teksto vienetą su didžiausia sąlygine tikimybe iš , t. y.
Kai tik mūsų modelis išveda „<eos>“ (arba pasiekiame didžiausią ilgį ), išvesties seka baigta.
Ši strategija gali atrodyti pagrįsta, ir iš tiesų ji nėra tokia bloga! Turint omenyje, kokia ji nereikli skaičiavimams, sunku gauti didesnę naudą už tuos pačius pinigus. Tačiau jei minutei nustumsime efektyvumą į šalį, gali atrodyti pagrįsčiau ieškoti tikėtiniausios sekos, o ne (godžiai pasirinktų) tikėtiniausių teksto vienetų sekos. Pasirodo, šie du objektai gali labai skirtis. Tikėtiniausia seka yra ta, kuri maksimizuoja išraišką . Mūsų mašininio vertimo pavyzdyje, jei dekodavimo blokas tikrai atkurtų pagrindinio generatyvinio proceso tikimybes, tai tai duotų mums tikėtiniausią vertimą. Deja, nėra garantijos, kad godžioji paieška mums duos šią seką.
Iliustruokime tai pavyzdžiu. Tarkime, kad išvesties žodyne yra keturi teksto vienetai „A“, „B“, „C“ ir „<eos>“. 10.8.1 pav. keturi skaičiai po kiekvienu laiko žingsniu reiškia sąlygines tikimybes sugeneruoti atitinkamai „A“, „B“, „C“ ir „<eos>“ tuo laiko žingsniu.
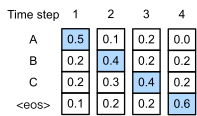
10.8.1 pav. Kiekvienu laiko žingsniu godžioji paieška pasirenka teksto vienetą su didžiausia sąlygine tikimybe.
Kiekvienu laiko žingsniu godžioji paieška pasirenka teksto vienetą su didžiausia sąlygine tikimybe. Todėl bus prognozuojama išvesties seka „A“, „B“, „C“ ir „<eos>“ (10.8.1 pav.). Šios išvesties sekos sąlyginė tikimybė yra .
Toliau pažvelkime į kitą pavyzdį 10.8.1 skyrelis. Skirtingai nei 10.8.1 pav., 2 laiko žingsniu pasirenkame teksto vienetą „C“, kuris turi antrą pagal dydį sąlyginę tikimybę.

Kadangi išvesties posekiai 1 ir 2 laiko žingsniais, kuriais remiasi 3 laiko žingsnis, pasikeitė iš „A“ ir „B“ 10.8.1 pav. į „A“ ir „C“ 10.8.1 skyrelis, kiekvieno teksto vieneto sąlyginė tikimybė 3 laiko žingsniu taip pat pasikeitė 10.8.1 skyrelis. Tarkime, kad 3 laiko žingsniu pasirenkame teksto vienetą „B“. Dabar 4 laiko žingsnis sąlygojamas pirmųjų trijų laiko žingsnių išvesties posekiu „A“, „C“ ir „B“, kuris pasikeitė iš „A“, „B“ ir „C“ 10.8.1 pav.. Todėl kiekvieno teksto vieneto generavimo sąlyginė tikimybė 4 laiko žingsniu 10.8.1 skyrelis taip pat skiriasi nuo tos 10.8.1 pav.. Dėl to išvesties sekos „A“, „C“, „B“ ir „<eos>“ sąlyginė tikimybė 10.8.1 skyrelis yra , kuri yra didesnė nei godžiosios paieškos 10.8.1 pav.. Šiame pavyzdyje išvesties seka „A“, „B“, „C“ ir „<eos>“, gauta godžiąja paieška, nėra optimali.
10.8.2 Pilna paieška
Jei tikslas yra gauti tikėtiniausią seką, galime svarstyti naudoti pilną paiešką: išvardyti visas galimas išvesties sekas su jų sąlyginėmis tikimybėmis ir tada išvesti tą, kuri gauna didžiausią prognozuojamą tikimybę.
Nors tai tikrai duotų tai, ko norime, tai kainuotų nepriimtinai daug skaičiavimų: , eksponentiškai pagal sekos ilgį ir su milžinišku pagrindu, nustatomu žodyno dydžio. Pavyzdžiui, kai ir , abi mažos, palyginti su realių taikymų skaičiais, turėsime įvertinti sekų, o tai jau viršija bet kokių numatomų kompiuterių galimybes. Kita vertus, godžiosios paieškos skaičiavimo kaina yra : stebuklingai pigi, bet tolima nuo optimalios. Pavyzdžiui, kai ir , reikia įvertinti tik sekų.
10.8.3 Spindulio paieška
Sekų dekodavimo strategijas galite vertinti kaip išsidėsčiusias spektre, kai spindulio paieška randa kompromisą tarp godžiosios paieškos efektyvumo ir pilnos paieškos optimalumo. Paprasčiausia spindulio paieškos versija apibūdinama vienu hiperparametru – spindulio dydžiu . Paaiškinkime šią terminologiją. 1 laiko žingsniu pasirenkame teksto vienetų su didžiausiomis prognozuojamomis tikimybėmis. Kiekvienas iš jų bus atitinkamai pirmasis kandidatinių išvesties sekų teksto vienetas. Kiekvienu paskesniu laiko žingsniu, remdamiesi kandidatinių išvesties sekų ankstesniame laiko žingsnyje, toliau renkame kandidatinių išvesties sekų su didžiausiomis prognozuojamomis tikimybėmis iš galimų pasirinkimų.
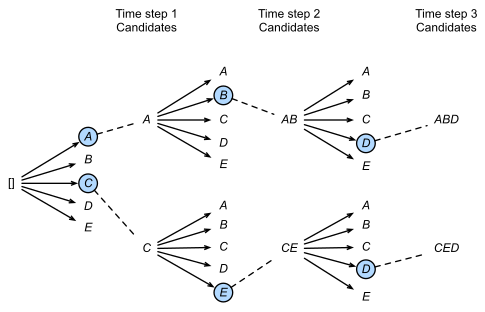
10.8.2 pav. Spindulio paieškos procesas (spindulio dydis ; didžiausias išvesties sekos ilgis ). Kandidatinės išvesties sekos yra , , , , ir .
10.8.2 pav. pavyzdžiu demonstruoja spindulio paieškos procesą. Tarkime, kad išvesties žodyne yra tik penki elementai: , kurių vienas yra „<eos>“. Tegul spindulio dydis yra du, o didžiausias išvesties sekos ilgis – trys. 1 laiko žingsniu tarkime, kad teksto vienetai su didžiausiomis sąlyginėmis tikimybėmis yra ir . 2 laiko žingsniu visiems apskaičiuojame
ir iš šių dešimties reikšmių pasirenkame didžiausias dvi, tarkime, ir . Tada 3 laiko žingsniu visiems apskaičiuojame
ir iš šių dešimties reikšmių pasirenkame didžiausias dvi, tarkime, ir Dėl to gauname šešias kandidatines išvesties sekas: (i) ; (ii) ; (iii) , ; (iv) , ; (v) , , ; ir (vi) , , .
Galiausiai gauname galutinių kandidatinių išvesties sekų aibę remdamiesi šiomis šešiomis sekomis (pvz., atmesdami dalis, įskaitant „<eos>“ ir po jo einančias). Tada pasirenkame išvesties seką, maksimizuojančią šį įvertį:
čia yra galutinės kandidatinės sekos ilgis, o paprastai nustatomas 0,75. Kadangi ilgesnė seka turi daugiau logaritminių narių (10.8.1) sumoje, narys vardiklyje baudžia ilgas sekas.
Spindulio paieškos skaičiavimo kaina yra . Šis rezultatas yra tarp godžiosios paieškos ir pilnos paieškos. Godžioji paieška gali būti laikoma ypatingu spindulio paieškos atveju, kai spindulio dydis nustatomas 1.
10.8.4 Santrauka
Sekų paieškos strategijos apima godžiąją paiešką, pilną paiešką ir spindulio paiešką. Spindulio paieška suteikia kompromisą tarp tikslumo ir skaičiavimo kainos lanksčiai pasirenkant spindulio dydį.
10.8.5 Pratimai
- Ar galime pilną paiešką laikyti ypatingu spindulio paieškos tipu? Kodėl taip arba kodėl ne?
- Pritaikykite spindulio paiešką mašininio vertimo problemai 10.7 skyrelis. Kaip spindulio dydis veikia vertimo rezultatus ir prognozavimo greitį?
- Kalbos modeliavimą naudojome tekstui po vartotojo pateiktų priešdėlių generuoti 9.5 skyrelis. Kokio tipo paieškos strategiją jis naudoja? Ar galite ją patobulinti?