
10.2 Sklendžių rekurentiniai vienetai (GRU)
Kadangi RNN, o ypač LSTM architektūra (10.1 skyrelis), greitai išpopuliarėjo 2010-aisiais, keli tyrėjai pradėjo eksperimentuoti su supaprastintomis architektūromis, tikėdamiesi išlaikyti pagrindinę idėją – įtraukti vidinę būseną ir daugybinius sklendžių mechanizmus, bet siekdami pagreitinti skaičiavimą. Sklendžių rekurentinis vienetas (GRU) (Cho ir kt., 2014) pasiūlė supaprastintą LSTM atminties ląstelės versiją, kuri dažnai pasiekia panašų našumą, tačiau turi pranašumą – yra greitesnė skaičiuoti (Chung ir kt., 2014).
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import rnn
npx.set_np()
from d2l import torch as d2l
import torch
from torch import nn
from d2l import tensorflow as d2l
import tensorflow as tf
from d2l import jax as d2l
from flax import linen as nn
import jax
from jax import numpy as jnp
10.2.1 Atstatymo sklendė ir atnaujinimo sklendė
Čia trys LSTM sklendės pakeičiamos dviem: atstatymo sklendė ir atnaujinimo sklendė. Kaip ir LSTM, šioms sklendėms taikomos sigmoidinės aktyvacijos, verčiančios jų reikšmes gulėti intervale . Intuityviai atstatymo sklendė valdo, kiek ankstesnės būsenos vis dar norėtume prisiminti. Panašiai atnaujinimo sklendė leistų valdyti, kiek naujosios būsenos yra tiesiog senosios kopija. 10.2.1 pav. iliustruoja abiejų atstatymo ir atnaujinimo sklendžių įvestis GRU, duotą dabartinio laiko žingsnio įvestį ir ankstesnio laiko žingsnio paslėptąją būseną. Sklendžių išvestis pateikia du pilnai sujungti sluoksniai su sigmoidine aktyvacijos funkcija.
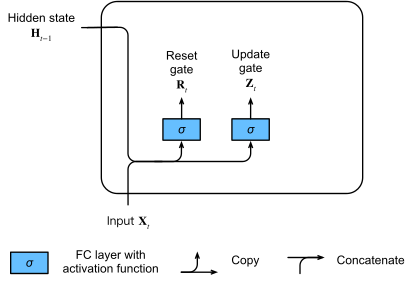
10.2.1 pav. Atstatymo sklendės ir atnaujinimo sklendės skaičiavimas GRU modelyje.
Matematiškai, duotam laiko žingsniui , tarkime, kad įvestis yra minirinkinys (pavyzdžių skaičius ; įvesčių skaičius ), o ankstesnio laiko žingsnio paslėptoji būsena yra (paslėptųjų vienetų skaičius ). Tada atstatymo sklendė ir atnaujinimo sklendė apskaičiuojamos taip:
kur ir yra svorių parametrai, o yra poslinkio parametrai.
10.2.2 Kandidatinė paslėptoji būsena
Toliau atstatymo sklendę integruojame į įprastą atnaujinimo mechanizmą (9.4.3), gaudami šią kandidatinę paslėptąją būseną laiko žingsniu :
kur ir yra svorių parametrai, yra poslinkis, o simbolis yra Hadamardo (elementų lygmens) sandaugos operatorius. Čia naudojame tanh aktyvacijos funkciją.
Rezultatas yra kandidatas, nes dar turime įtraukti atnaujinimo sklendės veikimą. Palyginti su (9.4.3), ankstesnių būsenų įtaka dabar gali būti sumažinta elementų lygmens ir daugyba (10.2.1). Kai tik atstatymo sklendės elementai artimi 1, atkuriame paprastą RNN, tokį kaip (9.4.3). Visiems atstatymo sklendės elementams, artimiems 0, kandidatinė paslėptoji būsena yra MLP su įvestimi rezultatas. Bet kuri jau egzistuojanti paslėptoji būsena taip atstatoma į numatytąsias reikšmes.
10.2.2 pav. iliustruoja skaičiavimo srautą pritaikius atstatymo sklendę.
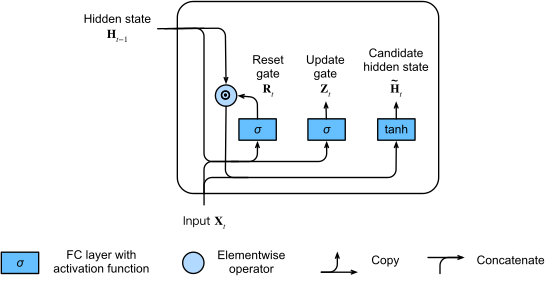
10.2.2 pav. Kandidatinės paslėptosios būsenos skaičiavimas GRU modelyje.
10.2.3 Paslėptoji būsena
Galiausiai turime įtraukti atnaujinimo sklendės poveikį. Ji nustato, kiek nauja paslėptoji būsena atitinka senąją būseną , palyginti su tuo, kiek ji primena naująją kandidatinę būseną . Atnaujinimo sklendę šiam tikslui galima naudoti tiesiog imant elementų lygmens iškilusius derinius ir . Tai veda prie galutinės GRU atnaujinimo lygties:
Kai tik atnaujinimo sklendė artima 1, tiesiog išlaikome seną būseną. Šiuo atveju informacija iš ignoruojama, faktiškai praleidžiant laiko žingsnį priklausomybių grandinėje. Priešingai, kai tik artima 0, nauja latentinė būsena artėja prie kandidatinės latentinės būsenos . 10.2.3 pav. parodo skaičiavimo srautą, kai atnaujinimo sklendė veikia.
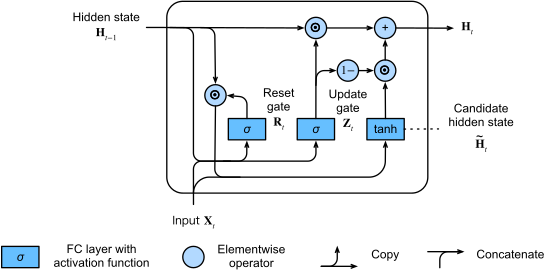
10.2.3 pav. Paslėptosios būsenos skaičiavimas GRU modelyje.
Apibendrinant, GRU turi šias dvi išskirtines savybes:
- Atstatymo sklendės padeda užfiksuoti trumpalaikes sekų priklausomybes.
- Atnaujinimo sklendės padeda užfiksuoti ilgalaikes sekų priklausomybes.
10.2.4 Įgyvendinimas nuo nulio
Kad geriau suprastume GRU modelį, įgyvendinkime jį nuo nulio.
10.2.4.1 (Modelio parametrų inicializavimas)
Pirmas žingsnis – inicializuoti modelio parametrus.
Svorius imame iš Gauso skirstinio
su standartiniu nuokrypiu sigma, o poslinkį nustatome į 0.
Hiperparametras num_hiddens apibrėžia paslėptųjų vienetų skaičių.
Sukuriame visus svorius ir poslinkius, susijusius su atnaujinimo sklende,
atstatymo sklende ir kandidatine paslėptąja būsena.
class GRUScratch(d2l.Module):
    def __init__(self, num_inputs, num_hiddens, sigma=0.01):
        super().__init__()
        self.save_hyperparameters()

        if tab.selected('mxnet'):
            init_weight = lambda *shape: d2l.randn(*shape) * sigma
            triple = lambda: (init_weight(num_inputs, num_hiddens),
                              init_weight(num_hiddens, num_hiddens),
                              d2l.zeros(num_hiddens))
        if tab.selected('pytorch'):
            init_weight = lambda *shape: nn.Parameter(d2l.randn(*shape) * sigma)
            triple = lambda: (init_weight(num_inputs, num_hiddens),
                              init_weight(num_hiddens, num_hiddens),
                              nn.Parameter(d2l.zeros(num_hiddens)))
        if tab.selected('tensorflow'):
            init_weight = lambda *shape: tf.Variable(d2l.normal(shape) * sigma)
            triple = lambda: (init_weight(num_inputs, num_hiddens),
                              init_weight(num_hiddens, num_hiddens),
                              tf.Variable(d2l.zeros(num_hiddens)))

        self.W_xz, self.W_hz, self.b_z = triple()  # Update gate
        self.W_xr, self.W_hr, self.b_r = triple()  # Reset gate
        self.W_xh, self.W_hh, self.b_h = triple()  # Candidate hidden state
class GRUScratch(d2l.Module):
    num_inputs: int
    num_hiddens: int
    sigma: float = 0.01

    def setup(self):
        init_weight = lambda name, shape: self.param(name,
                                                     nn.initializers.normal(self.sigma),
                                                     shape)
        triple = lambda name : (
            init_weight(f'W_x{name}', (self.num_inputs, self.num_hiddens)),
            init_weight(f'W_h{name}', (self.num_hiddens, self.num_hiddens)),
            self.param(f'b_{name}', nn.initializers.zeros, (self.num_hiddens)))

        self.W_xz, self.W_hz, self.b_z = triple('z')  # Update gate
        self.W_xr, self.W_hr, self.b_r = triple('r')  # Reset gate
        self.W_xh, self.W_hh, self.b_h = triple('h')  # Candidate hidden state
10.2.4.2 Modelio apibrėžimas
Dabar esame pasiruošę apibrėžti GRU tiesioginį skaičiavimą. Jo struktūra tokia pati kaip pagrindinės RNN ląstelės, tik atnaujinimo lygtys sudėtingesnės.
@d2l.add_to_class(GRUScratch)
def forward(self, inputs, H=None):
    if H is None:
        # Initial state with shape: (batch_size, num_hiddens)
        if tab.selected('mxnet'):
            H = d2l.zeros((inputs.shape[1], self.num_hiddens),
                          ctx=inputs.ctx)
        if tab.selected('pytorch'):
            H = d2l.zeros((inputs.shape[1], self.num_hiddens),
                          device=inputs.device)
        if tab.selected('tensorflow'):
            H = d2l.zeros((inputs.shape[1], self.num_hiddens))
    outputs = []
    for X in inputs:
        Z = d2l.sigmoid(d2l.matmul(X, self.W_xz) +
                        d2l.matmul(H, self.W_hz) + self.b_z)
        R = d2l.sigmoid(d2l.matmul(X, self.W_xr) +
                        d2l.matmul(H, self.W_hr) + self.b_r)
        H_tilde = d2l.tanh(d2l.matmul(X, self.W_xh) +
                           d2l.matmul(R * H, self.W_hh) + self.b_h)
        H = Z * H + (1 - Z) * H_tilde
        outputs.append(H)
    return outputs, H
@d2l.add_to_class(GRUScratch)
def forward(self, inputs, H=None):
    # Use lax.scan primitive instead of looping over the
    # inputs, since scan saves time in jit compilation
    def scan_fn(H, X):
        Z = d2l.sigmoid(d2l.matmul(X, self.W_xz) + d2l.matmul(H, self.W_hz) +
                        self.b_z)
        R = d2l.sigmoid(d2l.matmul(X, self.W_xr) +
                        d2l.matmul(H, self.W_hr) + self.b_r)
        H_tilde = d2l.tanh(d2l.matmul(X, self.W_xh) +
                           d2l.matmul(R * H, self.W_hh) + self.b_h)
        H = Z * H + (1 - Z) * H_tilde
        return H, H  # return carry, y

    if H is None:
        batch_size = inputs.shape[1]
        carry = jnp.zeros((batch_size, self.num_hiddens))
    else:
        carry = H

    # scan takes the scan_fn, initial carry state, xs with leading axis to be scanned
    carry, outputs = jax.lax.scan(scan_fn, carry, inputs)
    return outputs, carry
10.2.4.3 Mokymas
Laiko mašinos duomenų rinkinyje apmokyti kalbos modelį veikia lygiai taip pat kaip 9.5 skyrelis.
data = d2l.TimeMachine(batch_size=1024, num_steps=32)
if tab.selected('mxnet', 'pytorch', 'jax'):
    gru = GRUScratch(num_inputs=len(data.vocab), num_hiddens=32)
    model = d2l.RNNLMScratch(gru, vocab_size=len(data.vocab), lr=4)
    trainer = d2l.Trainer(max_epochs=50, gradient_clip_val=1, num_gpus=1)
if tab.selected('tensorflow'):
    with d2l.try_gpu():
        gru = GRUScratch(num_inputs=len(data.vocab), num_hiddens=32)
        model = d2l.RNNLMScratch(gru, vocab_size=len(data.vocab), lr=4)
    trainer = d2l.Trainer(max_epochs=50, gradient_clip_val=1)
trainer.fit(model, data)
10.2.5 Glaustas įgyvendinimas
Aukšto lygio API galime tiesiogiai sukurti GRU modelį. Tai įkapsuliuoja visas konfigūracijos detales, kurias aukščiau pateikėme aiškiai.
class GRU(d2l.RNN):
    def __init__(self, num_inputs, num_hiddens):
        d2l.Module.__init__(self)
        self.save_hyperparameters()
        if tab.selected('mxnet'):
            self.rnn = rnn.GRU(num_hiddens)
        if tab.selected('pytorch'):
            self.rnn = nn.GRU(num_inputs, num_hiddens)
        if tab.selected('tensorflow'):
            self.rnn = tf.keras.layers.GRU(num_hiddens, return_sequences=True,
                                           return_state=True)
class GRU(d2l.RNN):
    num_hiddens: int

    @nn.compact
    def __call__(self, inputs, H=None, training=False):
        if H is None:
            batch_size = inputs.shape[1]
            H = nn.GRUCell.initialize_carry(jax.random.PRNGKey(0),
                                            (batch_size,), self.num_hiddens)

        GRU = nn.scan(nn.GRUCell, variable_broadcast="params",
                      in_axes=0, out_axes=0, split_rngs={"params": False})

        H, outputs = GRU()(H, inputs)
        return outputs, H
Kodas apmokymo metu veikia gerokai greičiau, nes naudoja sukompiliuotus operatorius, o ne Python.
if tab.selected('mxnet', 'pytorch', 'tensorflow'):
    gru = GRU(num_inputs=len(data.vocab), num_hiddens=32)
if tab.selected('jax'):
    gru = GRU(num_hiddens=32)
if tab.selected('mxnet', 'pytorch', 'jax'):
    model = d2l.RNNLM(gru, vocab_size=len(data.vocab), lr=4)
if tab.selected('tensorflow'):
    with d2l.try_gpu():
        model = d2l.RNNLM(gru, vocab_size=len(data.vocab), lr=4)
trainer.fit(model, data)
Po apmokymo išspausdiname painumą apmokymo aibėje ir prognozuojamą seką, einančią po pateikto priešdėlio.
model.predict('it has', 20, data.vocab, d2l.try_gpu())
model.predict('it has', 20, data.vocab)
model.predict('it has', 20, data.vocab, trainer.state.params)
10.2.6 Santrauka
Palyginti su LSTM, GRU pasiekia panašų našumą, bet skaičiavimo požiūriu yra lengvesni. Apskritai, palyginti su paprastais RNN, sklendėmis valdomi RNN, tokie kaip LSTM ir GRU, geriau užfiksuoja priklausomybes sekose, kai laiko žingsnių atstumai dideli. GRU kraštutiniu atveju apima paprastus RNN, kai atstatymo sklendė yra įjungta. Jie taip pat gali praleisti posekius įjungdami atnaujinimo sklendę.
10.2.7 Pratimai
- Tarkime, kad norime naudoti tik laiko žingsnio įvestį išvesčiai laiko žingsniu prognozuoti. Kokios yra geriausios atstatymo ir atnaujinimo sklendžių reikšmės kiekvienam laiko žingsniui?
- Pakoreguokite hiperparametrus ir išanalizuokite jų įtaką veikimo laikui, painumui ir išvesties sekai.
- Palyginkite
rnn.RNNirrnn.GRUįgyvendinimų veikimo laiką, painumą ir išvesties eilutes tarpusavyje. - Kas nutiks, jei įgyvendinsite tik dalis GRU, pvz., tik su atstatymo sklende arba tik su atnaujinimo sklende?