
9.4 Rekurentiniai neuroniniai tinklai
9.3 skyrelis aprašėme Markovo modelius ir -gramas kalbos modeliavimui, kur teksto vieneto sąlyginė tikimybė laiko žingsniu priklauso tik nuo ankstesnių teksto vienetų. Jei norime įtraukti galimą teksto vienetų, ankstesnių nei laiko žingsnis , poveikį , turime didinti . Tačiau modelio parametrų skaičius taip pat didėtų eksponentiškai, nes žodyno aibei turėtume saugoti skaičių. Todėl užuot modeliavus , pageidautina naudoti latentinio kintamojo modelį,
kur yra paslėptoji būsena, saugojanti sekos informaciją iki laiko žingsnio . Apskritai paslėptąją būseną bet kuriuo laiko žingsniu galima apskaičiuoti pagal ir dabartinę įvestį , ir ankstesnę paslėptąją būseną :
Pakankamai galingai funkcijai (9.4.1) latentinio kintamojo modelis nėra aproksimacija. Juk gali tiesiog saugoti visus iki šiol stebėtus duomenis. Tačiau tai gali padaryti brangius ir skaičiavimus, ir saugojimą.
Prisiminkite, kad paslėptuosius sluoksnius su paslėptaisiais vienetais aptarėme 5 skyrelis. Verta pažymėti, kad paslėptieji sluoksniai ir paslėptosios būsenos reiškia dvi labai skirtingas sąvokas. Paslėptieji sluoksniai, kaip paaiškinta, yra sluoksniai, paslėpti nuo žvilgsnio kelyje nuo įvesties iki išvesties. Paslėptosios būsenos techniškai kalbant yra įvestys tam, ką darome duotame žingsnyje, ir jas galima apskaičiuoti tik žiūrint į ankstesnių laiko žingsnių duomenis.
Rekurentiniai neuroniniai tinklai (RNN) yra neuroniniai tinklai su paslėptosiomis būsenomis. Prieš pristatydami RNN modelį, pirmiausia grįžkime prie MLP modelio, pristatyto 5.1 skyrelis.
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
from d2l import torch as d2l
import torch
from d2l import tensorflow as d2l
import tensorflow as tf
from d2l import jax as d2l
import jax
from jax import numpy as jnp
9.4.1 Neuroniniai tinklai be paslėptųjų būsenų
Pažvelkime į MLP su vienu paslėptuoju sluoksniu. Tegul paslėptojo sluoksnio aktyvacijos funkcija yra . Turint pavyzdžių minirinkinį su rinkinio dydžiu ir įvesčių, paslėptojo sluoksnio išvestis apskaičiuojama taip:
(9.4.2) paslėptajam sluoksniui turime svorių parametrą , poslinkio parametrą ir paslėptųjų vienetų skaičių . Taip pasiruošę, sumuodami taikome transliavimą (žr. 2.1.4 skyrelis). Toliau paslėptojo sluoksnio išvestis naudojama kaip išvesties sluoksnio įvestis, kuri pateikiama taip:
kur yra išvesties kintamasis, yra svorių parametras, o yra išvesties sluoksnio poslinkio parametras. Jei tai klasifikavimo uždavinys, galime naudoti išvesties kategorijų tikimybių skirstiniui apskaičiuoti.
Tai visiškai analogiška anksčiau 9.1 skyrelis išspręstam regresijos uždaviniui, todėl detalių praleidžiame. Pakanka pasakyti, kad galime atsitiktinai rinktis požymių ir žymenų poras ir išmokti savo tinklo parametrus per automatinį diferencijavimą ir stochastinį gradientinį nusileidimą.
9.4.2 Rekurentiniai neuroniniai tinklai su paslėptosiomis būsenomis
Reikalai visiškai skiriasi, kai turime paslėptąsias būsenas. Pažvelkime į struktūrą šiek tiek išsamiau.
Tarkime, kad turime įvesčių minirinkinį laiko žingsniu . Kitaip tariant, sekų pavyzdžių minirinkiniui kiekviena eilutė atitinka vieną pavyzdį laiko žingsniu iš sekos. Toliau pažymėkime laiko žingsnio paslėptojo sluoksnio išvestį. Skirtingai nei su MLP, čia išsaugome ankstesnio laiko žingsnio paslėptojo sluoksnio išvestį ir įvedame naują svorių parametrą , aprašantį, kaip naudoti ankstesnio laiko žingsnio paslėptojo sluoksnio išvestį dabartiniame laiko žingsnyje. Konkrečiai, dabartinio laiko žingsnio paslėptojo sluoksnio išvesties skaičiavimą lemia dabartinio laiko žingsnio įvestis kartu su ankstesnio laiko žingsnio paslėptojo sluoksnio išvestimi:
Palyginti su (9.4.2), (9.4.3) prideda dar vieną narį ir taip realizuoja (9.4.1). Iš gretimų laiko žingsnių paslėptojo sluoksnio išvesčių ir ryšio žinome, kad šie kintamieji užfiksavo ir išlaikė sekos istorinę informaciją iki jų dabartinio laiko žingsnio, lygiai kaip neuroninio tinklo dabartinio laiko žingsnio būsena ar atmintis. Todėl tokia paslėptojo sluoksnio išvestis vadinama paslėptąja būsena. Kadangi paslėptoji būsena dabartiniame laiko žingsnyje naudoja tą patį ankstesnio laiko žingsnio apibrėžimą, (9.4.3) skaičiavimas yra rekurentinis. Todėl, kaip sakėme, neuroniniai tinklai su paslėptosiomis būsenomis, pagrįstais rekurentiniu skaičiavimu, vadinami rekurentiniais neuroniniais tinklais. Sluoksniai, kurie RNN atlieka (9.4.3) skaičiavimą, vadinami rekurentiniais sluoksniais.
Yra daug skirtingų RNN konstravimo būdų. Tie, kurių paslėptoji būsena apibrėžiama (9.4.3), yra labai įprasti. Laiko žingsniui išvesties sluoksnio išvestis yra panaši į skaičiavimą MLP:
RNN parametrai apima paslėptojo sluoksnio svorius ir poslinkį , kartu su išvesties sluoksnio svoriais ir poslinkiu . Verta paminėti, kad net skirtingais laiko žingsniais RNN visada naudoja šiuos modelio parametrus. Todėl RNN parametrizavimo kaina nedidėja didėjant laiko žingsnių skaičiui.
9.4.1 pav. iliustruoja RNN skaičiavimo logiką trijuose gretimuose laiko žingsniuose. Bet kuriuo laiko žingsniu paslėptosios būsenos skaičiavimą galima traktuoti taip: (i) sujungti dabartinio laiko žingsnio įvestį ir ankstesnio laiko žingsnio paslėptąją būseną ; (ii) sujungimo rezultatą paduoti į pilnai sujungtą sluoksnį su aktyvacijos funkcija . Tokio pilnai sujungto sluoksnio išvestis yra dabartinio laiko žingsnio paslėptoji būsena . Šiuo atveju modelio parametrai yra ir sujungimas bei poslinkis , visi iš (9.4.3). Dabartinio laiko žingsnio paslėptoji būsena dalyvaus skaičiuojant kito laiko žingsnio paslėptąją būseną . Be to, taip pat bus paduota į pilnai sujungtą išvesties sluoksnį, kad būtų apskaičiuota dabartinio laiko žingsnio išvestis .

9.4.1 pav. RNN su paslėptąja būsena.
Ką tik paminėjome, kad paslėptosios būsenos skaičiavimas yra ekvivalentus
ir sujungimo
ir
bei sujungimo
matricų daugybai.
Nors tai galima įrodyti matematiškai,
toliau tiesiog naudojame paprastą kodo fragmentą demonstracijai.
Pirmiausia
apibrėžiame matricas X, W_xh, H ir W_hh, kurių formos atitinkamai yra (3, 1), (1, 4), (3, 4) ir (4, 4).
Padauginę X iš W_xh, o H iš W_hh, ir tada sudėję šias dvi sandaugas,
gauname formos (3, 4) matricą.
X, W_xh = d2l.randn(3, 1), d2l.randn(1, 4)
H, W_hh = d2l.randn(3, 4), d2l.randn(4, 4)
d2l.matmul(X, W_xh) + d2l.matmul(H, W_hh)
X, W_xh = d2l.normal((3, 1)), d2l.normal((1, 4))
H, W_hh = d2l.normal((3, 4)), d2l.normal((4, 4))
d2l.matmul(X, W_xh) + d2l.matmul(H, W_hh)
X, W_xh = jax.random.normal(d2l.get_key(), (3, 1)), jax.random.normal(
                                                        d2l.get_key(), (1, 4))
H, W_hh = jax.random.normal(d2l.get_key(), (3, 4)), jax.random.normal(
                                                        d2l.get_key(), (4, 4))
d2l.matmul(X, W_xh) + d2l.matmul(H, W_hh)
Dabar sujungiame matricas X ir H
išilgai stulpelių (ašis 1),
o matricas
W_xh ir W_hh – išilgai eilučių (ašis 0).
Šie du sujungimai
duoda
atitinkamai formos (3, 5)
ir (5, 4) matricas.
Padauginę šias dvi sujungtas matricas,
gauname tą pačią formos (3, 4) išvesties matricą
kaip aukščiau.
d2l.matmul(d2l.concat((X, H), 1), d2l.concat((W_xh, W_hh), 0))
9.4.3 RNN pagrįsti simbolių lygio kalbos modeliai
Prisiminkite, kad kalbos modeliavimui 9.3 skyrelis siekiame prognozuoti kitą teksto vienetą pagal dabartinius ir ankstesnius teksto vienetus; todėl originalią seką pastumiame vienu teksto vienetu kaip tikslus (žymenis). (Bengio ir kt., 2003) pirmieji pasiūlė naudoti neuroninį tinklą kalbos modeliavimui. Toliau iliustruojame, kaip RNN galima naudoti kalbos modeliui sukurti. Tegul minirinkinio dydis yra vienas, o teksto seka – „machine“. Kad supaprastintume apmokymą kituose skyreliuose, tekstą skaidome į simbolius, o ne į žodžius, ir nagrinėjame simbolių lygio kalbos modelį. 9.4.2 pav. parodo, kaip prognozuoti kitą simbolį pagal dabartinį ir ankstesnius simbolius per RNN simbolių lygio kalbos modeliavimui.
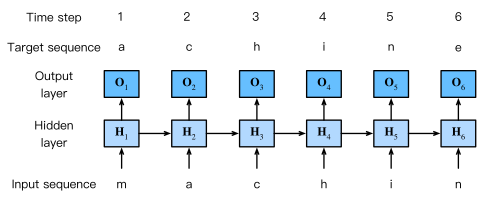
9.4.2 pav. Simbolių lygio kalbos modelis, pagrįstas RNN. Įvesties ir tikslinė sekos yra atitinkamai „machin“ ir „achine“.
Apmokymo proceso metu kiekvienam laiko žingsniui atliekame softmax operaciją su išvesties sluoksnio išvestimi, o tada naudojame kryžminės entropijos nuostolį, kad apskaičiuotume paklaidą tarp modelio išvesties ir tikslo. Dėl rekurentinio paslėptosios būsenos skaičiavimo paslėptajame sluoksnyje 3 laiko žingsnio išvestį 9.4.2 pav. lemia teksto seka „m“, „a“ ir „c“. Kadangi kitas sekos simbolis mokymo duomenyse yra „h“, 3 laiko žingsnio nuostolis priklausys nuo kito simbolio tikimybių skirstinio, sugeneruoto pagal požymių seką „m“, „a“, „c“, ir šio laiko žingsnio tikslo „h“.
Praktikoje kiekvienas teksto vienetas pavaizduojamas dimensijų vektoriumi, o naudojame rinkinio dydį . Todėl įvestis laiko žingsniu bus matrica, identiška tam, ką aptarėme 9.4.2 skyrelis.
Kituose skyreliuose įgyvendinsime RNN simbolių lygio kalbos modeliams.
9.4.4 Santrauka
Neuroninis tinklas, naudojantis rekurentinį skaičiavimą paslėptosioms būsenoms, vadinamas rekurentiniu neuroniniu tinklu (RNN). RNN paslėptoji būsena gali užfiksuoti sekos istorinę informaciją iki dabartinio laiko žingsnio. Naudojant rekurentinį skaičiavimą, RNN modelio parametrų skaičius nedidėja didėjant laiko žingsnių skaičiui. Taikymų požiūriu RNN galima naudoti simbolių lygio kalbos modeliams kurti.
9.4.5 Pratimai
- Jei naudojame RNN kitam teksto sekos simboliui prognozuoti, kokia yra reikalinga bet kurios išvesties dimensija?
- Kodėl RNN gali išreikšti teksto vieneto sąlyginę tikimybę tam tikru laiko žingsniu pagal visus ankstesnius teksto sekos teksto vienetus?
- Kas nutinka gradientui, jei atgaline kryptimi sklidate per ilgą seką?
- Kokios yra kai kurios šiame skyrelyje aprašyto kalbos modelio problemos?