
9.7 Atgalinis sklidimas laike
Jei atlikote 9.5 skyrelis pratimus, matėte, kad gradientų apkarpymas yra gyvybiškai svarbus siekiant užkirsti kelią retkarčiais pasitaikantiems milžiniškiems gradientams destabilizuoti apmokymą. Užsiminėme, kad sprogstantys gradientai kyla iš atgalinio sklidimo per ilgas sekas. Prieš pristatydami daugybę šiuolaikinių RNN architektūrų, atidžiau pažvelkime, kaip atgalinis sklidimas veikia sekų modeliuose, matematiškai išsamiai. Tikimės, kad ši diskusija suteiks tikslumo nykstančių ir sprogstančių gradientų sampratai. Jei prisimenate mūsų diskusiją apie tiesioginį ir atgalinį sklidimą per skaičiavimo grafus, kai pristatėme MLP 5.3 skyrelis, tai tiesioginis sklidimas RNN turėtų būti santykinai paprastas. Atgalinio sklidimo taikymas RNN vadinamas atgaliniu sklidimu laike (Werbos, 1990). Ši procedūra reikalauja išskleisti (arba išvynioti) RNN skaičiavimo grafą po vieną laiko žingsnį. Išvyniotas RNN iš esmės yra tiesioginio sklidimo neuroninis tinklas su ta ypatinga savybe, kad tie patys parametrai kartojami visame išvyniotame tinkle, pasirodydami kiekviename laiko žingsnyje. Tada, kaip ir bet kuriame tiesioginio sklidimo neuroniniame tinkle, galime taikyti grandinės taisyklę, atgaline kryptimi sklidindami gradientus per išvyniotą tinklą. Gradientas kiekvieno parametro atžvilgiu turi būti susumuotas per visas vietas, kuriose parametras pasitaiko išvyniotame tinkle. Tokio svorių susiejimo tvarkymas turėtų būti pažįstamas iš mūsų skyrių apie konvoliucinius neuroninius tinklus.
Komplikacijų kyla dėl to, kad sekos gali būti gana ilgos. Nėra neįprasta dirbti su teksto sekomis, sudarytomis iš daugiau nei tūkstančio teksto vienetų. Atkreipkite dėmesį, kad tai kelia problemų ir skaičiavimo (per daug atminties), ir optimizavimo (skaitinis nestabilumas) požiūriu. Įvestis iš pirmojo žingsnio praeina per daugiau nei 1000 matricų sandaugų, kol pasiekia išvestį, ir dar 1000 matricų sandaugų reikia gradientui apskaičiuoti. Dabar išanalizuosime, kas gali nepavykti ir kaip su tuo susidoroti praktikoje.
9.7.1 Gradientų RNN analizė
Pradedame nuo supaprastinto modelio, kaip veikia RNN. Šis modelis ignoruoja paslėptosios būsenos specifikos ir jos atnaujinimo detales. Matematinis žymėjimas čia aiškiai neskiria skaliarų, vektorių ir matricų. Tik bandome susikurti šiek tiek intuicijos. Šiame supaprastintame modelyje žymime paslėptąją būseną, – įvestį, o – išvestį laiko žingsniu . Prisiminkite mūsų diskusijas 9.4.2 skyrelis, kad įvestis ir paslėptoji būsena gali būti sujungtos prieš dauginant iš vieno paslėptojo sluoksnio svorio kintamojo. Todėl ir naudojame paslėptojo sluoksnio ir išvesties sluoksnio svoriams žymėti atitinkamai. Dėl to paslėptosios būsenos ir išvestys kiekvienu laiko žingsniu yra
kur ir yra atitinkamai paslėptojo sluoksnio ir išvesties sluoksnio transformacijos. Taigi turime reikšmių grandinę , kurios priklauso viena nuo kitos per rekurentinį skaičiavimą. Tiesioginis sklidimas yra gana paprastas. Reikia tik eiti ciklu per trejetus po vieną laiko žingsnį. Neatitikimas tarp išvesties ir norimo tikslo tada įvertinamas tikslo funkcija per visus laiko žingsnių taip:
Atgaliniam sklidimui reikalai yra šiek tiek sudėtingesni, ypač kai skaičiuojame gradientus tikslo funkcijos parametrų atžvilgiu. Konkrečiai, pagal grandinės taisyklę,
Pirmąjį ir antrąjį sandaugos narį (9.7.2) lengva apskaičiuoti. Trečiasis narys yra ten, kur reikalai pasidaro sudėtingi, nes turime rekurentiškai apskaičiuoti parametro poveikį . Pagal rekurentinį skaičiavimą (9.7.1), priklauso ir nuo , ir nuo , kur skaičiavimas taip pat priklauso nuo . Taigi, įvertinus pilnąją išvestinę atžvilgiu pagal grandinės taisyklę, gaunama
Kad išvestume aukščiau pateiktą gradientą, tarkime, kad turime tris sekas , tenkinančias ir , kai . Tada, kai , lengva parodyti, kad
Pakeitę , ir pagal
gradiento skaičiavimas (9.7.3) tenkina . Taigi, pagal (9.7.4), galime pašalinti rekurentinį skaičiavimą (9.7.3) su
Nors galime naudoti grandinės taisyklę apskaičiuoti rekursyviai, ši grandinė gali tapti labai ilga, kai tik didelis. Aptarkime keletą strategijų, kaip susidoroti su šia problema.
9.7.1.1 Pilnas skaičiavimas
Viena idėja gali būti apskaičiuoti pilną sumą (9.7.5). Tačiau tai labai lėta, o gradientai gali sprogti, nes subtilūs pradinių sąlygų pokyčiai gali potencialiai labai paveikti rezultatą. Tai yra, galėtume pamatyti kažką panašaus į drugelio efektą, kai minimalūs pradinių sąlygų pokyčiai lemia neproporcingus rezultato pokyčius. Tai paprastai nepageidautina. Juk ieškome tvirtų įvertinių, kurie gerai apibendrina. Todėl ši strategija praktikoje beveik niekada nenaudojama.
9.7.1.2 Laiko žingsnių nukirtimas
Alternatyviai, galime nukirsti sumą (9.7.5) po žingsnių. Tai yra tai, ką iki šiol aptarinėjome. Tai veda prie tikrojo gradiento aproksimacijos, tiesiog nutraukiant sumą ties . Praktikoje tai veikia gana gerai. Tai dažniausiai vadinama nukirstu atgaliniu sklidimu laike (Jaeger, 2002). Viena iš to pasekmių yra ta, kad modelis pirmiausia sutelkia dėmesį į trumpalaikę įtaką, o ne į ilgalaikes pasekmes. Tai iš tikrųjų pageidautina, nes šališkai nukreipia įvertį link paprastesnių ir stabilesnių modelių.
9.7.1.3 Atsitiktinis nukirtimas
Galiausiai galime pakeisti atsitiktiniu dydžiu, kuris yra teisingas laukiamąja prasme, bet nukirsta seką. Tai pasiekiama naudojant seką su iš anksto nustatytais , kur ir , taigi . Tai naudojame gradientui (9.7.3) pakeisti
Iš apibrėžimo išplaukia, kad . Kai tik , rekurentinis skaičiavimas nutraukiamas tuo laiko žingsniu . Tai veda prie svertinės skirtingo ilgio sekų sumos, kur ilgos sekos yra retos, bet tinkamai persvertos. Šią idėją pasiūlė (Tallec ir Ollivier, 2017).
9.7.1.4 Strategijų palyginimas
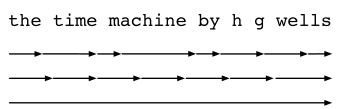
9.7.1 pav. Gradientų skaičiavimo RNN strategijų palyginimas. Iš viršaus į apačią: atsitiktinis nukirtimas, įprastas nukirtimas ir pilnas skaičiavimas.
9.7.1 pav. iliustruoja tris strategijas, analizuojant pirmuosius kelis Laiko mašinos simbolius naudojant atgalinį sklidimą laike RNN:
- Pirmoji eilutė yra atsitiktinis nukirtimas, kuris skaido tekstą į skirtingo ilgio segmentus.
- Antroji eilutė yra įprastas nukirtimas, kuris skaido tekstą į vienodo ilgio posekius. Tai yra tai, ką darėme RNN eksperimentuose.
- Trečioji eilutė yra pilnas atgalinis sklidimas laike, vedantis prie skaičiavimo požiūriu neįgyvendinamos išraiškos.
Deja, nors teoriškai patrauklus, atsitiktinis nukirtimas neveikia daug geriau nei įprastas nukirtimas, greičiausiai dėl keleto veiksnių. Pirma, stebėjimo poveikio po keleto atgalinio sklidimo žingsnių į praeitį pakanka priklausomybėms praktikoje užfiksuoti. Antra, padidėjusi dispersija neutralizuoja faktą, kad gradientas yra tikslesnis su daugiau žingsnių. Trečia, mes iš tikrųjų norime modelių, turinčių tik trumpą sąveikų nuotolį. Todėl įprastai nukirstas atgalinis sklidimas laike turi nedidelį reguliarizuojantį poveikį, kuris gali būti pageidautinas.
9.7.2 Atgalinis sklidimas laike išsamiai
Aptarę bendrąjį principą, aptarkime atgalinį sklidimą laike išsamiai. Priešingai nei analizėje 9.7.1 skyrelis, toliau parodysime, kaip apskaičiuoti tikslo funkcijos gradientus visų išskaidytų modelio parametrų atžvilgiu. Kad viskas būtų paprasta, nagrinėjame RNN be poslinkio parametrų, kurio aktyvacijos funkcija paslėptajame sluoksnyje naudoja tapatybės atvaizdavimą (). Laiko žingsniui tegul vieno pavyzdžio įvestis ir tikslas yra atitinkamai ir . Paslėptoji būsena ir išvestis apskaičiuojamos taip:
kur , ir yra svorių parametrai. Pažymėkime nuostolį laiko žingsniu . Mūsų tikslo funkcija, nuostoliai per laiko žingsnių nuo sekos pradžios, todėl yra
Kad vizualizuotume priklausomybes tarp modelio kintamųjų ir parametrų skaičiavimo RNN metu, galime nubraižyti modelio skaičiavimo grafą, kaip parodyta 9.7.2 pav.. Pavyzdžiui, 3 laiko žingsnio paslėptųjų būsenų skaičiavimas, , priklauso nuo modelio parametrų ir , ankstesnio laiko žingsnio paslėptosios būsenos ir dabartinio laiko žingsnio įvesties .
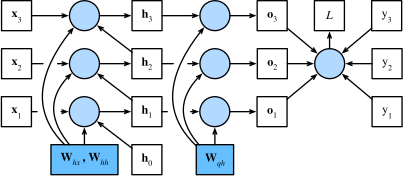
9.7.2 pav. Skaičiavimo grafas, rodantis priklausomybes RNN modeliui su trimis laiko žingsniais. Dėžutės reiškia kintamuosius (neuždengtos) arba parametrus (uždengtos), o apskritimai – operatorius.
Kaip ką tik minėta, modelio parametrai 9.7.2 pav. yra , ir . Apskritai šio modelio apmokymas reikalauja gradientų skaičiavimo šių parametrų atžvilgiu , ir . Pagal 9.7.2 pav. priklausomybes galime eiti priešinga rodyklėms kryptimi, kad paeiliui apskaičiuotume ir saugotume gradientus. Kad lanksčiai išreikštume skirtingų formų matricų, vektorių ir skaliarų daugybą grandinės taisyklėje, toliau naudojame operatorių , aprašytą 5.3 skyrelis.
Visų pirma, tikslo funkcijos diferencijavimas modelio išvesties atžvilgiu bet kuriuo laiko žingsniu yra gana paprastas:
Dabar galime apskaičiuoti tikslo gradientą išvesties sluoksnio parametro atžvilgiu: . Remiantis 9.7.2 pav., tikslas priklauso nuo per . Pritaikius grandinės taisyklę, gaunama
kur pateikiamas (9.7.6).
Toliau, kaip parodyta 9.7.2 pav., paskutiniu laiko žingsniu tikslo funkcija priklauso nuo paslėptosios būsenos tik per . Todėl galime lengvai rasti gradientą naudodami grandinės taisyklę:
Sudėtingiau yra bet kuriam laiko žingsniui , kur tikslo funkcija priklauso nuo per ir . Pagal grandinės taisyklę, paslėptosios būsenos gradientą bet kuriuo laiko žingsniu galima rekurentiškai apskaičiuoti taip:
Analizei išskleidus rekurentinį skaičiavimą bet kuriam laiko žingsniui , gaunama
Iš (9.7.9) matome, kad šis paprastas tiesinis pavyzdys jau parodo kai kurias pagrindines ilgų sekų modelių problemas: jis apima potencialiai labai dideles laipsnius. Jame tikrinės reikšmės, mažesnės nei 1, išnyksta, o didesnės nei 1 – diverguoja. Tai skaitiniu požiūriu nestabilu, o tai pasireiškia nykstančiais ir sprogstančiais gradientais. Vienas būdas tai spręsti yra nukirsti laiko žingsnius skaičiavimo požiūriu patogiu dydžiu, kaip aptarta 9.7.1 skyrelis. Praktikoje šį nukirtimą taip pat galima atlikti atjungiant gradientą po tam tikro laiko žingsnių skaičiaus. Vėliau pamatysime, kaip sudėtingesni sekų modeliai, tokie kaip ilga trumpalaikė atmintis, gali tai dar labiau sušvelninti.
Galiausiai 9.7.2 pav. rodo, kad tikslo funkcija priklauso nuo modelio parametrų ir paslėptajame sluoksnyje per paslėptąsias būsenas . Kad apskaičiuotume gradientus šių parametrų atžvilgiu ir , taikome grandinės taisyklę, gaudami
kur , kuris rekurentiškai apskaičiuojamas pagal (9.7.7) ir (9.7.8), yra pagrindinis dydis, darantis įtaką skaitiniam stabilumui.
Kadangi atgalinis sklidimas laike yra atgalinio sklidimo taikymas RNN, kaip paaiškinome 5.3 skyrelis, RNN apmokymas kaitaliuoja tiesioginį sklidimą su atgaliniu sklidimu laike. Be to, atgalinis sklidimas laike paeiliui apskaičiuoja ir saugo aukščiau pateiktus gradientus. Konkrečiai, saugomos tarpinės reikšmės naudojamos pakartotinai, kad būtų išvengta dubliuotų skaičiavimų, pavyzdžiui, saugojamas , kuris naudojamas skaičiuojant ir , ir .
9.7.3 Santrauka
Atgalinis sklidimas laike yra tik atgalinio sklidimo taikymas sekų modeliams su paslėptąja būsena. Nukirtimas, įprastas ar atsitiktinis, reikalingas skaičiavimo patogumui ir skaitiniam stabilumui. Dideli matricų laipsniai gali lemti diverguojančias ar nykstančias tikrines reikšmes. Tai pasireiškia sprogstančiais ar nykstančiais gradientais. Efektyviam skaičiavimui atgalinio sklidimo laike metu tarpinės reikšmės talpinamos podėlyje.
9.7.4 Pratimai
- Tarkime, kad turime simetrinę matricą su tikrinėmis reikšmėmis , kurias atitinkantys tikriniai vektoriai yra (). Be bendrumo apribojimo, tarkime, kad jos išdėstytos tvarka .
- Parodykite, kad turi tikrines reikšmes .
- Įrodykite, kad atsitiktiniam vektoriui su didele tikimybe bus labai gerai sulygiuotas su tikriniu vektoriumi . Formalizuokite šį teiginį.
- Ką aukščiau pateiktas rezultatas reiškia gradientams RNN?
- Be gradientų apkarpymo, ar galite sugalvoti kitų būdų susidoroti su gradientų sprogimu rekurentiniuose neuroniniuose tinkluose?