
9.3 Kalbos modeliai
9.2 skyrelis matėme, kaip tekstų sekas atvaizduoti teksto vienetais, kuriuos galima laikyti diskrečių stebėjimų, pavyzdžiui, žodžių ar simbolių, seka. Tarkime, kad teksto sekos ilgio teksto vienetai yra . Kalbos modelių tikslas yra įvertinti visos sekos jungtinę tikimybę:
kur galima taikyti statistinius įrankius iš 9.1 skyrelis.
Kalbos modeliai yra nepaprastai naudingi. Pavyzdžiui, idealus kalbos modelis turėtų pats generuoti natūralų tekstą, tiesiog po vieną imdamas teksto vienetą . Visiškai kitaip nei beždžionė, naudojanti rašomąją mašinėlę, visas tokio modelio sugeneruotas tekstas atrodytų kaip natūrali kalba, pvz., anglų kalbos tekstas. Be to, to pakaktų prasmingam dialogui generuoti, tiesiog sąlygojant tekstą pagal ankstesnius dialogo fragmentus. Akivaizdu, kad vis dar esame labai toli nuo tokios sistemos sukūrimo, nes jai reikėtų suprasti tekstą, o ne tik generuoti gramatiškai prasmingą turinį.
Nepaisant to, kalbos modeliai labai pravarto net ir ribota forma. Pavyzdžiui, frazės „to recognize speech“ ir „to wreck a nice beach“ skamba labai panašiai. Tai gali sukelti dviprasmiškumą kalbos atpažinime, kuris lengvai išsprendžiamas per kalbos modelį, atmetantį antrą variantą kaip nepagrįstą. Lygiai taip pat dokumentų santraukų algoritme verta žinoti, kad „dog bites man“ pasitaiko daug dažniau nei „man bites dog“, o „I want to eat grandma“ yra gana šokiruojantis teiginys, o „I want to eat, grandma“ – daug nekaltesnis.
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
from d2l import torch as d2l
import torch
from d2l import tensorflow as d2l
import tensorflow as tf
from d2l import jax as d2l
from jax import numpy as jnp
9.3.1 Kalbos modelių mokymasis
Akivaizdus klausimas, kaip turėtume modeliuoti dokumentą ar net teksto vienetų seką. Tarkime, kad tekstinius duomenis skaidome žodžių lygiu. Pradėkime nuo pagrindinių tikimybių taisyklių taikymo:
Pavyzdžiui, teksto sekos, kurioje yra keturi žodžiai, tikimybė būtų tokia:
9.3.1.1 Markovo modeliai ir -gramos
Iš 9.1 skyrelis sekų modelių analizių pritaikykime Markovo modelius kalbos modeliavimui. Sekų skirstinys tenkina pirmosios eilės Markovo savybę, jei . Aukštesnės eilės atitinka ilgesnes priklausomybes. Tai veda prie keleto aproksimacijų, kurias galėtume taikyti sekai modeliuoti:
Tikimybių formulės, apimančios vieną, du ir tris kintamuosius, paprastai vadinamos atitinkamai unigramų, bigramų ir trigramų modeliais. Kad apskaičiuotume kalbos modelį, turime apskaičiuoti žodžių tikimybę ir žodžio sąlyginę tikimybę, žinant kelis ankstesnius žodžius. Atkreipkite dėmesį, kad tokios tikimybės yra kalbos modelio parametrai.
9.3.1.2 Žodžių dažnis
Čia darome prielaidą, kad mokymo duomenų rinkinys yra didelis teksto tekstynas, pavyzdžiui, visi Vikipedijos įrašai, Gutenbergo projektas ir visas internete paskelbtas tekstas. Žodžių tikimybę galima apskaičiuoti pagal santykinį duoto žodžio dažnį mokymo duomenų rinkinyje. Pavyzdžiui, įvertį galima apskaičiuoti kaip bet kurio sakinio, prasidedančio žodžiu „deep“, tikimybę. Šiek tiek mažiau tikslus būdas būtų suskaičiuoti visus žodžio „deep“ pasikartojimus ir padalyti iš bendro žodžių skaičiaus tekstyne. Tai veikia gana gerai, ypač dažniems žodžiams. Eidami toliau, galėtume bandyti įvertinti
kur ir yra pavienių žodžių ir iš eilės einančių žodžių porų pasikartojimų skaičius. Deja, žodžių poros tikimybę įvertinti šiek tiek sunkiau, nes „deep learning“ pasikartojimų yra daug mažiau. Visų pirma kai kuriems neįprastiems žodžių deriniams gali būti sunku rasti pakankamai pasikartojimų tiksliems įverčiams gauti. Kaip rodo empiriniai rezultatai 9.2.5 skyrelis, situacija pablogėja trijų žodžių ir didesniems deriniams. Bus daug tikėtinų trijų žodžių derinių, kurių greičiausiai nematysime savo duomenų rinkinyje. Jei nepateiksime kokio nors sprendimo tokiems žodžių deriniams priskirti nenulinį skaičių, negalėsime jų naudoti kalbos modelyje. Jei duomenų rinkinys mažas arba žodžiai labai reti, galime nerasti nė vieno jų.
9.3.1.3 Laplaso glotninimas
Įprasta strategija – atlikti tam tikrą Laplaso glotninimo formą. Sprendimas yra pridėti nedidelę konstantą prie visų skaičių. Pažymėkime bendrą žodžių skaičių mokymo rinkinyje, o – unikalių žodžių skaičių. Šis sprendimas padeda su pavieniais žodžiais, pvz., per
Čia ir yra hiperparametrai. Paimkime kaip pavyzdį: kai , glotninimas netaikomas; kai artėja prie teigiamos begalybės, artėja prie tolygiosios tikimybės . Tai gana primityvus variantas to, ką gali pasiekti kitos technikos (Wood ir kt., 2011).
Deja, tokie modeliai gana greitai tampa nepatogūs dėl šių priežasčių. Pirma, kaip aptarta 9.2.5 skyrelis, daug -gramų pasitaiko labai retai, todėl Laplaso glotninimas gana netinka kalbos modeliavimui. Antra, turime saugoti visus skaičius. Trečia, tai visiškai ignoruoja žodžių prasmę. Pavyzdžiui, „cat“ ir „feline“ turėtų pasitaikyti susijusiuose kontekstuose. Tokius modelius labai sunku pritaikyti papildomiems kontekstams, o giliuoju mokymusi pagrįsti kalbos modeliai puikiai tinka tai įvertinti. Galiausiai ilgos žodžių sekos beveik tikrai yra naujos, todėl modelis, kuris tiesiog skaičiuoja anksčiau matytų žodžių sekų dažnį, tikrai veiks prastai. Todėl likusioje skyriaus dalyje sutelkiame dėmesį į neuroninių tinklų naudojimą kalbos modeliavimui.
9.3.2 Painumas
Toliau aptarkime, kaip matuoti kalbos modelio kokybę, kurią vėliau naudosime savo modeliams vertinti kituose skyreliuose. Vienas būdas – patikrinti, kiek tekstas stebina. Geras kalbos modelis gali labai tiksliai prognozuoti teksto vienetus, kurie ateina toliau. Panagrinėkite šiuos frazės „It is raining“ tęsinius, pasiūlytus skirtingų kalbos modelių:
- „It is raining outside“
- „It is raining banana tree“
- „It is raining piouw;kcj pwepoiut“
Kokybės požiūriu 1 pavyzdys akivaizdžiai geriausias. Žodžiai yra prasmingi ir logiškai nuoseklūs. Nors jis gali ir nelabai tiksliai atspindėti, kuris žodis semantiškai seka („in San Francisco“ ir „in winter“ būtų buvę visiškai pagrįsti tęsiniai), modelis geba užfiksuoti, kokio tipo žodis seka. 2 pavyzdys yra gerokai blogesnis, nes sukuria beprasmį tęsinį. Vis dėlto bent jau modelis išmoko rašyti žodžius ir tam tikro laipsnio koreliaciją tarp žodžių. Galiausiai 3 pavyzdys rodo prastai apmokytą modelį, kuris tinkamai neatitinka duomenų.
Modelio kokybę galėtume matuoti skaičiuodami sekos tikėtinumą. Deja, tai skaičius, kurį sunku suprasti ir sunku palyginti. Juk trumpesnės sekos pasitaiko kur kas tikėtiniau nei ilgesnės, todėl modelio vertinimas pagal Tolstojaus šedevrą Karas ir taika neišvengiamai duos daug mažesnį tikėtinumą nei, pavyzdžiui, pagal Saint-Exupéry apysaką Mažasis princas. Trūksta vidurkio atitikmens.
Čia praverčia informacijos teorija. Entropiją, nuostabą ir kryžminę entropiją apibrėžėme, kai pristatėme softmax regresiją (4.1.3 skyrelis). Jei norime suglaudinti tekstą, galime klausti apie kito teksto vieneto prognozavimą, turint dabartinį teksto vienetų rinkinį. Geresnis kalbos modelis turėtų leisti tiksliau prognozuoti kitą teksto vienetą. Taigi jis turėtų leisti sunaudoti mažiau bitų sekai suglaudinti. Todėl galime jį matuoti kryžminės entropijos nuostoliu, vidurkintu per visus sekos teksto vienetų:
kur pateikia kalbos modelis, o yra faktinis teksto vienetas, stebėtas sekoje laiko žingsniu . Tai daro skirtingo ilgio dokumentų našumą palyginamą. Dėl istorinių priežasčių natūraliosios kalbos apdorojimo mokslininkai mieliau naudoja dydį, vadinamą painumu (angl. perplexity). Trumpai tariant, tai (9.3.1) eksponentė:
Painumą geriausia suprasti kaip realių pasirinkimų, kuriuos turime nuspręsdami, kurį teksto vienetą rinktis toliau, skaičiaus geometrinio vidurkio atvirkštinį dydį. Pažvelkime į keletą atvejų:
- Geriausiu atveju modelis visada tobulai įvertina tikslinio teksto vieneto tikimybę kaip 1. Šiuo atveju modelio painumas yra 1.
- Blogiausiu atveju modelis visada prognozuoja tikslinio teksto vieneto tikimybę kaip 0. Šioje situacijoje painumas yra teigiama begalybė.
- Bazinėje linijoje modelis prognozuoja tolygųjį skirstinį per visus turimus žodyno teksto vienetus. Šiuo atveju painumas lygus unikalių žodyno teksto vienetų skaičiui. Iš tikrųjų, jei saugotume seką be jokio glaudinimo, tai būtų geriausia, ką galėtume padaryti ją koduodami. Todėl tai suteikia netrivialią viršutinę ribą, kurią turi įveikti bet kuris naudingas modelis.
9.3.3 Sekų skaidymas
Kalbos modelius projektuosime naudodami neuroninius tinklus ir naudosime painumą, kad įvertintume, kaip gerai modelis prognozuoja kitą teksto vienetą, turint dabartinį teksto vienetų rinkinį teksto sekose. Prieš pristatydami modelį, tarkime, kad jis vienu metu apdoroja minirinkinį iš iš anksto nustatyto ilgio sekų. Dabar klausimas, kaip atsitiktinai skaityti įvesties sekų ir tikslinių sekų minirinkinius.
Tarkime, kad duomenų rinkinys yra teksto vienetų indeksų seka corpus.
Suskaidysime ją
į posekius, kur kiekvienas posekis turi teksto vienetų (laiko žingsnių).
Kad kiekvienai epochai iteruotume per
(beveik) visus viso duomenų rinkinio teksto vienetus
ir gautume visus galimus ilgio posekius,
galime įvesti atsitiktinumą.
Konkrečiau,
kiekvienos epochos pradžioje
atmetame pirmuosius teksto vienetų,
kur atsitiktinai imamas tolygiai.
Likusi sekos dalis
tada skaidoma
į posekių.
Pažymėkime ilgio posekį, prasidedantį nuo teksto vieneto laiko žingsniu .
Gauti suskaidytų posekių yra
Kiekvienas posekis bus naudojamas kaip įvesties seka kalbos modeliui.
Kalbos modeliavimui tikslas yra prognozuoti kitą teksto vienetą pagal iki šiol matytus teksto vienetus; todėl tikslai (žymenys) yra originali seka, pastumta vienu teksto vienetu. Bet kurios įvesties sekos tikslinė seka yra , kurios ilgis .
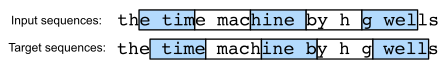
9.3.1 pav. Penkių įvesties sekų ir tikslinių sekų porų gavimas iš suskaidytų ilgio 5 posekių.
9.3.1 pav. parodytas penkių įvesties sekų ir tikslinių sekų porų gavimo pavyzdys, kai ir .
@d2l.add_to_class(d2l.TimeMachine)  #@save
def __init__(self, batch_size, num_steps, num_train=10000, num_val=5000):
    super(d2l.TimeMachine, self).__init__()
    self.save_hyperparameters()
    corpus, self.vocab = self.build(self._download())
    array = d2l.tensor([corpus[i:i+num_steps+1]
                        for i in range(len(corpus)-num_steps)])
    self.X, self.Y = array[:,:-1], array[:,1:]
Kalbos modeliams apmokyti
atsitiktinai imsime
įvesties sekų ir tikslinių sekų poras
minirinkiniuose.
Šis duomenų įkėliklis kiekvieną kartą atsitiktinai sugeneruoja minirinkinį iš duomenų rinkinio.
Argumentas batch_size nurodo posekių pavyzdžių skaičių kiekviename minirinkinyje,
o num_steps yra posekio ilgis teksto vienetais.
@d2l.add_to_class(d2l.TimeMachine)  #@save
def get_dataloader(self, train):
    idx = slice(0, self.num_train) if train else slice(
        self.num_train, self.num_train + self.num_val)
    return self.get_tensorloader([self.X, self.Y], train, idx)
Kaip matome toliau, tikslinių sekų minirinkinį galima gauti pastūmus įvesties sekas vienu teksto vienetu.
data = d2l.TimeMachine(batch_size=2, num_steps=10)
for X, Y in data.train_dataloader():
    print('X:', X, '\nY:', Y)
    break
9.3.4 Santrauka ir diskusija
Kalbos modeliai įvertina teksto sekos jungtinę tikimybę. Ilgoms sekoms -gramos yra patogus modelis, nes sutrumpina priklausomybę. Tačiau yra daug struktūros, bet nepakanka dažnio, kad efektyviai susidorotume su retais žodžių deriniais per Laplaso glotninimą. Todėl vėlesniuose skyreliuose sutelksime dėmesį į neuroninį kalbos modeliavimą. Kalbos modeliams apmokyti galime atsitiktinai imti įvesties sekų ir tikslinių sekų poras minirinkiniuose. Po apmokymo naudosime painumą kalbos modelio kokybei matuoti.
Kalbos modelius galima didinti didinant duomenų dydį, modelio dydį ir apmokymo skaičiavimų kiekį. Dideli kalbos modeliai gali atlikti norimas užduotis prognozuodami išvesties tekstą pagal įvesties teksto nurodymus. Kaip aptarsime vėliau (pvz., 11.9 skyrelis), šiuo metu dideli kalbos modeliai sudaro pažangiausių įvairių užduočių sistemų pagrindą.
9.3.5 Pratimai
- Tarkime, mokymo duomenų rinkinyje yra 100 000 žodžių. Kiek žodžių dažnių ir kelių gretimų žodžių dažnių turi saugoti keturgramė?
- Kaip modeliuotumėte dialogą?
- Kokių kitų ilgų sekų duomenų skaitymo metodų galite sugalvoti?
- Apsvarstykite mūsų metodą atmesti tolygiai atsitiktinį skaičių pirmųjų teksto vienetų kiekvienos epochos pradžioje.
- Ar tai tikrai lemia visiškai tolygų sekų skirstinį dokumente?
- Ką reikėtų padaryti, kad viskas būtų dar tolygiau?
- Jei norime, kad sekos pavyzdys būtų pilnas sakinys, kokią problemą tai sukelia minirinkinių atrankoje? Kaip ją galime ištaisyti?