
13.2 Asinchroniniai skaičiavimai
Šiandieniniai kompiuteriai yra labai lygiagrečios sistemos, sudarytos iš kelių CPU branduolių (dažnai su keliomis gijomis kiekvienam branduoliui), kelių apdorojimo elementų kiekviename GPU ir dažnai kelių GPU kiekviename įrenginyje. Trumpai tariant, galime apdoroti daug skirtingų dalykų vienu metu, dažnai skirtinguose įrenginiuose. Deja, Python nėra puikus būdas rašyti lygiagretų ir asinchroninį kodą, bent jau be papildomos pagalbos. Juk Python yra vienagijis, ir tai vargu ar pasikeis ateityje. Giliojo mokymosi karkasai, tokie kaip MXNet ir TensorFlow, naudoja asinchroninio programavimo modelį našumui pagerinti, o PyTorch naudoja paties Python planuoklį, todėl našumo kompromisas yra kitoks. PyTorch pagal numatytuosius nustatymus GPU operacijos yra asinchroninės. Kai iškviečiate funkciją, naudojančią GPU, operacijos įtraukiamos į konkretaus įrenginio eilę, bet nebūtinai įvykdomos iš karto, o tik vėliau. Tai leidžia mums vykdyti daugiau skaičiavimų lygiagrečiai, įskaitant operacijas CPU ar kituose GPU.
Todėl supratimas, kaip veikia asinchroninis programavimas, padeda mums kurti efektyvesnes programas proaktyviai mažinant skaičiavimo reikalavimus ir tarpusavio priklausomybes. Tai leidžia sumažinti atminties pridėtines sąnaudas ir padidinti procesorių panaudojimą.
from d2l import mxnet as d2l
import numpy, os, subprocess
from mxnet import autograd, gluon, np, npx
from mxnet.gluon import nn
npx.set_np()
from d2l import torch as d2l
import numpy, os, subprocess
import torch
from torch import nn
13.2.1 Asinchroniškumas per vidinę dalį
Apšilimui panagrinėkime tokį žaislinį uždavinį: norime sugeneruoti atsitiktinę matricą ir ją sudauginti. Padarykime tai ir su NumPy, ir su mxnet.np, kad pamatytume skirtumą.
Apšilimui panagrinėkime tokį žaislinį uždavinį: norime sugeneruoti atsitiktinę matricą ir ją sudauginti. Padarykime tai ir su NumPy, ir su PyTorch tenzoriumi, kad pamatytume skirtumą.
Atkreipkite dėmesį, kad PyTorch tensor apibrėžtas GPU.
with d2l.Benchmark('numpy'):
    for _ in range(10):
        a = numpy.random.normal(size=(1000, 1000))
        b = numpy.dot(a, a)

with d2l.Benchmark('mxnet.np'):
    for _ in range(10):
        a = np.random.normal(size=(1000, 1000))
        b = np.dot(a, a)
# Warmup for GPU computation
device = d2l.try_gpu()
a = torch.randn(size=(1000, 1000), device=device)
b = torch.mm(a, a)

with d2l.Benchmark('numpy'):
    for _ in range(10):
        a = numpy.random.normal(size=(1000, 1000))
        b = numpy.dot(a, a)

with d2l.Benchmark('torch'):
    for _ in range(10):
        a = torch.randn(size=(1000, 1000), device=device)
        b = torch.mm(a, a)
Lyginamosios analizės išvestis per MXNet yra eilėmis greitesnė. Kadangi abi vykdomos tame pačiame procesoriuje, turi vykti kažkas kita. Priversdami MXNet baigti visus vidinės dalies skaičiavimus prieš grąžinant rezultatą, matome, kas anksčiau įvyko: skaičiavimas vykdomas vidinėje dalyje, o priekinė dalis grąžina valdymą Python.
Lyginamosios analizės išvestis per PyTorch yra eilėmis greitesnė. NumPy skaliarinė sandauga vykdoma CPU procesoriuje, o PyTorch matricų daugyba vykdoma GPU, todėl tikimasi, kad pastaroji bus daug greitesnė. Tačiau didžiulis laiko skirtumas rodo, kad turi vykti kažkas kita. PyTorch pagal numatytuosius nustatymus GPU operacijos yra asinchroninės. Priversdami PyTorch baigti visus skaičiavimus prieš grąžinant rezultatą, matome, kas anksčiau įvyko: skaičiavimas vykdomas vidinėje dalyje, o priekinė dalis grąžina valdymą Python.
with d2l.Benchmark():
    for _ in range(10):
        a = np.random.normal(size=(1000, 1000))
        b = np.dot(a, a)
    npx.waitall()
with d2l.Benchmark():
    for _ in range(10):
        a = torch.randn(size=(1000, 1000), device=device)
        b = torch.mm(a, a)
    torch.cuda.synchronize(device)
Plačiai kalbant, MXNet turi priekinę dalį (angl. frontend) tiesioginei sąveikai su naudotojais, pavyzdžiui, per Python, taip pat vidinę dalį (angl. backend), kurią sistema naudoja skaičiavimams atlikti. Kaip parodyta 13.2.1 pav., naudotojai gali rašyti MXNet programas įvairiomis priekinės dalies kalbomis, pavyzdžiui, Python, R, Scala ir C++. Nepriklausomai nuo naudojamos priekinės dalies programavimo kalbos, MXNet programų vykdymas vyksta daugiausia vidinėje C++ įgyvendinimų dalyje. Priekinės dalies kalbos išduotos operacijos perduodamos vidinei daliai vykdyti. Vidinė dalis valdo savo gijas, kurios nuolat renka ir vykdo eilėje esančias užduotis. Atkreipkite dėmesį, kad tam, kad tai veiktų, vidinė dalis turi gebėti sekti priklausomybes tarp įvairių skaičiavimo grafo žingsnių. Todėl negalima lygiagretinti operacijų, kurios priklauso viena nuo kitos.
Plačiai kalbant, PyTorch turi priekinę dalį (angl. frontend) tiesioginei sąveikai su naudotojais, pavyzdžiui, per Python, taip pat vidinę dalį (angl. backend), kurią sistema naudoja skaičiavimams atlikti. Kaip parodyta 13.2.1 pav., naudotojai gali rašyti PyTorch programas įvairiomis priekinės dalies kalbomis, pavyzdžiui, Python ir C++. Nepriklausomai nuo naudojamos priekinės dalies programavimo kalbos, PyTorch programų vykdymas vyksta daugiausia vidinėje C++ įgyvendinimų dalyje. Priekinės dalies kalbos išduotos operacijos perduodamos vidinei daliai vykdyti. Vidinė dalis valdo savo gijas, kurios nuolat renka ir vykdo eilėje esančias užduotis. Atkreipkite dėmesį, kad tam, kad tai veiktų, vidinė dalis turi gebėti sekti priklausomybes tarp įvairių skaičiavimo grafo žingsnių. Todėl negalima lygiagretinti operacijų, kurios priklauso viena nuo kitos.
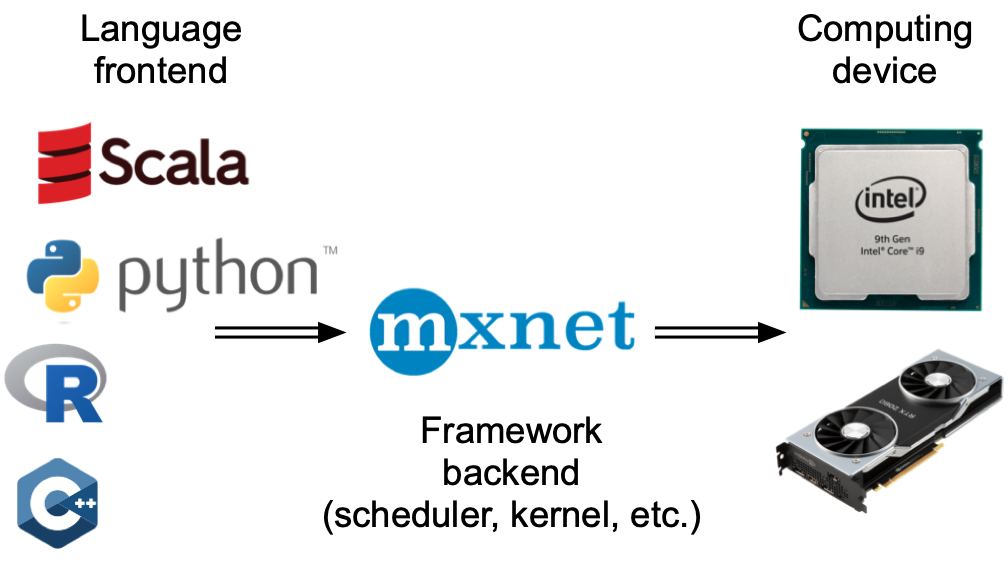
13.2.1 pav. Programavimo kalbų priekinės dalys ir giliojo mokymosi karkasų vidinės dalys.
Pažiūrėkime į kitą žaislinį pavyzdį, kad geriau suprastume priklausomybių grafą.
x = np.ones((1, 2))
y = np.ones((1, 2))
z = x * y + 2
z
x = torch.ones((1, 2), device=device)
y = torch.ones((1, 2), device=device)
z = x * y + 2
z
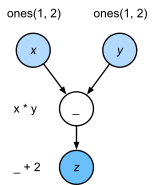
13.2.2 pav. Vidinė dalis seka priklausomybes tarp įvairių skaičiavimo grafo žingsnių.
Aukščiau pateiktas kodo fragmentas taip pat iliustruotas 13.2.2 pav..
Kai Python priekinės dalies gija vykdo vieną iš pirmųjų trijų sakinių, ji tiesiog grąžina užduotį į vidinės dalies eilę. Kai paskutinio sakinio rezultatus reikia atspausdinti, Python priekinės dalies gija lauks, kol C++ vidinės dalies gija baigs skaičiuoti kintamojo z rezultatą. Vienas šio dizaino privalumas yra tas, kad Python priekinės dalies gijai nereikia atlikti tikrų skaičiavimų. Todėl bendram programos našumui turi mažai įtakos, koks yra paties Python našumas. 13.2.3 pav. iliustruoja, kaip sąveikauja priekinė ir vidinė dalys.
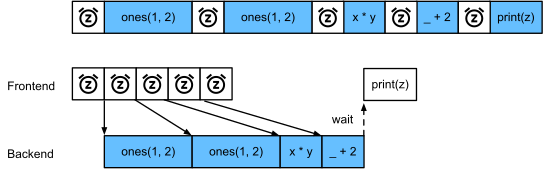
13.2.3 pav. Priekinės ir vidinės dalių sąveika.
13.2.2 Barjerai ir blokatoriai
Yra keletas operacijų, kurios privers Python laukti, kol jos bus baigtos:
- Akivaizdžiausia,
npx.waitall()laukia, kol baigsis visi skaičiavimai, nepriklausomai nuo to, kada skaičiavimo instrukcijos buvo išduotos. Praktikoje šį operatorių naudoti yra bloga idėja, nebent tai būtina, nes tai gali lemti prastą našumą. - Jei tiesiog norime palaukti, kol bus pasiekiamas konkretus kintamasis, galime iškviesti
z.wait_to_read(). Šiuo atveju MXNet blokuoja grįžimą į Python, kol bus apskaičiuotas kintamasisz. Kiti skaičiavimai po to gali tęstis.
Pažiūrėkime, kaip tai veikia praktiškai.
with d2l.Benchmark('waitall'):
    b = np.dot(a, a)
    npx.waitall()

with d2l.Benchmark('wait_to_read'):
    b = np.dot(a, a)
    b.wait_to_read()
Abi operacijos užtrunka maždaug tiek pat laiko. Be akivaizdžių blokuojančių operacijų, rekomenduojame žinoti apie numanomus blokatorius. Kintamojo spausdinimas akivaizdžiai reikalauja, kad kintamasis būtų pasiekiamas, todėl yra blokatorius. Galiausiai konvertavimai į NumPy per z.asnumpy() ir konvertavimai į skaliarus per z.item() yra blokuojantys, nes NumPy neturi asinchroniškumo sąvokos. Jam reikia prieigos prie reikšmių, kaip ir funkcijai print.
Dažnai kopijuoti nedidelius duomenų kiekius iš MXNet srities į NumPy ir atgal gali sugriauti kitaip efektyvaus kodo našumą, nes kiekviena tokia operacija reikalauja, kad skaičiavimo grafas įvertintų visus tarpinius rezultatus, reikalingus atitinkamam nariui gauti, prieš galint daryti bet ką kita.
with d2l.Benchmark('numpy conversion'):
    b = np.dot(a, a)
    b.asnumpy()

with d2l.Benchmark('scalar conversion'):
    b = np.dot(a, a)
    b.sum().item()
13.2.3 Skaičiavimo gerinimas
Labai daugiagijėje sistemoje (net įprasti nešiojamieji kompiuteriai turi 4 ar daugiau gijų, o kelių lizdų serveriuose šis skaičius gali viršyti 256) operacijų planavimo pridėtinės sąnaudos gali tapti reikšmingos. Todėl labai pageidautina, kad skaičiavimas ir planavimas vyktų asinchroniškai ir lygiagrečiai. Kad parodytume tokio požiūrio naudą, pažiūrėkime, kas nutinka, jei kelis kartus padidiname kintamąjį 1, nuosekliai arba asinchroniškai. Sinchroninį vykdymą imituojame įterpdami wait_to_read barjerą tarp kiekvieno pridėjimo.
with d2l.Benchmark('synchronous'):
    for _ in range(10000):
        y = x + 1
        y.wait_to_read()

with d2l.Benchmark('asynchronous'):
    for _ in range(10000):
        y = x + 1
    npx.waitall()
Kiek supaprastintą Python priekinės dalies gijos ir C++ vidinės dalies gijos sąveiką galima apibendrinti taip:
- Priekinė dalis nurodo vidinei daliai įterpti skaičiavimo užduotį
y = x + 1į eilę. - Tada vidinė dalis gauna skaičiavimo užduotis iš eilės ir atlieka tikruosius skaičiavimus.
- Tada vidinė dalis grąžina skaičiavimo rezultatus priekinei daliai. Tarkime, kad šių trijų etapų trukmės yra atitinkamai ir . Jei nenaudojame asinchroninio programavimo, bendras laikas, reikalingas 10000 skaičiavimų atlikti, yra apytiksliai . Jei naudojamas asinchroninis programavimas, bendras laikas, reikalingas 10000 skaičiavimų atlikti, gali sumažėti iki (darant prielaidą, kad ), nes priekinei daliai nereikia laukti, kol vidinė dalis grąžins skaičiavimo rezultatus kiekvienoje ciklo iteracijoje.
13.2.4 Santrauka
- Giliojo mokymosi karkasai gali atskirti Python priekinę dalį nuo vykdymo vidinės dalies. Tai leidžia greitai asinchroniškai įterpti komandas į vidinę dalį ir gauti susijusį lygiagretumą.
- Asinchroniškumas lemia gana greitai reaguojančią priekinę dalį. Tačiau būkite atsargūs ir nepripildykite užduočių eilės, nes tai gali lemti pernelyg didelį atminties suvartojimą. Rekomenduojama sinchronizuoti kiekvienam minirinkiniui, kad priekinė ir vidinė dalys išliktų apytiksliai sinchronizuotos.
- Lustų gamintojai siūlo sudėtingus našumo analizės įrankius, kad būtų galima gauti daug smulkesnį supratimą apie giliojo mokymosi efektyvumą.
- Atminkite, kad konvertavimai iš MXNet atminties valdymo į Python privers vidinę dalį laukti, kol bus paruoštas konkretus kintamasis. Tokias funkcijas kaip
print,asnumpyiritemvisos turi šį poveikį. Tai gali būti pageidautina, bet neapgalvotas sinchronizavimo naudojimas gali sugadinti našumą.
13.2.5 Pratimai
- Aukščiau minėjome, kad naudojant asinchroninį skaičiavimą bendrą laiką, reikalingą 10000 skaičiavimų atlikti, galima sumažinti iki . Kodėl čia turime daryti prielaidą ?
- Išmatuokite skirtumą tarp
waitallirwait_to_read. Užuomina: atlikite keletą instrukcijų ir sinchronizuokite tarpiniam rezultatui.
- Atlikite tų pačių šiame skyrelyje pateiktų matricų daugybos operacijų lyginamąją analizę CPU. Ar vis tiek galite pastebėti asinchroniškumą per vidinę dalį?