
13.7 Parametrų serveriai
Pereidami nuo vieno GPU prie kelių GPU, o paskui prie kelių serverių, turinčių kelis GPU, galbūt visų išsibarsčiusių per kelias spinteles ir tinklo komutatorius, mūsų paskirstytojo ir lygiagrečiojo apmokymo algoritmai turi tapti gerokai sudėtingesni. Detalės svarbios, nes skirtingos jungtys turi labai skirtingą pralaidumą (pvz., NVLink tinkamoje aplinkoje gali pasiūlyti iki 100 GB/s per 6 jungtis, PCIe 4.0 (16 linijų) siūlo 32 GB/s, o net sparčiojo 100GbE Ethernet pralaidumas siekia tik 10 GB/s). Tuo pačiu nėra pagrįsta tikėtis, kad statistinis modeliuotojas bus tinklų ir sistemų ekspertas.
Pagrindinė parametrų serverio idėja buvo pristatyta (Smola ir Narayanamurthy, 2010) paskirstytųjų latentinių kintamųjų modelių kontekste. Vėliau (Ahmed ir kt., 2012) pateiktas siuntimo (angl. push) ir gavimo (angl. pull) semantikos aprašymas, o (Li ir kt., 2014) – sistemos ir atvirojo kodo bibliotekos aprašymas. Toliau pagrįsime efektyvumui reikalingus komponentus.
13.7.1 Duomenų lygiagretusis apmokymas
Peržvelkime duomenų lygiagretųjį požiūrį į paskirstytąjį apmokymą. Šiame skyrelyje naudosime jį atmesdami visus kitus, nes praktikoje jį gerokai paprasčiau įgyvendinti. Praktiškai nėra naudojimo atvejų (be giliojo mokymosi grafuose), kuriuose būtų pageidaujama kokia nors kita lygiagretumo strategija, nes šiais laikais GPU turi daug atminties. 13.7.1 pav. aprašo duomenų lygiagretumo variantą, kurį įgyvendinome 13.5 skyrelis. Pagrindinis jo aspektas yra tas, kad gradientų agregavimas vyksta viename GPU (GPU 0), prieš atnaujinti parametrai vėl išplatinami visiems GPU.
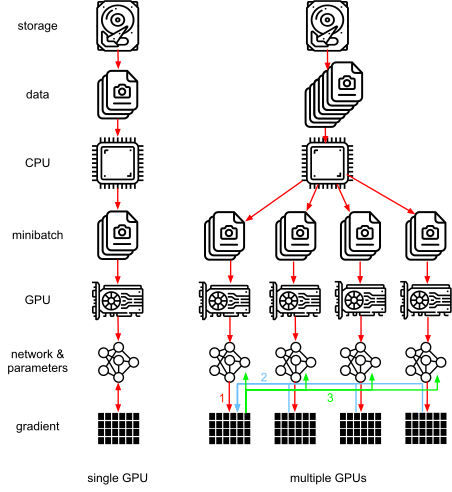
13.7.1 pav. Kairėje: apmokymas vienu GPU. Dešinėje: apmokymo keliuose GPU variantas: (1) apskaičiuojame nuostolį ir gradientą, (2) visi gradientai agreguojami viename GPU, (3) atnaujinami parametrai ir jie perskirstomi visiems GPU.
Žvelgiant atgal, sprendimas agreguoti GPU 0 atrodo gana ad hoc. Juk galėtume agreguoti ir CPU. Iš tikrųjų galėtume net nuspręsti agreguoti dalį parametrų viename GPU, o kitus – kitame. Jei optimizavimo algoritmas tai palaiko, nėra jokios realios priežasties, kodėl negalėtume. Pavyzdžiui, jei turime keturis parametrų vektorius su susijusiais gradientais , galėtume agreguoti gradientus viename GPU kiekvienam ().
Šis samprotavimas atrodo savavališkas ir lengvabūdiškas. Juk matematika visur ta pati. Tačiau mes susiduriame su tikra fizine aparatine įranga, kurioje skirtingos magistralės turi skirtingą pralaidumą, kaip aptarta 13.4 skyrelis. Panagrinėkime tikrą 4 GPU serverį, aprašytą 13.7.2 pav.. Jei jis ypač gerai sujungtas, jis gali turėti 100 GbE tinklo plokštę. Tipiškesni skaičiai yra 1–10 GbE intervale su efektyviuoju pralaidumu nuo 100 MB/s iki 1 GB/s. Kadangi CPU turi per mažai PCIe linijų, kad tiesiogiai prisijungtų prie visų GPU (pvz., vartotojiško lygio Intel CPU turi 24 linijas), mums reikia multiplekserio. Pralaidumas nuo CPU 16x Gen3 jungtimi yra 16 GB/s. Tokiu greičiu prie komutatoriaus yra prijungtas ir kiekvienas iš GPU. Tai reiškia, kad efektyviau komunikuoti tarp pačių įrenginių.
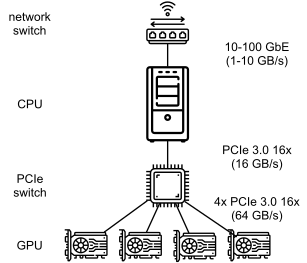
13.7.2 pav. 4 GPU serveris.
Argumentavimo tikslais tarkime, kad gradientai yra 160 MB. Šiuo atveju gradientų siuntimas iš visų 3 likusių GPU į ketvirtąjį užtrunka 30 ms (kiekvienas perdavimas užtrunka 10 ms = 160 MB / 16 GB/s). Pridėję dar 30 ms svorių vektoriams perduoti atgal, gauname iš viso 60 ms. Jei siunčiame visus duomenis į CPU, patiriame 40 ms nuobaudą, nes kiekvienas iš keturių GPU turi siųsti duomenis į CPU, gaunant iš viso 80 ms. Galiausiai tarkime, kad galime padalyti gradientus į 4 dalis po 40 MB. Dabar galime agreguoti kiekvieną dalį skirtingame GPU vienu metu, nes PCIe komutatorius suteikia pilno pralaidumo operaciją tarp visų jungčių. Vietoj 30 ms tai užtrunka 7.5 ms, o sinchronizavimo operacijai gauname iš viso 15 ms. Trumpai tariant, priklausomai nuo to, kaip sinchronizuojame parametrus, ta pati operacija gali užtrukti nuo 15 ms iki 80 ms. 13.7.3 pav. pavaizduotos skirtingos parametrų keitimosi strategijos.
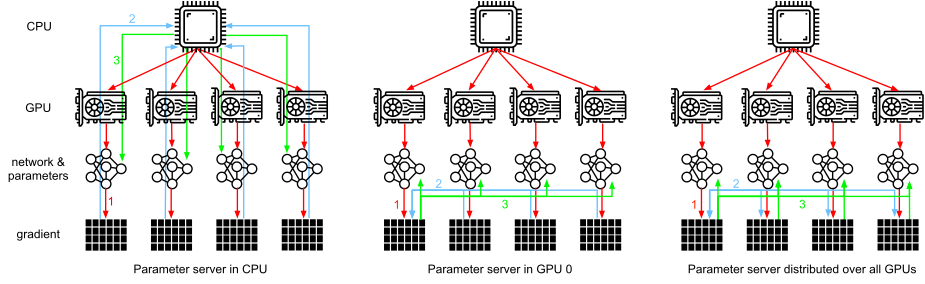
13.7.3 pav. Parametrų sinchronizavimo strategijos.
Atkreipkite dėmesį, kad turime dar vieną įrankį našumui gerinti: giliajame tinkle užtrunka tam tikrą laiką apskaičiuoti visus gradientus iš viršaus į apačią. Gradientų sinchronizavimą kai kurioms parametrų grupėms galime pradėti net kai dar esame užimti jų skaičiavimu kitoms. Žr., pvz., (Sergeev ir Del Balso, 2018) dėl detalių, kaip tai padaryti Horovod.
13.7.2 Žiedinis sinchronizavimas
Kalbant apie sinchronizavimą šiuolaikinėje giliojo mokymosi aparatinėje įrangoje, dažnai susiduriame su gerokai specializuotu tinklo ryšiu. Pavyzdžiui, AWS p3.16xlarge ir NVIDIA DGX-2 egzemplioriai turi tą pačią 13.7.4 pav. ryšio struktūrą. Kiekvienas GPU jungiasi su pagrindiniu CPU per PCIe jungtį, kuri geriausiu atveju veikia 16 GB/s greičiu. Be to, kiekvienas GPU taip pat turi 6 NVLink jungtis, kurių kiekviena geba perduoti 300 Gbit/s dvikryptiškai. Tai sudaro apie 18 GB/s vienai jungčiai viena kryptimi. Trumpai tariant, bendras NVLink pralaidumas yra gerokai didesnis nei PCIe pralaidumas. Klausimas, kaip jį efektyviausiai panaudoti.
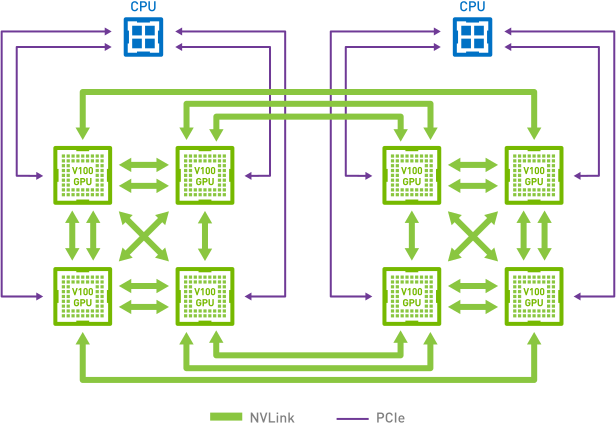
13.7.4 pav. NVLink ryšys 8 V100 GPU serveriuose (paveikslas NVIDIA sutikimu).
Pasirodo, optimali sinchronizavimo strategija yra suskaidyti tinklą į du žiedus ir juos naudoti duomenims tiesiogiai sinchronizuoti (Wang ir kt., 2018). 13.7.5 pav. iliustruoja, kad tinklą galima suskaidyti į vieną žiedą (1-2-3-4-5-6-7-8-1) su dvigubu NVLink pralaidumu ir į vieną (1-4-6-3-5-8-2-7-1) su įprastu pralaidumu. Efektyvaus sinchronizavimo protokolo projektavimas šiuo atveju nėra paprastas.
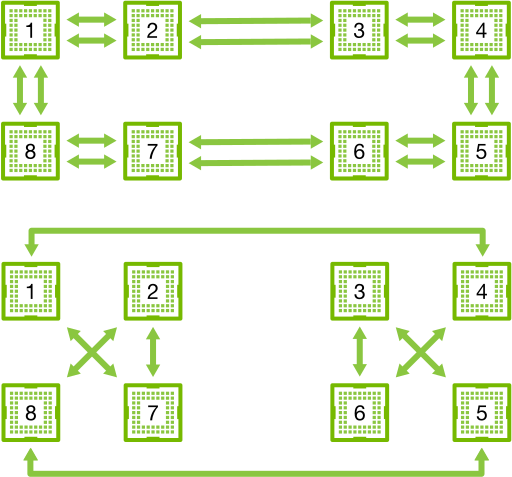
13.7.5 pav. NVLink tinklo skaidymas į du žiedus.
Panagrinėkime tokį minties eksperimentą: turint skaičiavimo mazgų (ar GPU) žiedą, galime siųsti gradientus iš pirmojo mazgo į antrąjį. Ten jis pridedamas prie lokaliojo gradiento ir siunčiamas toliau į trečiąjį mazgą ir taip toliau. Po žingsnių agreguotą gradientą galima rasti paskutiniame aplankytame mazge. Tai yra, gradientų agregavimo laikas auga tiesiškai didėjant mazgų skaičiui. Tačiau jei taip darome, algoritmas yra gana neefektyvus. Juk bet kuriuo metu komunikuoja tik vienas iš mazgų. O kas, jei suskaidytume gradientus į dalių ir pradėtume sinchronizuoti dalį pradedant mazge ? Kadangi kiekvienos dalies dydis yra , bendras laikas dabar yra . Kitaip tariant, laikas, skirtas gradientams agreguoti, neauga didėjant žiedo dydžiui. Tai gana stulbinantis rezultatas. 13.7.6 pav. iliustruoja žingsnių seką, kai mazgų.
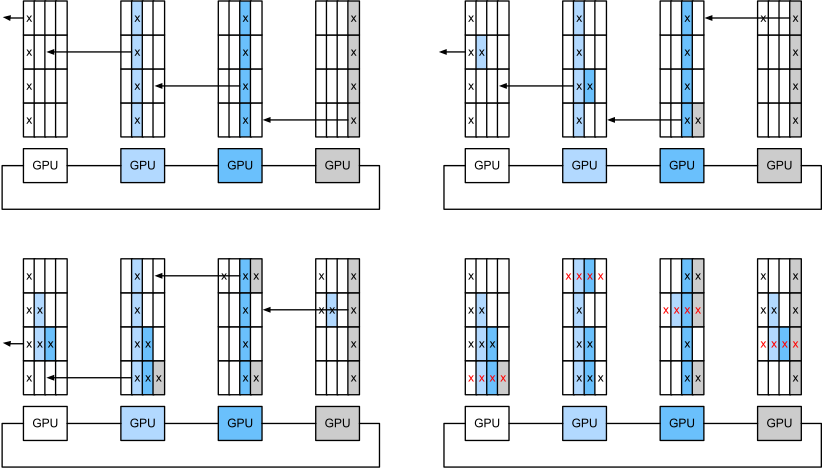
13.7.6 pav. Žiedinis sinchronizavimas per 4 mazgus. Kiekvienas mazgas pradeda siųsti gradientų dalis savo kairiajam kaimynui, kol surinktą gradientą galima rasti jo dešiniajame kaimyne.
Jei naudojame tą patį pavyzdį – 160 MB sinchronizavimą per 8 V100 GPU, gauname apytiksliai . Tai geriau nei naudoti PCIe magistralę, nors dabar naudojame 8 GPU. Atkreipkite dėmesį, kad praktikoje šie skaičiai yra šiek tiek prastesni, nes giliojo mokymosi karkasai dažnai nesugeba komunikacijos surinkti į dideles pliūpsninio perdavimo siuntas.
Atkreipkite dėmesį, kad paplitusi klaidinga nuomonė, esą žiedinis sinchronizavimas iš esmės skiriasi nuo kitų sinchronizavimo algoritmų. Vienintelis skirtumas yra tas, kad sinchronizavimo kelias yra kiek sudėtingesnis, palyginti su paprastu medžiu.
13.7.3 Apmokymas keliuose kompiuteriuose
Paskirstytasis apmokymas keliuose kompiuteriuose prideda dar vieną iššūkį: turime komunikuoti su serveriais, kurie sujungti tik palyginti mažesnio pralaidumo tinklu, kuris kai kuriais atvejais gali būti daugiau nei eile lėtesnis. Sinchronizavimas tarp įrenginių yra sudėtingas. Juk skirtingi kompiuteriai, vykdantys apmokymo kodą, turės subtiliai skirtingą greitį. Todėl, jei norime naudoti sinchroninį paskirstytąjį optimizavimą, turime juos sinchronizuoti. 13.7.7 pav. iliustruoja, kaip vyksta paskirstytasis lygiagretusis apmokymas.
- Kiekviename kompiuteryje nuskaitomas (skirtingas) duomenų rinkinys, padalijamas tarp kelių GPU ir perduodamas į GPU atmintį. Ten prognozės ir gradientai apskaičiuojami kiekvienam GPU rinkiniui atskirai.
- Visų lokaliųjų GPU gradientai agreguojami viename GPU (arba jų dalys agreguojamos skirtinguose GPU).
- Gradientai siunčiami į CPU.
- CPU siunčia gradientus į centrinį parametrų serverį, kuris agreguoja visus gradientus.
- Agreguoti gradientai tada naudojami parametrams atnaujinti, o atnaujinti parametrai išplatinami atgal atskiriems CPU.
- Informacija siunčiama vienam (ar keliems) GPU.
- Atnaujinti parametrai paskleidžiami visiems GPU.
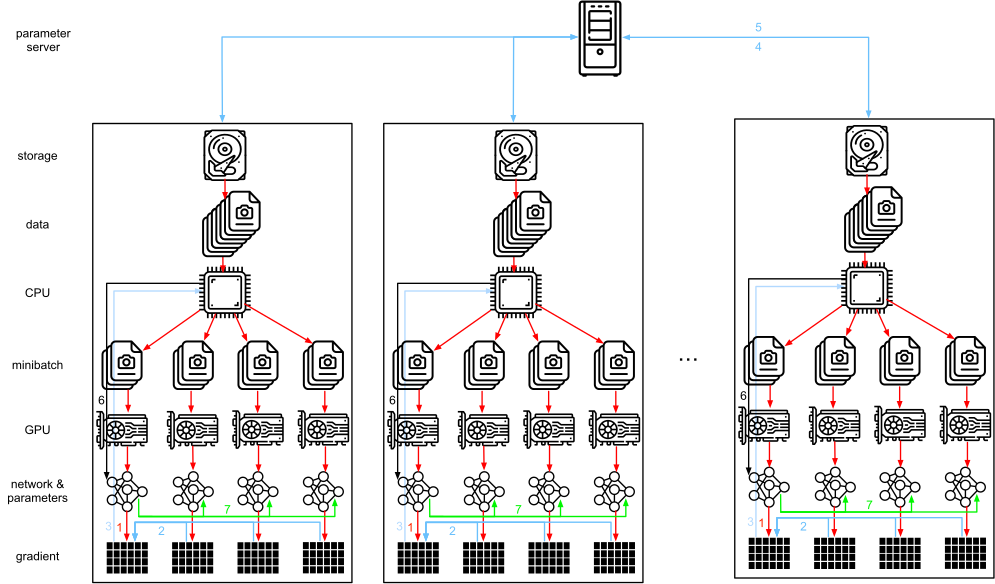
13.7.7 pav. Paskirstytasis lygiagretusis apmokymas keliuose kompiuteriuose su keliais GPU.
Kiekviena iš šių operacijų atrodo gana tiesmuka. Ir iš tikrųjų jas galima efektyviai atlikti viename kompiuteryje. Tačiau pažvelgę į kelis kompiuterius, matome, kad centrinis parametrų serveris tampa kliūtimi. Juk pralaidumas vienam serveriui yra ribotas, todėl darbininkų visų gradientų siuntimo į serverį laikas yra . Šį barjerą galime peržengti padidinę serverių skaičių iki . Šiuo atveju kiekvienam serveriui reikia saugoti tik parametrų, todėl bendras atnaujinimų ir optimizavimo laikas tampa . Suderinus abu skaičius gaunamas pastovus mastelio didėjimas nepriklausomai nuo to, kiek darbininkų turime. Praktikoje tuos pačius kompiuterius naudojame ir kaip darbininkus, ir kaip serverius. 13.7.8 pav. iliustruoja dizainą (detalių taip pat žr. (Li ir kt., 2014)). Visų pirma užtikrinti, kad keli kompiuteriai veiktų be pernelyg didelių vėlavimų, nėra paprasta.

13.7.8 pav. Viršuje: vienas parametrų serveris yra kliūtis, nes jo pralaidumas yra baigtinis. Apačioje: keli parametrų serveriai saugo parametrų dalis su bendru pralaidumu.
13.7.4 Raktų ir reikšmių saugyklos
Žingsnių, reikalingų paskirstytajam apmokymui keliuose GPU, įgyvendinimas praktikoje nėra paprastas. Todėl apsimoka naudoti bendrą abstrakciją, būtent raktų ir reikšmių saugyklą su iš naujo apibrėžta atnaujinimo semantika.
Per daugelį darbininkų ir daugelį GPU gradiento skaičiavimą galima apibrėžti kaip
kur yra gradiento dalis, padalyta GPU darbininke . Pagrindinis šios operacijos aspektas yra tas, kad tai komutacinė redukcija, t. y. ji paverčia daug vektorių vienu, o operacijos taikymo tvarka nesvarbi. Tai puiku mūsų tikslams, nes mums nereikia smulkaus valdymo, kada kuris gradientas gaunamas. Be to, atkreipkite dėmesį, kad ši operacija yra nepriklausoma tarp skirtingų .
Tai leidžia apibrėžti šias dvi operacijas: push, kuri kaupia gradientus, ir pull, kuri gauna agreguotus gradientus. Kadangi turime daug skirtingų gradientų aibių (juk turime daug sluoksnių), gradientus turime indeksuoti raktu . Šis panašumas į raktų ir reikšmių saugyklas, tokias kaip pristatyta Dynamo (DeCandia ir kt., 2007), nėra atsitiktinis. Jos taip pat tenkina daug panašių savybių, ypač kai kalbama apie parametrų paskirstymą tarp kelių serverių.
Raktų ir reikšmių saugyklų siuntimo (push) ir gavimo (pull) operacijos aprašomos taip:
- push(key, value) siunčia tam tikrą gradientą (reikšmę) iš darbininko į bendrą saugyklą. Ten reikšmė agreguojama, pavyzdžiui, susumuojant.
- pull(key, value) gauna agreguotą reikšmę iš bendros saugyklos, pavyzdžiui, sujungus visų darbininkų gradientus.
Paslėpę visą sinchronizavimo sudėtingumą už paprastos siuntimo ir gavimo operacijos, galime atskirti statistinių modeliuotojų, norinčių gebėti išreikšti optimizavimą paprastais terminais, ir sistemų inžinierių, kuriems tenka tvarkytis su paskirstytajam sinchronizavimui būdingu sudėtingumu, rūpesčius.
13.7.5 Santrauka
- Sinchronizavimas turi būti labai adaptyvus konkrečiai tinklo infrastruktūrai ir ryšiui serveryje. Tai gali sukelti didelį skirtumą sinchronizavimo laikui.
- Žiedinis sinchronizavimas gali būti optimalus p3 ir DGX-2 serveriams. Kitiems galbūt ne taip.
- Hierarchinė sinchronizavimo strategija gerai veikia pridedant kelis parametrų serverius didesniam pralaidumui.
13.7.6 Pratimai
- Ar galite dar labiau pagerinti žiedinį sinchronizavimą? Užuomina: žinutes galite siųsti abiem kryptimis.
- Ar įmanoma leisti asinchroninę komunikaciją (kol skaičiavimas dar vyksta)? Kaip tai veikia našumą?
- Kas, jei prarastume serverį ilgai trunkančio skaičiavimo metu? Kaip galime suprojektuoti atsparumo gedimams mechanizmą, kad išvengtume visiško skaičiavimo paleidimo iš naujo?