
13.3 Automatinis lygiagretinimas
Giliojo mokymosi karkasai (pvz., MXNet ir PyTorch) automatiškai sukonstruoja skaičiavimo grafus vidinėje dalyje. Naudodama skaičiavimo grafą, sistema žino visas priklausomybes ir gali pasirinktinai lygiagrečiai vykdyti kelias tarpusavyje nepriklausomas užduotis, kad pagerintų greitį. Pavyzdžiui, 13.2.2 pav. iš 13.2 skyrelis inicializuoja du kintamuosius nepriklausomai. Todėl sistema gali pasirinkti vykdyti juos lygiagrečiai.
Paprastai vienas operatorius naudos visus skaičiavimo išteklius visuose CPU arba viename GPU. Pavyzdžiui, operatorius dot naudos visus branduolius (ir gijas) visuose CPU, net jei viename kompiuteryje yra keli CPU procesoriai. Tas pats taikoma ir vienam GPU. Todėl lygiagretinimas nėra toks naudingas vieno įrenginio kompiuteriams. Su keliais įrenginiais reikalai tampa svarbesni. Nors lygiagretinimas paprastai aktualiausias tarp kelių GPU, pridėjus vietinį CPU našumas šiek tiek padidės. Pavyzdžiui, žr. (Hadjis ir kt., 2016), kur dėmesys sutelktas į kompiuterinės regos modelių apmokymą derinant GPU ir CPU. Su automatiškai lygiagretinančio karkaso patogumu tą patį tikslą galime pasiekti keliomis Python kodo eilutėmis. Plačiau kalbant, mūsų automatinio lygiagrečiojo skaičiavimo aptarimas sutelktas į lygiagretųjį skaičiavimą naudojant ir CPU, ir GPU, taip pat skaičiavimo ir komunikacijos lygiagretinimą.
Atkreipkite dėmesį, kad šio skyrelio eksperimentams vykdyti mums reikia bent dviejų GPU.
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
from d2l import torch as d2l
import torch
13.3.1 Lygiagretusis skaičiavimas GPU
Pradėkime apibrėždami etaloninę testuojamą apkrovą: toliau pateikta funkcija run atlieka 10 matricų daugybų pasirinktame įrenginyje naudodama duomenis, paskirstytus dviem kintamiesiems: x_gpu1 ir x_gpu2.
devices = d2l.try_all_gpus()
def run(x):
    return [x.dot(x) for _ in range(50)]

x_gpu1 = np.random.uniform(size=(4000, 4000), ctx=devices[0])
x_gpu2 = np.random.uniform(size=(4000, 4000), ctx=devices[1])
devices = d2l.try_all_gpus()
def run(x):
    return [x.mm(x) for _ in range(50)]

x_gpu1 = torch.rand(size=(4000, 4000), device=devices[0])
x_gpu2 = torch.rand(size=(4000, 4000), device=devices[1])
Dabar pritaikome funkciją duomenims. Kad užtikrintume, jog spartinančioji atmintinė neturi įtakos rezultatams, apšildome įrenginius prieš matuodami atlikdami vieną praėjimą kiekviename iš jų.
Dabar pritaikome funkciją duomenims. Kad užtikrintume, jog spartinančioji atmintinė neturi įtakos rezultatams, apšildome įrenginius prieš matuodami atlikdami vieną praėjimą kiekviename iš jų. torch.cuda.synchronize() laukia, kol baigsis visi branduoliai visuose srautuose CUDA įrenginyje. Ji priima argumentą device – įrenginį, kuriam reikia sinchronizuoti. Jei argumentas device yra None (numatytasis), naudojamas dabartinis įrenginys, nurodytas current_device().
run(x_gpu1)  # Warm-up both devices
run(x_gpu2)
npx.waitall()

with d2l.Benchmark('GPU1 time'):
    run(x_gpu1)
    npx.waitall()

with d2l.Benchmark('GPU2 time'):
    run(x_gpu2)
    npx.waitall()
run(x_gpu1)
run(x_gpu2)  # Warm-up all devices
torch.cuda.synchronize(devices[0])
torch.cuda.synchronize(devices[1])

with d2l.Benchmark('GPU1 time'):
    run(x_gpu1)
    torch.cuda.synchronize(devices[0])

with d2l.Benchmark('GPU2 time'):
    run(x_gpu2)
    torch.cuda.synchronize(devices[1])
Jei pašalinsime sakinį waitall tarp abiejų užduočių, sistema galės laisvai automatiškai lygiagretinti skaičiavimą abiejuose įrenginiuose.
Jei pašalinsime sakinį synchronize tarp abiejų užduočių, sistema galės laisvai automatiškai lygiagretinti skaičiavimą abiejuose įrenginiuose.
with d2l.Benchmark('GPU1 & GPU2'):
    run(x_gpu1)
    run(x_gpu2)
    npx.waitall()
with d2l.Benchmark('GPU1 & GPU2'):
    run(x_gpu1)
    run(x_gpu2)
    torch.cuda.synchronize()
Aukščiau aprašytu atveju bendras vykdymo laikas yra trumpesnis nei jo dalių suma, nes giliojo mokymosi karkasas automatiškai suplanuoja skaičiavimą abiejuose GPU įrenginiuose, naudotojui nereikalaujant sudėtingo kodo.
13.3.2 Lygiagretusis skaičiavimas ir komunikacija
Daugeliu atvejų mums reikia perkelti duomenis tarp skirtingų įrenginių, tarkime, tarp CPU ir GPU arba tarp skirtingų GPU. Pavyzdžiui, tai vyksta, kai norime atlikti paskirstytąjį optimizavimą, kur reikia agreguoti gradientus per kelias spartintuvų korteles. Imituokime tai skaičiuodami GPU, o tada nukopijuodami rezultatus atgal į CPU.
def copy_to_cpu(x):
    return [y.copyto(npx.cpu()) for y in x]

with d2l.Benchmark('Run on GPU1'):
    y = run(x_gpu1)
    npx.waitall()

with d2l.Benchmark('Copy to CPU'):
    y_cpu = copy_to_cpu(y)
    npx.waitall()
def copy_to_cpu(x, non_blocking=False):
    return [y.to('cpu', non_blocking=non_blocking) for y in x]

with d2l.Benchmark('Run on GPU1'):
    y = run(x_gpu1)
    torch.cuda.synchronize()

with d2l.Benchmark('Copy to CPU'):
    y_cpu = copy_to_cpu(y)
    torch.cuda.synchronize()
Tai kiek neefektyvu. Atkreipkite dėmesį, kad galėtume jau pradėti kopijuoti y dalis į CPU, kol likusi sąrašo dalis dar skaičiuojama. Ši situacija atsiranda, pavyzdžiui, kai skaičiuojame gradientą minirinkiniui. Kai kurių parametrų gradientai bus prieinami anksčiau nei kitų. Todėl mums naudinga pradėti naudoti PCI-Express magistralės pralaidumą, kol GPU dar veikia. Pašalinus waitall tarp abiejų dalių, galime imituoti šį scenarijų.
Tai kiek neefektyvu. Atkreipkite dėmesį, kad galėtume jau pradėti kopijuoti y dalis į CPU, kol likusi sąrašo dalis dar skaičiuojama. Ši situacija atsiranda, pavyzdžiui, kai skaičiuojame (atgalinio sklidimo) gradientą minirinkiniui. Kai kurių parametrų gradientai bus prieinami anksčiau nei kitų. Todėl mums naudinga pradėti naudoti PCI-Express magistralės pralaidumą, kol GPU dar veikia. PyTorch kelios funkcijos, pavyzdžiui, to() ir copy_(), priima aiškų argumentą non_blocking, kuris leidžia kvietėjui apeiti sinchronizavimą, kai jis nereikalingas. Nustatę non_blocking=True, galime imituoti šį scenarijų.
with d2l.Benchmark('Run on GPU1 and copy to CPU'):
    y = run(x_gpu1)
    y_cpu = copy_to_cpu(y)
    npx.waitall()
with d2l.Benchmark('Run on GPU1 and copy to CPU'):
    y = run(x_gpu1)
    y_cpu = copy_to_cpu(y, True)
    torch.cuda.synchronize()
Bendras abiem operacijoms reikalingas laikas (kaip ir tikėtasi) yra trumpesnis nei jų dalių suma.
Atkreipkite dėmesį, kad ši užduotis skiriasi nuo lygiagrečiojo skaičiavimo, nes naudoja kitą išteklių: magistralę tarp CPU ir GPU. Iš tikrųjų galėtume skaičiuoti abiejuose įrenginiuose ir komunikuoti vienu metu. Kaip minėta aukščiau, tarp skaičiavimo ir komunikacijos yra priklausomybė: y[i] turi būti apskaičiuotas prieš jį nukopijuojant į CPU. Laimei, sistema gali kopijuoti y[i-1] skaičiuodama y[i], kad sumažintų bendrą vykdymo laiką.
Baigiame skaičiavimo grafo ir jo priklausomybių iliustracija paprastam dviejų sluoksnių MLP apmokant CPU ir dviejuose GPU, kaip pavaizduota 13.3.1 pav.. Būtų gana varginga rankiniu būdu suplanuoti iš to kylančią lygiagrečiąją programą. Čia naudinga turėti grafu pagrįstą skaičiavimo vidinę dalį optimizavimui.
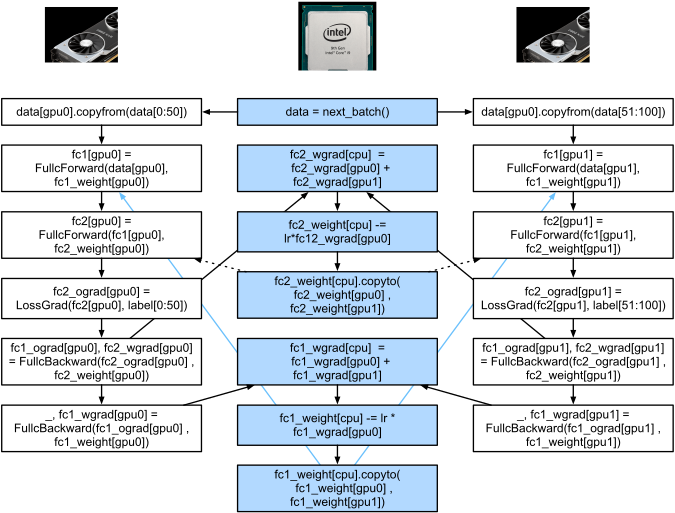
13.3.1 pav. Dviejų sluoksnių MLP skaičiavimo grafas ir jo priklausomybės CPU ir dviejuose GPU.
13.3.3 Santrauka
- Šiuolaikinės sistemos turi įvairių įrenginių, pavyzdžiui, kelis GPU ir CPU. Juos galima naudoti lygiagrečiai ir asinchroniškai.
- Šiuolaikinės sistemos taip pat turi įvairių komunikacijos išteklių, pavyzdžiui, PCI Express, saugyklą (paprastai kietojo kūno diskus arba per tinklus) ir tinklo pralaidumą. Juos galima naudoti lygiagrečiai didžiausiam efektyvumui pasiekti.
- Vidinė dalis gali pagerinti našumą per automatinį lygiagretųjį skaičiavimą ir komunikaciją.
13.3.4 Pratimai
- Šiame skyrelyje apibrėžtoje funkcijoje
runbuvo atliktos aštuonios operacijos. Tarp jų nėra priklausomybių. Suprojektuokite eksperimentą, kad pamatytumėte, ar giliojo mokymosi karkasas jas automatiškai vykdys lygiagrečiai. - Kai atskiro operatoriaus apkrova yra pakankamai maža, lygiagretinimas gali padėti net viename CPU ar GPU. Suprojektuokite eksperimentą tam patikrinti.
- Suprojektuokite eksperimentą, kuriame naudojamas lygiagretusis skaičiavimas CPU, GPU ir komunikacija tarp abiejų įrenginių.
- Naudokite derintuvą, pavyzdžiui, NVIDIA Nsight, kad patikrintumėte, ar jūsų kodas yra efektyvus.
- Suprojektuokite skaičiavimo užduotis, apimančias sudėtingesnes duomenų priklausomybes, ir vykdykite eksperimentus, kad pamatytumėte, ar galite gauti teisingus rezultatus gerindami našumą.