
22.4 Daugelio kintamųjų matematinė analizė
Dabar, kai gana gerai suprantame vieno kintamojo funkcijos išvestines, grįžkime prie pradinio klausimo, kuriame nagrinėjome nuostolių funkciją, priklausančią nuo galbūt milijardų parametrų.
22.4.1 Aukštesnių dimensijų diferencijavimas
22.3 skyrelis mums sako, kad jei pakeisime vieną iš šių milijardų parametrų, visų kitų nekeisdami, žinome, kas nutiks! Tai yra ne kas kita, kaip vieno kintamojo funkcija, todėl galime užrašyti
Išvestinę pagal vieną kintamąjį, kitus kintamuosius fiksuodami, vadinsime daline išvestine, o išvestinei (22.4.1) žymėti naudosime žymenį .
Dabar paimkime tai ir šiek tiek pakeiskime į :
Vėl pasinaudojome idėja, kad yra aukštesnės eilės narys, kurį galime atmesti taip pat, kaip atmetėme ankstesniame skyriuje, kartu su tuo, ką matėme (22.4.1). Tęsdami šitaip, galime užrašyti, kad
Tai gali atrodyti kaip netvarka, bet galime tai padaryti pažįstamesnį pastebėję, kad dešinėje esanti suma atrodo lygiai kaip skaliarinė sandauga, taigi jei pažymėsime
tada
Vektorių vadinsime gradientu.
Lygtį (22.4.2) verta akimirką apmąstyti. Ji turi būtent tokį formatą, su kokiu susidūrėme vienoje dimensijoje, tik viską pavertėme vektoriais ir skaliarinėmis sandaugomis. Ji leidžia apytiksliai pasakyti, kaip pasikeis funkcija esant bet kokiam įvesties trikdžiui. Kaip pamatysime kitame skyrelyje, tai suteiks svarbią priemonę geometriškai suprasti, kaip galime mokytis naudodami gradiente esančią informaciją.
Bet pirmiausia pažiūrėkime šią aproksimaciją veikiant su pavyzdžiu. Tarkime, dirbame su funkcija
Jei pažiūrėsime į tašką, pavyzdžiui, , matome, kad
Taigi, jei norime aproksimuoti taške , matome, kad turėtume turėti tokį konkretų (22.4.2) atvejį:
Tai galime patikrinti kode ir pamatyti, kiek gera aproksimacija.
%matplotlib inline
from d2l import mxnet as d2l
from IPython import display
from mpl_toolkits import mplot3d
from mxnet import autograd, np, npx
npx.set_np()

def f(x, y):
    return np.log(np.exp(x) + np.exp(y))
def grad_f(x, y):
    return np.array([np.exp(x) / (np.exp(x) + np.exp(y)),
                     np.exp(y) / (np.exp(x) + np.exp(y))])

epsilon = np.array([0.01, -0.03])
grad_approx = f(0, np.log(2)) + epsilon.dot(grad_f(0, np.log(2)))
true_value = f(0 + epsilon[0], np.log(2) + epsilon[1])
f'approximation: {grad_approx}, true Value: {true_value}'
%matplotlib inline
from d2l import torch as d2l
from IPython import display
from mpl_toolkits import mplot3d
import torch
import numpy as np

def f(x, y):
    return torch.log(torch.exp(x) + torch.exp(y))
def grad_f(x, y):
    return torch.tensor([torch.exp(x) / (torch.exp(x) + torch.exp(y)),
                     torch.exp(y) / (torch.exp(x) + torch.exp(y))])

epsilon = torch.tensor([0.01, -0.03])
grad_approx = f(torch.tensor([0.]), torch.log(
    torch.tensor([2.]))) + epsilon.dot(
    grad_f(torch.tensor([0.]), torch.log(torch.tensor(2.))))
true_value = f(torch.tensor([0.]) + epsilon[0], torch.log(
    torch.tensor([2.])) + epsilon[1])
f'approximation: {grad_approx}, true Value: {true_value}'
%matplotlib inline
from d2l import tensorflow as d2l
from IPython import display
from mpl_toolkits import mplot3d
import tensorflow as tf
import numpy as np

def f(x, y):
    return tf.math.log(tf.exp(x) + tf.exp(y))
def grad_f(x, y):
    return tf.constant([(tf.exp(x) / (tf.exp(x) + tf.exp(y))).numpy(),
                        (tf.exp(y) / (tf.exp(x) + tf.exp(y))).numpy()])

epsilon = tf.constant([0.01, -0.03])
grad_approx = f(tf.constant([0.]), tf.math.log(
    tf.constant([2.]))) + tf.tensordot(
    epsilon, grad_f(tf.constant([0.]), tf.math.log(tf.constant(2.))), axes=1)
true_value = f(tf.constant([0.]) + epsilon[0], tf.math.log(
    tf.constant([2.])) + epsilon[1])
f'approximation: {grad_approx}, true Value: {true_value}'
22.4.2 Gradientų geometrija ir gradientinis nusileidimas
Dar kartą panagrinėkime išraišką iš (22.4.2):
Tarkime, noriu tai panaudoti, kad padėčiau minimizuoti savo nuostolius . Pirmiausia geometriškai suprasime gradientinio nusileidimo algoritmą, pirmą kartą aprašytą 2.5 skyrelis. Darysime štai ką:
- Pradėti nuo atsitiktinai pasirinktų pradinių parametrų .
- Rasti kryptį , kuria taške mažėja greičiausiai.
- Žengti mažą žingsnį ta kryptimi: .
- Kartoti.
Vienintelis dalykas, kurį tiksliai nežinome, kaip padaryti, yra vektoriaus apskaičiavimas antrame žingsnyje. Tokią kryptį vadinsime stačiausio nusileidimo kryptimi. Naudodami geometrinį skaliarinių sandaugų supratimą iš 22.1 skyrelis, matome, kad (22.4.2) galime perrašyti kaip
Atkreipkite dėmesį, kad patogumo dėlei kryptį paėmėme vienetinio ilgio ir naudojome kampui tarp ir žymėti. Jei norime rasti kryptį, kuria mažėja kuo greičiau, norime, kad ši išraiška būtų kuo neigiamesnė. Vienintelis būdas, kuriuo mūsų pasirinkta kryptis patenka į šią lygtį, yra per , todėl norime, kad šis kosinusas būtų kuo neigiamesnis. Dabar, prisiminę kosinuso formą, galime tai padaryti kuo neigiamesnį padarę , arba, ekvivalenčiai, kad kampas tarp gradiento ir mūsų pasirinktos krypties būtų radianų, arba laipsnių. Vienintelis būdas tai pasiekti – judėti tiksliai priešinga kryptimi: pasirinkti , nukreiptą tiksliai priešinga kryptimi nei !
Tai mus atveda prie vienos svarbiausių mašininio mokymo matematinių sąvokų: stačiausio nusileidimo kryptis yra kryptis. Taigi mūsų neformalų algoritmą galima perrašyti taip.
- Pradėti nuo atsitiktinai pasirinktų pradinių parametrų .
- Apskaičiuoti .
- Žengti mažą žingsnį priešinga tai krypčiai: .
- Kartoti.
Šį pagrindinį algoritmą daugelis tyrėjų įvairiais būdais modifikavo ir pritaikė, tačiau visų jų pagrindinė idėja išlieka ta pati. Naudoti gradientą, kad rastume kryptį, kuria nuostoliai mažėja kuo greičiau, ir atnaujinti parametrus žengiant žingsnį ta kryptimi.
22.4.3 Pastaba apie matematinį optimizavimą
Visoje šioje knygoje daugiausia dėmesio skiriame skaitiniams optimizavimo metodams dėl praktinės priežasties: visos giliojo mokymosi aplinkoje sutinkamos funkcijos yra per sudėtingos, kad jas būtų galima minimizuoti aiškiai.
Vis dėlto naudinga pagalvoti, ką aukščiau gautas geometrinis supratimas mums sako apie funkcijų optimizavimą tiesiogiai.
Tarkime, norime rasti reikšmę , kuri minimizuoja kokią nors funkciją . Tarkime, be to, kad kažkas mums pateikia reikšmę ir sako, kad tai reikšmė, minimizuojanti . Ar galime ką nors patikrinti, kad pamatytume, ar jų atsakymas bent jau įtikėtinas?
Vėl panagrinėkime (22.4.2):
Jei gradientas nėra nulinis, žinome, kad galime žengti žingsnį kryptimi ir rasti mažesnę reikšmę. Taigi, jei tikrai esame minimume, to būti negali! Galime daryti išvadą, kad jei yra minimumas, tai . Taškus, kuriuose , vadiname kritiniais taškais.
Tai gražu, nes kai kuriais retais atvejais galime aiškiai rasti visus taškus, kuriuose gradientas lygus nuliui, ir išsirinkti tą, kurio reikšmė mažiausia.
Konkrečiam pavyzdžiui panagrinėkime funkciją
Ši funkcija turi išvestinę
Vienintelės galimos minimumų vietos yra , kuriose funkcija įgyja atitinkamai reikšmes , todėl galime daryti išvadą, kad funkciją minimizuojame, kai . Tai patvirtina greitas grafikas.
x = np.arange(-2, 3, 0.01)
f = (3 * x**4) - (4 * x**3) - (12 * x**2)

d2l.plot(x, f, 'x', 'f(x)')
x = torch.arange(-2, 3, 0.01)
f = (3 * x**4) - (4 * x**3) - (12 * x**2)

d2l.plot(x, f, 'x', 'f(x)')
x = tf.range(-2, 3, 0.01)
f = (3 * x**4) - (4 * x**3) - (12 * x**2)

d2l.plot(x, f, 'x', 'f(x)')
Tai pabrėžia svarbų faktą, kurį verta žinoti dirbant tiek teoriškai, tiek skaitiškai: vieninteliai galimi taškai, kuriuose galime minimizuoti (ar maksimizuoti) funkciją, turės nulinį gradientą, tačiau ne kiekvienas taškas su nuliniu gradientu yra tikrasis globalusis minimumas (ar maksimumas).
22.4.4 Daugelio kintamųjų grandinės taisyklė
Tarkime, turime keturių kintamųjų ( ir ) funkciją, kurią galime gauti sukomponavę daug narių:
Tokios lygčių grandinės yra įprastos dirbant su neuroniniais tinklais, todėl esminis dalykas yra suprasti, kaip apskaičiuoti tokių funkcijų gradientus. Vizualių užuominų apie šį ryšį galime pradėti matyti 22.4.1 pav., jei pažiūrėsime, kurie kintamieji tiesiogiai susiję vienas su kitu.

22.4.1 pav. Aukščiau pateikti funkciniai ryšiai, kur mazgai žymi reikšmes, o briaunos rodo funkcinę priklausomybę.
Niekas netrukdo tiesiog sukomponuoti viską iš (22.4.3) ir užrašyti, kad
Tada išvestinę galėtume paimti tiesiog naudodami vieno kintamojo išvestines, bet tai daryti greitai atsidurtume paskendę narių, iš kurių daugelis kartojasi! Iš tiesų galima pamatyti, kad, pavyzdžiui:
Jei po to taip pat norėtume apskaičiuoti , vėl gautume panašią lygtį su daug pasikartojančių narių ir daug bendrų pasikartojančių narių tarp šių dviejų išvestinių. Tai reiškia didžiulį švaistomo darbo kiekį, ir jei išvestines reikėtų skaičiuoti šitaip, visa giliojo mokymosi revoliucija būtų sustojusi dar neprasidėjusi!
Išskaidykime uždavinį. Pradėsime bandydami suprasti, kaip pasikeičia, kai keičiame , iš esmės darydami prielaidą, kad ir visai neegzistuoja. Samprotausime taip pat, kaip tada, kai pirmą kartą dirbome su gradientu. Paimkime ir pridėkime prie jo mažą dydį .
Pirma eilutė išplaukia iš dalinės išvestinės apibrėžimo, o antra – iš gradiento apibrėžimo. Žymėjimo požiūriu sunku sekti, kur tiksliai įvertiname kiekvieną išvestinę, kaip išraiškoje , todėl dažnai tai sutrumpiname iki daug lengviau įsimenamos
Naudinga pagalvoti apie proceso prasmę. Bandome suprasti, kaip formos funkcija keičia savo reikšmę keičiantis . Tai gali vykti dviem keliais: yra kelias ir kelias . Abu šiuos indėlius galime apskaičiuoti pagal grandinės taisyklę: atitinkamai ir , ir sudėti.
Įsivaizduokite, kad turime kitą funkcijų tinklą, kuriame dešinėje esančios funkcijos priklauso nuo kairėje esančių, su kuriomis jos sujungtos, kaip parodyta 22.4.2 pav..
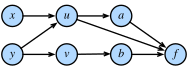
22.4.2 pav. Dar vienas subtilesnis grandinės taisyklės pavyzdys.
Norėdami apskaičiuoti ką nors panašaus į , turime susumuoti per visus (šiuo atveju ) kelius nuo iki , gaudami
Šitaip suprasta grandinės taisyklė atneš didelę naudą bandant suprasti, kaip gradientai teka per tinklus ir kodėl įvairūs architektūros sprendimai, tokie kaip LSTM (10.1 skyrelis) ar liekanų sluoksniai (8.6 skyrelis), gali padėti formuoti mokymosi procesą valdydami gradientų tekėjimą.
22.4.5 Atgalinio sklidimo algoritmas
Grįžkime prie ankstesnio skyrelio pavyzdžio (22.4.3), kuriame
Jei norime apskaičiuoti, tarkime, , galime pritaikyti daugelio kintamųjų grandinės taisyklę ir gauti:
Pabandykime naudoti šią skaidą apskaičiuoti. Atkreipkite dėmesį, kad čia mums reikia tik įvairių vieno žingsnio dalinių išvestinių:
Jei tai užrašysime kodu, ši išraiška tampa gana valdoma.
# Compute the value of the function from inputs to outputs
w, x, y, z = -1, 0, -2, 1
a, b = (w + x + y + z)**2, (w + x - y - z)**2
u, v = (a + b)**2, (a - b)**2
f = (u + v)**2
print(f'    f at {w}, {x}, {y}, {z} is {f}')

# Compute the single step partials
df_du, df_dv = 2*(u + v), 2*(u + v)
du_da, du_db, dv_da, dv_db = 2*(a + b), 2*(a + b), 2*(a - b), -2*(a - b)
da_dw, db_dw = 2*(w + x + y + z), 2*(w + x - y - z)

# Compute the final result from inputs to outputs
du_dw, dv_dw = du_da*da_dw + du_db*db_dw, dv_da*da_dw + dv_db*db_dw
df_dw = df_du*du_dw + df_dv*dv_dw
print(f'df/dw at {w}, {x}, {y}, {z} is {df_dw}')
Tačiau atkreipkite dėmesį, kad tai vis tiek nepadaro lengvu apskaičiuoti ko nors panašaus į . To priežastis yra būdas, kuriuo pasirinkome taikyti grandinės taisyklę. Jei pažiūrėsime, ką darėme aukščiau, kai tik galėjome, visada palikdavome vardiklyje. Šitaip pasirinkome taikyti grandinės taisyklę žiūrėdami, kaip keičia kiekvieną kitą kintamąjį. Jei to ir norėtume, tai būtų gera idėja. Tačiau prisiminkite savo motyvaciją iš giliojo mokymosi: norime pamatyti, kaip kiekvienas parametras keičia nuostolius. Iš esmės norime taikyti grandinės taisyklę, kai tik galime, palikdami skaitiklyje!
Aiškiau tariant, atkreipkite dėmesį, kad galime užrašyti
Atkreipkite dėmesį, kad taikant grandinės taisyklę šitaip, aiškiai apskaičiuojame . Niekas netrukdo įtraukti ir lygčių:
ir tada sekti, kaip keičiasi, keičiant bet kurį viso tinklo mazgą. Realizuokime tai.
# Compute the value of the function from inputs to outputs
w, x, y, z = -1, 0, -2, 1
a, b = (w + x + y + z)**2, (w + x - y - z)**2
u, v = (a + b)**2, (a - b)**2
f = (u + v)**2
print(f'f at {w}, {x}, {y}, {z} is {f}')

# Compute the derivative using the decomposition above
# First compute the single step partials
df_du, df_dv = 2*(u + v), 2*(u + v)
du_da, du_db, dv_da, dv_db = 2*(a + b), 2*(a + b), 2*(a - b), -2*(a - b)
da_dw, db_dw = 2*(w + x + y + z), 2*(w + x - y - z)
da_dx, db_dx = 2*(w + x + y + z), 2*(w + x - y - z)
da_dy, db_dy = 2*(w + x + y + z), -2*(w + x - y - z)
da_dz, db_dz = 2*(w + x + y + z), -2*(w + x - y - z)

# Now compute how f changes when we change any value from output to input
df_da, df_db = df_du*du_da + df_dv*dv_da, df_du*du_db + df_dv*dv_db
df_dw, df_dx = df_da*da_dw + df_db*db_dw, df_da*da_dx + df_db*db_dx
df_dy, df_dz = df_da*da_dy + df_db*db_dy, df_da*da_dz + df_db*db_dz

print(f'df/dw at {w}, {x}, {y}, {z} is {df_dw}')
print(f'df/dx at {w}, {x}, {y}, {z} is {df_dx}')
print(f'df/dy at {w}, {x}, {y}, {z} is {df_dy}')
print(f'df/dz at {w}, {x}, {y}, {z} is {df_dz}')
Tai, kad išvestines skaičiuojame nuo atgal link įvesčių, o ne nuo įvesčių pirmyn link išvesčių (kaip darėme pirmajame aukščiau pateiktame kodo fragmente), ir suteikia šiam algoritmui pavadinimą: atgalinis sklidimas. Atkreipkite dėmesį, kad yra du žingsniai:
- Apskaičiuoti funkcijos reikšmę ir vieno žingsnio daliniais išvestines iš priekio į galą. Nors aukščiau to nedarėme, tai galima sujungti į vieną tiesioginį perėjimą (angl. forward pass).
- Apskaičiuoti gradientą iš galo į priekį. Tai vadiname atgaliniu perėjimu (angl. backwards pass).
Būtent tai įgyvendina kiekvienas giliojo mokymosi algoritmas, kad vienu perėjimu būtų galima apskaičiuoti nuostolių gradientą pagal kiekvieną tinklo parametrą. Stulbinantis faktas, kad turime tokią skaidą.
Kad pamatytume, kaip tai įkapsuliuoti, greitai pažvelkime į šį pavyzdį.
# Initialize as ndarrays, then attach gradients
w, x, y, z = np.array(-1), np.array(0), np.array(-2), np.array(1)

w.attach_grad()
x.attach_grad()
y.attach_grad()
z.attach_grad()

# Do the computation like usual, tracking gradients
with autograd.record():
    a, b = (w + x + y + z)**2, (w + x - y - z)**2
    u, v = (a + b)**2, (a - b)**2
    f = (u + v)**2

# Execute backward pass
f.backward()

print(f'df/dw at {w}, {x}, {y}, {z} is {w.grad}')
print(f'df/dx at {w}, {x}, {y}, {z} is {x.grad}')
print(f'df/dy at {w}, {x}, {y}, {z} is {y.grad}')
print(f'df/dz at {w}, {x}, {y}, {z} is {z.grad}')
# Initialize as ndarrays, then attach gradients
w = torch.tensor([-1.], requires_grad=True)
x = torch.tensor([0.], requires_grad=True)
y = torch.tensor([-2.], requires_grad=True)
z = torch.tensor([1.], requires_grad=True)
# Do the computation like usual, tracking gradients
a, b = (w + x + y + z)**2, (w + x - y - z)**2
u, v = (a + b)**2, (a - b)**2
f = (u + v)**2

# Execute backward pass
f.backward()

print(f'df/dw at {w.data.item()}, {x.data.item()}, {y.data.item()}, '
      f'{z.data.item()} is {w.grad.data.item()}')
print(f'df/dx at {w.data.item()}, {x.data.item()}, {y.data.item()}, '
      f'{z.data.item()} is {x.grad.data.item()}')
print(f'df/dy at {w.data.item()}, {x.data.item()}, {y.data.item()}, '
      f'{z.data.item()} is {y.grad.data.item()}')
print(f'df/dz at {w.data.item()}, {x.data.item()}, {y.data.item()}, '
      f'{z.data.item()} is {z.grad.data.item()}')
# Initialize as ndarrays, then attach gradients
w = tf.Variable(tf.constant([-1.]))
x = tf.Variable(tf.constant([0.]))
y = tf.Variable(tf.constant([-2.]))
z = tf.Variable(tf.constant([1.]))
# Do the computation like usual, tracking gradients
with tf.GradientTape(persistent=True) as t:
    a, b = (w + x + y + z)**2, (w + x - y - z)**2
    u, v = (a + b)**2, (a - b)**2
    f = (u + v)**2

# Execute backward pass
w_grad = t.gradient(f, w).numpy()
x_grad = t.gradient(f, x).numpy()
y_grad = t.gradient(f, y).numpy()
z_grad = t.gradient(f, z).numpy()

print(f'df/dw at {w.numpy()}, {x.numpy()}, {y.numpy()}, '
      f'{z.numpy()} is {w_grad}')
print(f'df/dx at {w.numpy()}, {x.numpy()}, {y.numpy()}, '
      f'{z.numpy()} is {x_grad}')
print(f'df/dy at {w.numpy()}, {x.numpy()}, {y.numpy()}, '
      f'{z.numpy()} is {y_grad}')
print(f'df/dz at {w.numpy()}, {x.numpy()}, {y.numpy()}, '
      f'{z.numpy()} is {z_grad}')
Viską, ką darėme aukščiau, galima atlikti automatiškai iškvietus f.backwards().
22.4.6 Heso matricos
Kaip ir vieno kintamojo matematinėje analizėje, naudinga nagrinėti aukštesnės eilės išvestines, kad suprastume, kaip galime gauti geresnę funkcijos aproksimaciją nei vien naudojant gradientą.
Dirbant su kelių kintamųjų funkcijų aukštesnės eilės išvestinėmis iškart susiduriama su viena problema: jų yra labai daug. Jei turime kintamųjų funkciją , galime imti antrųjų išvestinių, būtent bet kuriam ir pasirinkimui:
Tradiciškai jos surenkamos į matricą, vadinamą Heso matrica:
Ne kiekvienas šios matricos elementas yra nepriklausomas. Iš tiesų galime parodyti, kad kol egzistuoja ir yra tolydžios abi mišriosios išvestinės (dalinės išvestinės pagal daugiau nei vieną kintamąjį), galime sakyti, kad bet kuriems ir
Tai išplaukia iš to, kad pirmiausia sutrikdome funkciją kryptimi, o tada kryptimi, ir palyginame rezultatą su tuo, kas nutinka, kai pirmiausia sutrikdome , o tada , žinodami, kad abi šios tvarkos lemia tą patį galutinį išvesties pokytį.
Kaip ir su vienu kintamuoju, šias išvestines galime naudoti, kad gautume gerokai geresnį supratimą apie tai, kaip funkcija elgiasi šalia taško. Visų pirma galime jas naudoti geriausiai tinkančiai kvadratinei funkcijai šalia taško rasti, kaip matėme vieno kintamojo atveju.
Pažiūrėkime pavyzdį. Tarkime, . Tai bendroji dviejų kintamųjų kvadratinės funkcijos forma. Jei pažiūrėsime į funkcijos reikšmę, jos gradientą ir Heso matricą (22.4.4), visus taške nulis:
galime atgauti savo pradinį daugianarį pasakę, kad
Bendru atveju, jei šį skleidinį apskaičiuotume bet kuriame taške , matome, kad
Tai veikia bet kokios dimensijos įvesčiai ir suteikia geriausią aproksimuojančią kvadratinę funkciją bet kuriai funkcijai taške. Kad pateiktume pavyzdį, nubraižykime funkciją
Galima apskaičiuoti, kad gradientas ir Heso matrica yra
Taigi, pritaikę šiek tiek algebros, matome, kad aproksimuojanti kvadratinė funkcija taške yra
# Construct grid and compute function
x, y = np.meshgrid(np.linspace(-2, 2, 101),
                   np.linspace(-2, 2, 101), indexing='ij')
z = x*np.exp(- x**2 - y**2)

# Compute approximating quadratic with gradient and Hessian at (1, 0)
w = np.exp(-1)*(-1 - (x + 1) + (x + 1)**2 + y**2)

# Plot function
ax = d2l.plt.figure().add_subplot(111, projection='3d')
ax.plot_wireframe(x.asnumpy(), y.asnumpy(), z.asnumpy(),
                  **{'rstride': 10, 'cstride': 10})
ax.plot_wireframe(x.asnumpy(), y.asnumpy(), w.asnumpy(),
                  **{'rstride': 10, 'cstride': 10}, color='purple')
d2l.plt.xlabel('x')
d2l.plt.ylabel('y')
d2l.set_figsize()
ax.set_xlim(-2, 2)
ax.set_ylim(-2, 2)
ax.set_zlim(-1, 1)
ax.dist = 12
# Construct grid and compute function
x, y = torch.meshgrid(torch.linspace(-2, 2, 101),
                   torch.linspace(-2, 2, 101))

z = x*torch.exp(- x**2 - y**2)

# Compute approximating quadratic with gradient and Hessian at (1, 0)
w = torch.exp(torch.tensor([-1.]))*(-1 - (x + 1) + 2 * (x + 1)**2 + 2 * y**2)

# Plot function
ax = d2l.plt.figure().add_subplot(111, projection='3d')
ax.plot_wireframe(x.numpy(), y.numpy(), z.numpy(),
                  **{'rstride': 10, 'cstride': 10})
ax.plot_wireframe(x.numpy(), y.numpy(), w.numpy(),
                  **{'rstride': 10, 'cstride': 10}, color='purple')
d2l.plt.xlabel('x')
d2l.plt.ylabel('y')
d2l.set_figsize()
ax.set_xlim(-2, 2)
ax.set_ylim(-2, 2)
ax.set_zlim(-1, 1)
ax.dist = 12
# Construct grid and compute function
x, y = tf.meshgrid(tf.linspace(-2., 2., 101),
                   tf.linspace(-2., 2., 101))

z = x*tf.exp(- x**2 - y**2)

# Compute approximating quadratic with gradient and Hessian at (1, 0)
w = tf.exp(tf.constant([-1.]))*(-1 - (x + 1) + 2 * (x + 1)**2 + 2 * y**2)

# Plot function
ax = d2l.plt.figure().add_subplot(111, projection='3d')
ax.plot_wireframe(x.numpy(), y.numpy(), z.numpy(),
                  **{'rstride': 10, 'cstride': 10})
ax.plot_wireframe(x.numpy(), y.numpy(), w.numpy(),
                  **{'rstride': 10, 'cstride': 10}, color='purple')
d2l.plt.xlabel('x')
d2l.plt.ylabel('y')
d2l.set_figsize()
ax.set_xlim(-2, 2)
ax.set_ylim(-2, 2)
ax.set_zlim(-1, 1)
ax.dist = 12
Tai sudaro pagrindą Niutono algoritmui, aptartam 12.3 skyrelis, kur atliekame skaitinį optimizavimą iteratyviai randame geriausiai tinkančią kvadratinę funkciją, o tada tiksliai minimizuojame tą kvadratinę funkciją.
22.4.7 Šiek tiek matricų matematinės analizės
Funkcijų, apimančių matricas, išvestinės pasirodo esančios ypač gražios. Šis skyrelis gali tapti žymėjimo požiūriu sunkus, todėl pirmą kartą skaitant gali būti praleistas, tačiau naudinga žinoti, kad funkcijų, apimančių įprastas matricų operacijas, išvestinės dažnai yra gerokai tvarkingesnės, nei galima iš pradžių tikėtis, ypač turint omenyje, kokios svarbios matricų operacijos yra giliojo mokymosi taikymuose.
Pradėkime nuo pavyzdžio. Tarkime, turime kokį nors fiksuotą stulpelio vektorių ir norime paimti sandaugos funkciją ir suprasti, kaip pasikeičia skaliarinė sandauga, kai keičiame .
Šiek tiek žymėjimo, kuris bus naudingas dirbant su matricų išvestinėmis MM srityje, vadinama vardiklio išdėstymo matricos išvestine (angl. denominator layout), kai savo dalines išvestines surenkame į tokios formos vektorių, matricą ar tenzorių, koks yra diferencialo vardiklyje. Šiuo atveju rašysime
kur atitikome stulpelio vektoriaus formą.
Jei savo funkciją išskleisime komponentėmis, tai yra
Jei dabar imsime dalinę išvestinę pagal, tarkime, , atkreipkite dėmesį, kad viskas lygu nuliui, išskyrus pirmąjį narį, kuris yra tiesiog , padaugintas iš , taigi gauname, kad
arba bendriau, kad
Dabar tai galime vėl surinkti į matricą ir pamatyti
Tai iliustruoja keletą dalykų apie matricų matematinę analizę, su kuriais dažnai susidursime visame šiame skyrelyje:
- Pirma, skaičiavimai taps gana sudėtingi.
- Antra, galutiniai rezultatai yra daug tvarkingesni nei tarpinis procesas ir visada atrodys panašiai kaip vieno kintamojo atveju. Šiuo atveju atkreipkite dėmesį, kad ir yra panašūs.
- Trečia, transponavimai dažnai gali atsirasti tarsi iš niekur. Pagrindinė to priežastis yra susitarimas, kad atitinkame vardiklio formą, todėl dauginant matricas, reikės transponuoti, kad grįžtume prie pradinio nario formos.
Kad toliau kurtume intuiciją, pabandykime šiek tiek sudėtingesnį skaičiavimą. Tarkime, turime stulpelio vektorių ir kvadratinę matricą ir norime apskaičiuoti
Kad judėtume link lengviau manipuliuojamo žymėjimo, panagrinėkime šį uždavinį naudodami Einšteino žymėjimą. Šiuo atveju funkciją galime užrašyti kaip
Kad apskaičiuotume išvestinę, turime suprasti, kam kiekvienam lygi
Pagal sandaugos taisyklę tai yra
Nariui, pavyzdžiui, , nesunku pamatyti, kad jis lygus vienam, kai , ir nuliui kitais atvejais. Tai reiškia, kad kiekvienas narys, kuriame ir skiriasi, šioje sumoje išnyksta, todėl toje pirmoje sumoje lieka tik nariai, kur . Tas pats samprotavimas galioja antram nariui, kuriame reikia . Tai duoda
Dabar indeksų pavadinimai Einšteino žymėjime yra savavališki – tai, kad ir skiriasi, šiuo metu šiam skaičiavimui nesvarbu, todėl galime iš naujo sužymėti indeksus, kad abu naudotų , ir pamatyti, kad
Dabar čia pradeda reikėti šiek tiek praktikos, kad pasistūmėtume toliau. Pabandykime atpažinti šį rezultatą matricų operacijų terminais. yra -oji matricos komponentė. Tai duoda
Panašiai šis narys dabar yra matricos ir vektoriaus sandauga, taigi matome, kad
Taigi matome, kad -asis ieškomos išvestinės iš (22.4.5) elementas yra tiesiog -asis dešinėje esančio vektoriaus elementas, todėl abu yra tie patys. Taigi gauname
Tam prireikė gerokai daugiau darbo nei ankstesniam, bet galutinis rezultatas trumpas. Be to, panagrinėkime tokį tradicinių vieno kintamojo išvestinių skaičiavimą:
Ekvivalenčiai . Vėl gauname rezultatą, kuris gana panašus į vieno kintamojo rezultatą, tik su įmesta transponavimo operacija.
Šiuo metu dėsningumas turėtų atrodyti gana įtartinai, todėl pabandykime išsiaiškinti kodėl. Kai imame tokias matricų išvestines, pirmiausia darykime prielaidą, kad gauta išraiška bus kita matricų išraiška: išraiška, kurią galime užrašyti per matricų ir jų transponuotųjų sandaugas bei sumas. Jei tokia išraiška egzistuoja, ji turės būti teisinga visoms matricoms. Visų pirma ji turės būti teisinga matricoms, kuriuo atveju matricų sandauga yra tiesiog skaičių sandauga, matricų suma yra tiesiog suma, o transponavimas visai nieko nedaro! Kitaip tariant, kad ir kokią išraišką gautume, ji privalo atitikti vieno kintamojo išraišką. Tai reiškia, kad šiek tiek pasipraktikavus matricų išvestines dažnai galima atspėti tiesiog žinant, kaip turi atrodyti atitinkama vieno kintamojo išraiška!
Išbandykime tai. Tarkime, yra matrica, yra , o yra . Pabandykime apskaičiuoti
Šis skaičiavimas svarbus srityje, vadinamoje matricų faktorizacija. Tačiau mums tai tiesiog išvestinė, kurią reikia apskaičiuoti. Pabandykime įsivaizduoti, kokia ji būtų matricoms. Tuo atveju gauname išraišką
kur išvestinė yra gana standartinė. Jei bandysime tai paversti atgal į matricų išraišką, gausime
Tačiau jei pažiūrėsime, tai visai neveikia. Prisiminkite, kad yra , kaip ir , todėl matrica yra . Kita vertus, yra , o negalime padauginti ir matricų, nes dimensijos nesutampa!
Norime gauti , kuri yra tokios pat formos kaip , t. y. . Taigi kažkaip turime paimti matricą ir matricą, jas sudauginti (galbūt su transponavimais) ir gauti . Tai galime padaryti dauginant iš . Taigi galime atspėti, kad (22.4.6) sprendinys yra
Kad parodytume, jog tai veikia, nepateikti išsamaus skaičiavimo būtų neatsargu. Jei jau tikime, kad ši praktinė taisyklė veikia, galite praleisti šį išvedimą. Kad apskaičiuotume
turime rasti kiekvienam ir
Prisiminę, kad visi ir elementai yra konstantos atžvilgiu, galime išvestinę perkelti į sumos vidų ir pritaikyti grandinės taisyklę kvadratui, gaudami
Kaip ir ankstesniame išvedime, galime pastebėti, kad yra nenulinė tik jei ir . Jei kuri nors iš tų sąlygų negalioja, narys sumoje lygus nuliui ir jį galime laisvai atmesti. Matome, kad
Svarbi subtilybė čia ta, kad reikalavimas nepasireiškia vidinėje sumoje, nes tas yra fiktyvusis kintamasis, pagal kurį sumuojame vidiniame naryje. Žymėjimo požiūriu tvarkingesnis pavyzdys: panagrinėkite, kodėl
Nuo šio taško galime pradėti atpažinti sumos komponentes. Pirma,
Taigi visa išraiška sumos viduje yra
Tai reiškia, kad savo išvestinę dabar galime užrašyti kaip
Norime, kad tai atrodytų kaip matricos elementas, kad galėtume naudoti tą patį metodą kaip ankstesniame pavyzdyje ir gauti matricų išraišką, o tai reiškia, kad turime sukeisti indeksų tvarką. Jei pastebėsime, kad , tada galime užrašyti
Tai yra matricų sandauga, todėl galime daryti išvadą, kad
taigi (22.4.6) sprendinį galime užrašyti
Tai atitinka sprendinį, kurį atspėjome aukščiau!
Šiuo metu pagrįsta klausti: „Kodėl negaliu tiesiog užrašyti visų išmoktų matematinės analizės taisyklių matricinių versijų? Aišku, kad tai vis tiek mechaniška. Kodėl tiesiog to neatlikus!“ Iš tiesų tokių taisyklių yra, o (Petersen ir Pedersen, 2008) pateikia puikią santrauką. Tačiau dėl begalės būdų, kuriais galima derinti matricų operacijas, palyginti su pavieniais skaičiais, matricų išvestinių taisyklių yra gerokai daugiau nei vieno kintamojo. Dažnai geriausia dirbti su indeksais arba, kai tinka, palikti automatiniam diferencijavimui.
22.4.8 Santrauka
- Aukštesnėse dimensijose galime apibrėžti gradientus, kurie atlieka tą patį vaidmenį kaip išvestinės vienoje dimensijoje. Jie leidžia pamatyti, kaip daugelio kintamųjų funkcija keičiasi, kai savavališkai mažai pakeičiame įvestis.
- Atgalinio sklidimo algoritmą galima laikyti daugelio kintamųjų grandinės taisyklės organizavimo metodu, leidžiančiu efektyviai apskaičiuoti daug dalinių išvestinių.
- Matricų matematinė analizė leidžia glaustai užrašyti matricinių išraiškų išvestines.
22.4.9 Pratimai
- Turėdami stulpelio vektorių , apskaičiuokite ir , ir išvestines. Kodėl gaunate tą patį atsakymą?
- Tegu yra dimensijų vektorius. Kam lygu ?
- Tegu . Apskaičiuokite gradientą. Kokia yra gradiento komponenčių suma?
- Tegu . Parodykite, kad vienintelis kritinis taškas yra . Nagrinėdami , nustatykite, ar yra maksimumas, minimumas, ar nei vienas, nei kitas.
- Tarkime, minimizuojame funkciją . Kaip geometriškai galime interpretuoti sąlygą per ir ?