
22.11 Informacijos teorija
Visata perpildyta informacijos. Informacija suteikia bendrą kalbą per disciplinų plyšius: nuo Šekspyro sonetų iki mokslininkų straipsnių Kornelio arXiv, nuo Van Gogo paveikslo „Žvaigždėta naktis“ iki Bethoveno Simfonijos Nr. 5, nuo pirmosios programavimo kalbos Plankalkül iki pažangiausių mašininio mokymo algoritmų. Viskas, nepaisant formato, turi paklusti informacijos teorijos taisyklėms. Pasitelkę informacijos teoriją, galime išmatuoti ir palyginti, kiek informacijos yra skirtinguose signaluose. Šiame skyriuje išnagrinėsime pagrindines informacijos teorijos sąvokas ir jos taikymą mašininiame mokyme.
Prieš pradėdami apžvelkime ryšį tarp mašininio mokymo ir informacijos teorijos. Mašininis mokymas siekia iš duomenų išgauti įdomius signalus ir daryti svarbias prognozes. Informacijos teorija savo ruožtu nagrinėja informacijos kodavimą, dekodavimą, perdavimą ir manipuliavimą ja. Todėl informacijos teorija suteikia pagrindinę kalbą informacijos apdorojimui mašinomis išmoktose sistemose aptarti. Pavyzdžiui, daugelis mašininio mokymo taikymų naudoja kryžminės entropijos nuostolius, aprašytus 4.1 skyrelis. Šiuos nuostolius galima tiesiogiai išvesti iš informacijos teorijos svarstymų.
22.11.1 Informacija
Pradėkime nuo informacijos teorijos „sielos“ – informacijos. Informaciją galima užkoduoti bet kuo, turinčiu tam tikrą vieno ar kelių kodavimo formatų seką. Tarkime, kad užsibrėžiame apibrėžti informacijos sąvoką. Kas galėtų būti mūsų atspirties taškas?
Panagrinėkime tokį minties eksperimentą. Turime draugą su kortų kaladę. Jis ją sumaišys, apvers kelias korteles ir pasakys mums teiginius apie jas. Pabandysime įvertinti kiekvieno teiginio informacijos kiekį.
Pirmiausia jis apverčia kortelę ir sako: „Matau kortą.“ Tai nesuteikia mums jokios informacijos. Jau buvome tuo tikri, todėl tikimės, kad informacija turėtų būti nulinė.
Toliau jis apverčia kortelę ir sako: „Matau širdį.“ Tai suteikia šiek tiek informacijos, bet iš tikrųjų buvo galimos tik skirtingos rūšys, kiekviena vienodai tikėtina, todėl šis rezultatas mūsų nenustebina. Tikimės, kad kad ir koks būtų informacijos matas, šis įvykis turėtų turėti mažą informacijos kiekį.
Toliau jis apverčia kortelę ir sako: „Tai pikų .“ Tai daugiau informacijos. Iš tiesų buvo vienodai tikėtini galimi rezultatai, ir draugas mums pasakė, kuris iš jų. Tai turėtų būti vidutinis informacijos kiekis.
Pasiekime loginį kraštutinumą. Tarkime, kad galiausiai jis apverčia kiekvieną kaladės kortelę ir nuskaito visą sumaišytos kaladės seką. Kaladė gali būti išdėstyta skirtingų tvarkų, vėlgi visos vienodai tikėtinos, todėl mums reikia daug informacijos, kad žinotume, kuri iš jų.
Bet kuri mūsų kuriama informacijos sąvoka turi atitikti šią intuiciją. Iš tiesų kituose skyreliuose išmoksime apskaičiuoti, kad šie įvykiai turi atitinkamai , , ir informacijos.
Perskaitę šiuos minties eksperimentus, matome natūralią idėją. Kaip atspirties tašką, užuot rūpinęsi žiniomis, galime remtis idėja, kad informacija atspindi nuostabos laipsnį arba abstraktų įvykio galimybę. Pavyzdžiui, jei norime apibūdinti neįprastą įvykį, mums reikia daug informacijos. Įprastam įvykiui informacijos gali prireikti nedaug.
1948 m. Claude'as E. Shannonas paskelbė A Mathematical Theory of Communication (Shannon, ), įtvirtinusį informacijos teoriją. Savo straipsnyje Shannonas pirmą kartą pristatė informacijos entropijos sąvoką. Nuo čia ir pradėsime savo kelionę.
22.11.1.1 Savaiminė informacija
Kadangi informacija įkūnija abstrakčią įvykio galimybę, kaip atvaizduoti galimybę į bitų skaičių? Shannonas pristatė terminą bitas kaip informacijos vienetą, kurį iš pradžių sukūrė Johnas Tukey. Taigi kas yra „bitas“ ir kodėl juo matuojame informaciją? Istoriškai senovinis siųstuvas galėjo siųsti ar priimti tik du kodo tipus: ir . Iš tiesų dvejetainis kodavimas vis dar plačiai naudojamas visuose šiuolaikiniuose skaitmeniniuose kompiuteriuose. Šitaip bet kuri informacija užkoduojama ir eilute. Todėl ilgio dvejetainių skaitmenų eilutė turi bitų informacijos.
Dabar tarkime, kad bet kokioje kodų eilutėje kiekvienas ar pasirodo su tikimybe . Taigi įvykis su ilgio kodų eilute įvyksta su tikimybe . Kartu, kaip minėjome, ši eilutė turi bitų informacijos. Ar galime tai apibendrinti iki matematinės funkcijos, kuri tikimybę paverčia bitų skaičiumi? Shannonas atsakė apibrėždamas savaiminę informaciją
kaip bitus informacijos, kurią gavome apie šį įvykį . Atkreipkite dėmesį, kad šiame skyriuje visada naudosime dvejetainius logaritmus. Paprastumo dėlei likusioje skyriaus dalyje praleisime apatinį indeksą 2 logaritmo žymėjime, t. y. visada reiškia . Pavyzdžiui, kodas „0010“ turi savaiminę informaciją
Savaiminę informaciją galime apskaičiuoti, kaip parodyta toliau. Prieš tai importuokime visus šiame skyriuje reikalingus paketus.
from mxnet import np
from mxnet.metric import NegativeLogLikelihood
from mxnet.ndarray import nansum
import random

def self_information(p):
    return -np.log2(p)

self_information(1 / 64)
import torch
from torch.nn import NLLLoss

def nansum(x):
    # Define nansum, as pytorch does not offer it inbuilt.
    return x[~torch.isnan(x)].sum()

def self_information(p):
    return -torch.log2(torch.tensor(p)).item()

self_information(1 / 64)
import tensorflow as tf

def log2(x):
    return tf.math.log(x) / tf.math.log(2.)

def nansum(x):
    return tf.reduce_sum(tf.where(tf.math.is_nan(
        x), tf.zeros_like(x), x), axis=-1)

def self_information(p):
    return -log2(tf.constant(p)).numpy()

self_information(1 / 64)
22.11.2 Entropija
Kadangi savaiminė informacija matuoja tik vieno diskretaus įvykio informaciją, mums reikia bendresnio mato bet kuriam atsitiktiniam dydžiui, turinčiam diskretų ar tolydų skirstinį.
22.11.2.1 Entropijos motyvacija
Pabandykime konkrečiai apibrėžti, ko norime. Tai bus neformalus teiginys apie vadinamąsias Shannono entropijos aksiomas. Paaiškės, kad šis sveiko proto teiginių rinkinys priverčia mus prie vienintelio informacijos apibrėžimo. Formalią šių aksiomų versiją kartu su keletu kitų galima rasti (Csiszar, 2008).
- Informacija, kurią gauname stebėdami atsitiktinį dydį, nepriklauso nuo to, kaip vadiname elementus, ar nuo papildomų elementų, kurių tikimybė lygi nuliui, buvimo.
- Informacija, kurią gauname stebėdami du atsitiktinius dydžius, yra ne didesnė nei informacijos, gaunamos stebint juos atskirai, suma. Jei jie nepriklausomi, tai tiksliai suma.
- Informacija, gaunama stebint (beveik) tikrus įvykius, yra (beveik) nulinė.
Nors šio fakto įrodymas viršija mūsų teksto aprėptį, svarbu žinoti, kad tai vienareikšmiškai nulemia formą, kurią turi turėti entropija. Vienintelis šių aksiomų paliekamas dviprasmiškumas yra pagrindinių vienetų pasirinkimas, kuris dažniausiai normuojamas pasirenkant, kaip matėme anksčiau, kad informacija, kurią suteikia vienas sąžiningos monetos metimas, yra vienas bitas.
22.11.2.2 Apibrėžimas
Bet kuriam atsitiktiniam dydžiui , sekančiam tikimybių skirstinį su tikimybės tankio funkcija (t. f.) arba tikimybių masės funkcija (t. m. f.) , tikėtiną informacijos kiekį matuojame per entropiją (arba Shannono entropiją)
Konkrečiai, jei yra diskretus,
Priešingu atveju, jei yra tolydus, entropiją vadiname ir diferencialine entropija
Entropiją galime apibrėžti taip.
def entropy(p):
    entropy = - p * np.log2(p)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(entropy.as_nd_ndarray())
    return out

entropy(np.array([0.1, 0.5, 0.1, 0.3]))
def entropy(p):
    entropy = - p * torch.log2(p)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(entropy)
    return out

entropy(torch.tensor([0.1, 0.5, 0.1, 0.3]))
def entropy(p):
    return nansum(- p * log2(p))

entropy(tf.constant([0.1, 0.5, 0.1, 0.3]))
22.11.2.3 Interpretacijos
Galbūt jums įdomu: kodėl entropijos apibrėžime (22.11.1) naudojame neigiamo logaritmo vidurkį? Štai keletas intuicijų.
Pirma, kodėl naudojame logaritmo funkciją ? Tarkime, kad , kur kiekviena komponentinė funkcija yra nepriklausoma nuo kitų. Tai reiškia, kad kiekviena nepriklausomai prisideda prie bendros informacijos, gaunamos iš . Kaip aptarta aukščiau, norime, kad entropijos formulė būtų adityvi nepriklausomų atsitiktinių dydžių atžvilgiu. Laimei, natūraliai paverčia tikimybių skirstinių sandaugą atskirų narių suma.
Toliau, kodėl naudojame neigiamą ? Intuityviai dažnesni įvykiai turėtų turėti mažiau informacijos nei retesni, nes dažnai daugiau informacijos gauname iš neįprasto atvejo nei iš įprasto. Tačiau monotoniškai auga didėjant tikimybėms ir iš tiesų yra neigiamas visoms reikšmėms intervale . Turime sukonstruoti monotoniškai mažėjantį ryšį tarp įvykių tikimybės ir jų entropijos, kuri idealiu atveju visada bus teigiama (nes nieko, ką stebime, neturėtų priversti mūsų pamiršti tai, ką žinojome). Todėl prieš funkciją pridedame minuso ženklą.
Galiausiai, iš kur atsiranda vidurkio funkcija? Panagrinėkime atsitiktinį dydį . Savaiminę informaciją () galime interpretuoti kaip nuostabos kiekį, kurį jaučiame pamatę tam tikrą rezultatą. Iš tiesų tikimybei artėjant prie nulio, nuostaba tampa begalinė. Panašiai entropiją galime interpretuoti kaip vidutinį nuostabos kiekį stebint . Pavyzdžiui, įsivaizduokite, kad lošimo automatų sistema statistiškai nepriklausomai išduoda simbolius atitinkamai su tikimybėmis . Tada šios sistemos entropija lygi vidutinei savaiminei informacijai stebint kiekvieną išvestį, t. y.,
22.11.2.4 Entropijos savybės
Iš aukščiau pateiktų pavyzdžių ir interpretacijų galime išvesti šias entropijos (22.11.1) savybes. Čia vadiname įvykiu, o – tikimybių skirstiniu.
-
visiems diskretiems (tolydiems entropija gali būti neigiama).
-
Jei su t. f. arba t. m. f. ir bandome įvertinti nauju tikimybių skirstiniu su t. f. arba t. m. f. , tada
Kitaip tariant, duoda apatinę ribą vidutiniam bitų skaičiui, reikalingam simboliams, ištrauktiems iš , užkoduoti.
- Jei , tada perduoda didžiausią informacijos kiekį, jei pasiskirsto tolygiai tarp visų galimų rezultatų. Konkrečiai, jei tikimybių skirstinys yra diskretus su klasių , tada
Jei yra tolydus atsitiktinis dydis, istorija tampa daug sudėtingesnė. Tačiau jei papildomai reikalaujame, kad būtų apibrėžtas baigtiniame intervale (su visomis reikšmėmis tarp ir ), tada turi didžiausią entropiją, jei yra tolygusis skirstinys tame intervale.
22.11.3 Abipusė informacija
Anksčiau apibrėžėme vieno atsitiktinio dydžio entropiją, o kaip dėl atsitiktinių dydžių poros entropijos? Šiuos metodus galime laikyti bandymu atsakyti į tokio tipo klausimą: „Kokia informacija yra ir kartu, palyginti su kiekvienu atskirai? Ar yra perteklinės informacijos, ar visa ji unikali?“
Tolesnėje diskusijoje visada naudosime kaip atsitiktinių dydžių porą, sekančią jungtinį tikimybių skirstinį su t. f. arba t. m. f. , o ir seka tikimybių skirstinius atitinkamai ir .
22.11.3.1 Jungtinė entropija
Panašiai kaip vieno atsitiktinio dydžio entropiją (22.11.1), atsitiktinių dydžių poros jungtinę entropiją apibrėžiame kaip
Tiksliau, viena vertus, jei yra diskrečiųjų atsitiktinių dydžių pora, tada
Kita vertus, jei yra tolydžiųjų atsitiktinių dydžių pora, diferencialinę jungtinę entropiją apibrėžiame kaip
(22.11.2) galime laikyti pasakančia mums visą atsitiktinumą atsitiktinių dydžių poroje. Kaip kraštutinumų porą paminėsime: jei yra du identiški atsitiktiniai dydžiai, tada informacija poroje yra tiksliai vieno informacija ir turime . Kitame kraštutinume, jei ir yra nepriklausomi, tada . Iš tiesų visada turėsime, kad informacija, esanti atsitiktinių dydžių poroje, yra ne mažesnė už bet kurio iš atsitiktinių dydžių entropiją ir ne didesnė už abiejų sumą.
Realizuokime jungtinę entropiją nuo nulio.
def joint_entropy(p_xy):
    joint_ent = -p_xy * np.log2(p_xy)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(joint_ent.as_nd_ndarray())
    return out

joint_entropy(np.array([[0.1, 0.5], [0.1, 0.3]]))
def joint_entropy(p_xy):
    joint_ent = -p_xy * torch.log2(p_xy)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(joint_ent)
    return out

joint_entropy(torch.tensor([[0.1, 0.5], [0.1, 0.3]]))
def joint_entropy(p_xy):
    joint_ent = -p_xy * log2(p_xy)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(joint_ent)
    return out

joint_entropy(tf.constant([[0.1, 0.5], [0.1, 0.3]]))
Atkreipkite dėmesį, kad tai tas pats kodas kaip anksčiau, tačiau dabar jį interpretuojame kitaip – kaip veikiantį su dviejų atsitiktinių dydžių jungtiniu skirstiniu.
22.11.3.2 Sąlyginė entropija
Aukščiau apibrėžta jungtinė entropija yra informacijos kiekis, esantis atsitiktinių dydžių poroje. Tai naudinga, tačiau dažnai ne tai mums rūpi. Panagrinėkime mašininio mokymo aplinką. Tegu yra atsitiktinis dydis (arba atsitiktinių dydžių vektorius), aprašantis paveikslėlio pikselių reikšmes, o – atsitiktinis dydis, kuris yra klasės žymė. turėtų turėti daug informacijos – natūralus paveikslėlis yra sudėtingas dalykas. Tačiau informacija, esanti , parodžius paveikslėlį, turėtų būti maža. Iš tiesų skaitmens paveikslėlis jau turėtų turėti informacijos apie tai, koks tai skaitmuo, nebent skaitmuo neįskaitomas. Todėl, norėdami toliau plėsti savo informacijos teorijos žodyną, turime gebėti samprotauti apie informacijos kiekį atsitiktiniame dydyje, sąlygojamame kito.
Tikimybių teorijoje matėme sąlyginės tikimybės apibrėžimą, skirtą ryšiui tarp kintamųjų matuoti. Dabar norime analogiškai apibrėžti sąlyginę entropiją . Ją galime užrašyti kaip
kur yra sąlyginė tikimybė. Konkrečiai, jei yra diskrečiųjų atsitiktinių dydžių pora, tada
Jei yra tolydžiųjų atsitiktinių dydžių pora, diferencialinė sąlyginė entropija apibrėžiama panašiai:
Dabar natūralu paklausti, kaip sąlyginė entropija susijusi su entropija ir jungtine entropija ? Naudodami aukščiau pateiktus apibrėžimus, galime tai išreikšti aiškiai:
Tai turi intuityvią interpretaciją: informacija , žinant (), yra tokia pati kaip informacija abiejuose ir kartu (), atėmus informaciją, jau esančią . Tai duoda mums informaciją , kuri nėra atvaizduota ir .
Dabar realizuokime sąlyginę entropiją (22.11.3) nuo nulio.
def conditional_entropy(p_xy, p_x):
    p_y_given_x = p_xy/p_x
    cond_ent = -p_xy * np.log2(p_y_given_x)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(cond_ent.as_nd_ndarray())
    return out

conditional_entropy(np.array([[0.1, 0.5], [0.2, 0.3]]), np.array([0.2, 0.8]))
def conditional_entropy(p_xy, p_x):
    p_y_given_x = p_xy/p_x
    cond_ent = -p_xy * torch.log2(p_y_given_x)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(cond_ent)
    return out

conditional_entropy(torch.tensor([[0.1, 0.5], [0.2, 0.3]]),
                    torch.tensor([0.2, 0.8]))
def conditional_entropy(p_xy, p_x):
    p_y_given_x = p_xy/p_x
    cond_ent = -p_xy * log2(p_y_given_x)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(cond_ent)
    return out

conditional_entropy(tf.constant([[0.1, 0.5], [0.2, 0.3]]),
                    tf.constant([0.2, 0.8]))
22.11.3.3 Abipusė informacija
Turėdami ankstesnę atsitiktinių dydžių aplinką, galbūt klausiate: „Dabar, kai žinome, kiek informacijos yra , bet nėra , ar galime panašiai paklausti, kiek informacijos yra bendros tarp ir ?“ Atsakymas bus abipusė informacija, kurią žymėsime .
Užuot šokę tiesiai į formalų apibrėžimą, pasitreniruokime intuiciją pirmiausia bandydami išvesti abipusės informacijos išraišką vien iš anksčiau sukonstruotų narių. Norime rasti informaciją, bendrą dviem atsitiktiniams dydžiams. Vienas būdas tai padaryti – pradėti nuo visos informacijos, esančios ir , ir kartu, o tada atimti dalis, kurios nėra bendros. Informacija, esanti ir , ir kartu, užrašoma . Iš jos norime atimti informaciją, esančią , bet ne , ir informaciją, esančią , bet ne . Kaip matėme ankstesniame skyrelyje, tai atitinkamai duoda ir . Taigi abipusė informacija turėtų būti
Iš tiesų tai yra tinkamas abipusės informacijos apibrėžimas. Išskleidę šių narių apibrėžimus ir juos sujungę, šiek tiek algebros parodo, kad tai tas pats, kas
Visus šiuos ryšius galime apibendrinti paveikslėliu 22.11.1 pav.. Tai puikus intuicijos testas – pamatyti, kodėl visi šie teiginiai taip pat yra ekvivalentūs .
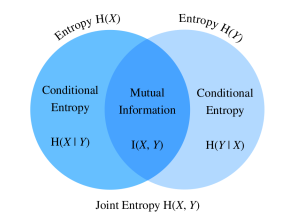
22.11.1 pav. Abipusės informacijos ryšys su jungtine entropija ir sąlygine entropija.
Daugeliu atžvilgių abipusę informaciją (22.11.4) galime laikyti principingu koreliacijos koeficiento, matyto 22.6 skyrelis, išplėtimu. Tai leidžia klausti ne tik apie tiesinius ryšius tarp kintamųjų, bet ir apie didžiausią bet kokios rūšies informaciją, bendrą dviem atsitiktiniams dydžiams.
Dabar realizuokime abipusę informaciją nuo nulio.
def mutual_information(p_xy, p_x, p_y):
    p = p_xy / (p_x * p_y)
    mutual = p_xy * np.log2(p)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(mutual.as_nd_ndarray())
    return out

mutual_information(np.array([[0.1, 0.5], [0.1, 0.3]]),
                   np.array([0.2, 0.8]), np.array([[0.75, 0.25]]))
def mutual_information(p_xy, p_x, p_y):
    p = p_xy / (p_x * p_y)
    mutual = p_xy * torch.log2(p)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(mutual)
    return out

mutual_information(torch.tensor([[0.1, 0.5], [0.1, 0.3]]),
                   torch.tensor([0.2, 0.8]), torch.tensor([[0.75, 0.25]]))
def mutual_information(p_xy, p_x, p_y):
    p = p_xy / (p_x * p_y)
    mutual = p_xy * log2(p)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(mutual)
    return out

mutual_information(tf.constant([[0.1, 0.5], [0.1, 0.3]]),
                   tf.constant([0.2, 0.8]), tf.constant([[0.75, 0.25]]))
22.11.3.4 Abipusės informacijos savybės
Užuot įsimenant abipusės informacijos apibrėžimą (22.11.4), pakanka prisiminti jos svarbiausias savybes:
- Abipusė informacija yra simetriška, t. y. .
- Abipusė informacija yra neneigiama, t. y. .
- tada ir tik tada, kai ir yra nepriklausomi. Pavyzdžiui, jei ir yra nepriklausomi, tai žinojimas nesuteikia jokios informacijos apie ir atvirkščiai, todėl jų abipusė informacija lygi nuliui.
- Kita vertus, jei yra apverčiama funkcija, tada ir dalijasi visa informacija ir
22.11.3.5 Taškinė abipusė informacija
Kai šio skyriaus pradžioje dirbome su entropija, galėjome pateikti interpretaciją kaip tai, kiek nustebome konkrečiu rezultatu. Panašią interpretaciją galime suteikti ir logaritminiam abipusės informacijos nariui, kuris dažnai vadinamas taškine abipuse informacija:
(22.11.5) galime laikyti matuojančia, kiek labiau ar mažiau tikėtina konkreti rezultatų ir kombinacija, palyginti su tuo, ko tikėtumėmės iš nepriklausomų atsitiktinių rezultatų. Jei ji didelė ir teigiama, šie du konkretūs rezultatai pasitaiko daug dažniau, nei būtų atsitiktinai (pastaba: vardiklis yra – tikimybė, jei abu rezultatai būtų nepriklausomi), o jei didelė ir neigiama, tai rodo, kad abu rezultatai įvyksta gerokai rečiau, nei tikėtumėmės atsitiktinai.
Tai leidžia mums abipusę informaciją (22.11.4) interpretuoti kaip vidutinį nuostabos kiekį, kurį jaučiame matydami du rezultatus įvykstant kartu, palyginti su tuo, ko tikėtumėmės, jei jie būtų nepriklausomi.
22.11.3.6 Abipusės informacijos taikymai
Abipusė informacija gali būti šiek tiek abstrakti gryname apibrėžime, tad kaip ji susijusi su mašininiu mokymu? Natūraliosios kalbos apdorojime viena sunkiausių problemų yra daugiareikšmiškumo išsprendimas, arba problema, kai žodžio reikšmė iš konteksto neaiški. Pavyzdžiui, neseniai naujienų antraštė pranešė, kad „Amazon dega“. Galite svarstyti, ar kompanijos „Amazon“ pastatas dega, ar dega Amazonės lietaus miškas.
Šiuo atveju abipusė informacija gali padėti išspręsti šį daugiareikšmiškumą. Pirmiausia randame žodžių grupę, kurių kiekvienas turi santykinai didelę abipusę informaciją su kompanija „Amazon“, pavyzdžiui, e. prekyba, technologijos ir internetas. Antra, randame kitą žodžių grupę, kurių kiekvienas turi santykinai didelę abipusę informaciją su Amazonės lietaus mišku, pavyzdžiui, lietus, miškas ir tropinis. Kai reikia išsklaidyti žodžio „Amazon“ daugiareikšmiškumą, galime palyginti, kuri grupė dažniau pasitaiko žodžio „Amazon“ kontekste. Šiuo atveju straipsnis toliau aprašytų mišką ir kontekstas taptų aiškus.
22.11.4 Kulbako–Leiblerio divergencija
Kaip aptarėme 2.3 skyrelis, normas galime naudoti atstumui tarp dviejų bet kokios dimensijos erdvės taškų matuoti. Norėtume gebėti atlikti panašią užduotį su tikimybių skirstiniais. Tai galima daryti įvairiais būdais, tačiau informacijos teorija siūlo vieną iš gražiausių. Dabar nagrinėjame Kulbako–Leiblerio (KL) divergenciją, kuri suteikia būdą išmatuoti, ar du skirstiniai yra artimi, ar ne.
22.11.4.1 Apibrėžimas
Tarkime, atsitiktinis dydis seka tikimybių skirstinį su t. f. arba t. m. f. , o įvertiname kitu tikimybių skirstiniu su t. f. arba t. m. f. . Tada Kulbako–Leiblerio (KL) divergencija (arba santykinė entropija) tarp ir yra
Kaip ir su taškine abipuse informacija (22.11.5), vėl galime pateikti logaritminio nario interpretaciją: bus didelis ir teigiamas, jei matome daug dažniau pagal , nei tikėtumėmės pagal , ir didelis ir neigiamas, jei rezultatą matome daug rečiau, nei tikėtasi. Šitaip galime ją interpretuoti kaip mūsų santykinę nuostabą stebint rezultatą, palyginti su tuo, kiek nustebtume jį stebėdami iš savo atskaitos skirstinio.
Realizuokime KL divergenciją nuo nulio.
def kl_divergence(p, q):
    kl = p * np.log2(p / q)
    out = nansum(kl.as_nd_ndarray())
    return out.abs().asscalar()
def kl_divergence(p, q):
    kl = p * torch.log2(p / q)
    out = nansum(kl)
    return out.abs().item()
def kl_divergence(p, q):
    kl = p * log2(p / q)
    out = nansum(kl)
    return tf.abs(out).numpy()
22.11.4.2 KL divergencijos savybės
Pažvelkime į kai kurias KL divergencijos (22.11.6) savybes.
- KL divergencija yra nesimetrinė, t. y. egzistuoja , kad
- KL divergencija yra neneigiama, t. y.
Atkreipkite dėmesį, kad lygybė galioja tik kai .
-
Jei egzistuoja toks , kad ir , tada .
-
Tarp KL divergencijos ir abipusės informacijos yra glaudus ryšys. Be ryšio, parodyto 22.11.1 pav., skaitine verte taip pat lygus šiems dydžiams:
- ;
- ;
- .
Pirmajame naryje abipusę informaciją interpretuojame kaip KL divergenciją tarp ir bei sandaugos, todėl tai yra matas, kiek jungtinis skirstinys skiriasi nuo skirstinio, kuris būtų, jei jie būtų nepriklausomi. Antrajame naryje abipusė informacija mums pasako vidutinį neapibrėžtumo apie sumažėjimą, atsirandantį sužinojus skirstinio reikšmę. Panašiai ir trečiajame naryje.
22.11.4.3 Pavyzdys
Išnagrinėkime žaislinį pavyzdį, kad aiškiai pamatytume nesimetriškumą.
Pirmiausia sugeneruokime ir surikiuokime tris ilgio tenzorius: tikslinį tenzorių , sekantį normalųjį skirstinį , ir du kandidatinius tenzorius ir , atitinkamai sekančius normaliuosius skirstinius ir .
random.seed(1)

nd_len = 10000
p = np.random.normal(loc=0, scale=1, size=(nd_len, ))
q1 = np.random.normal(loc=-1, scale=1, size=(nd_len, ))
q2 = np.random.normal(loc=1, scale=1, size=(nd_len, ))

p = np.array(sorted(p.asnumpy()))
q1 = np.array(sorted(q1.asnumpy()))
q2 = np.array(sorted(q2.asnumpy()))
torch.manual_seed(1)

tensor_len = 10000
p = torch.normal(0, 1, (tensor_len, ))
q1 = torch.normal(-1, 1, (tensor_len, ))
q2 = torch.normal(1, 1, (tensor_len, ))

p = torch.sort(p)[0]
q1 = torch.sort(q1)[0]
q2 = torch.sort(q2)[0]
tensor_len = 10000
p = tf.random.normal((tensor_len, ), 0, 1)
q1 = tf.random.normal((tensor_len, ), -1, 1)
q2 = tf.random.normal((tensor_len, ), 1, 1)

p = tf.sort(p)
q1 = tf.sort(q1)
q2 = tf.sort(q2)
Kadangi ir yra simetriški y ašies atžvilgiu (t. y. ), tikimės panašios KL divergencijos reikšmės tarp ir . Kaip matote toliau, tarp ir skirtumas yra mažesnis nei 3 %.
kl_pq1 = kl_divergence(p, q1)
kl_pq2 = kl_divergence(p, q2)
similar_percentage = abs(kl_pq1 - kl_pq2) / ((kl_pq1 + kl_pq2) / 2) * 100

kl_pq1, kl_pq2, similar_percentage
Priešingai, galite pastebėti, kad ir labai skiriasi – apie 40 %, kaip parodyta toliau.
kl_q2p = kl_divergence(q2, p)
differ_percentage = abs(kl_q2p - kl_pq2) / ((kl_q2p + kl_pq2) / 2) * 100

kl_q2p, differ_percentage
22.11.5 Kryžminė entropija
Jei domina informacijos teorijos taikymai giliajame mokyme, štai trumpas pavyzdys. Tikrąjį skirstinį apibrėžiame su tikimybių skirstiniu , o įvertintąjį skirstinį – su tikimybių skirstiniu , ir juos naudosime likusioje šio skyriaus dalyje.
Tarkime, reikia išspręsti dvejetainio klasifikavimo uždavinį pagal duotus duomenų pavyzdžių {}. Tarkime, kad ir užkoduojame kaip atitinkamai teigiamą ir neigiamą klasės žymę , o mūsų neuroninis tinklas parametrizuotas . Jei siekiame rasti geriausią , kad , natūralu taikyti didžiausio logaritminio tikėtinumo metodą, kaip matėme 22.7 skyrelis. Konkrečiai, tikroms žymėms ir prognozėms tikimybė būti klasifikuotam kaip teigiamam yra . Todėl logaritminio tikėtinumo funkcija būtų
Logaritminio tikėtinumo funkcijos maksimizavimas yra tapatus minimizavimui, taigi iš čia galime rasti geriausią . Kad aukščiau pateiktus nuostolius apibendrintume bet kuriems skirstiniams, taip pat pavadinome kryžminės entropijos nuostoliais , kur seka tikrąjį skirstinį , o – įvertintąjį skirstinį .
Visa tai buvo išvesta dirbant iš didžiausio tikėtinumo požiūrio taško. Tačiau jei atidžiai pažiūrėsime, pamatysime, kad į mūsų skaičiavimą pateko tokie nariai kaip , o tai tvirtas ženklas, kad išraišką galime suprasti ir iš informacijos teorijos požiūrio.
22.11.5.1 Formalus apibrėžimas
Kaip ir KL divergenciją, atsitiktiniam dydžiui divergenciją tarp įvertinančiojo skirstinio ir tikrojo skirstinio galime matuoti ir per kryžminę entropiją,
Naudodami aukščiau aptartas entropijos savybes, ją taip pat galime interpretuoti kaip entropijos ir KL divergencijos tarp ir sumą, t. y.,
Kryžminės entropijos nuostolius galime realizuoti taip.
def cross_entropy(y_hat, y):
    ce = -np.log(y_hat[range(len(y_hat)), y])
    return ce.mean()
def cross_entropy(y_hat, y):
    ce = -torch.log(y_hat[range(len(y_hat)), y])
    return ce.mean()
def cross_entropy(y_hat, y):
    # `tf.gather_nd` is used to select specific indices of a tensor.
    ce = -tf.math.log(tf.gather_nd(y_hat, indices = [[i, j] for i, j in zip(
        range(len(y_hat)), y)]))
    return tf.reduce_mean(ce).numpy()
Dabar apibrėžkime du tenzorius žymėms ir prognozėms ir apskaičiuokime jų kryžminės entropijos nuostolius.
labels = np.array([0, 2])
preds = np.array([[0.3, 0.6, 0.1], [0.2, 0.3, 0.5]])

cross_entropy(preds, labels)
labels = torch.tensor([0, 2])
preds = torch.tensor([[0.3, 0.6, 0.1], [0.2, 0.3, 0.5]])

cross_entropy(preds, labels)
labels = tf.constant([0, 2])
preds = tf.constant([[0.3, 0.6, 0.1], [0.2, 0.3, 0.5]])

cross_entropy(preds, labels)
22.11.5.2 Savybės
Kaip užsiminta šio skyriaus pradžioje, kryžminė entropija (22.11.7) gali būti naudojama nuostolių funkcijai optimizavimo uždavinyje apibrėžti. Paaiškėja, kad šie dalykai yra ekvivalentūs:
- prognozinės tikimybės skirstiniui maksimizavimas (t. y. );
- Kryžminės entropijos minimizavimas;
- KL divergencijos minimizavimas.
Kryžminės entropijos apibrėžimas netiesiogiai įrodo ekvivalentų ryšį tarp 2 ir 3 tikslo, kol tikrųjų duomenų entropija yra pastovi.
22.11.5.3 Kryžminė entropija kaip daugiaklasio klasifikavimo tikslo funkcija
Jei pasigilinsime į klasifikavimo tikslo funkciją su kryžminės entropijos nuostoliais , pamatysime, kad minimizavimas yra ekvivalentus logaritminio tikėtinumo funkcijos maksimizavimui.
Pradžiai tarkime, kad turime duomenų rinkinį su pavyzdžių, kuriuos galima klasifikuoti į klasių. Kiekvienam duomenų pavyzdžiui bet kurią klasių žymę vaizduojame fiktyvių kintamųjų kodavimu. Konkrečiai, jei pavyzdys priklauso klasei , tada -ąjį elementą nustatome į , o visas kitas komponentes – į , t. y.,
Pavyzdžiui, jei daugiaklasio klasifikavimo uždavinys turi tris klases , ir , tada žymės gali būti užkoduotos kaip {}.
Tarkime, kad mūsų neuroninis tinklas parametrizuotas . Tikriems žymių vektoriams ir prognozėms
Todėl kryžminės entropijos nuostoliai būtų
Kita vertus, į problemą galime žiūrėti ir per didžiausio tikėtinumo įvertinimą. Pradžiai trumpai pristatykime klasių multinulio skirstinį. Tai Bernulio skirstinio išplėtimas nuo dvejetainės iki daugiaklasės. Jei atsitiktinis vektorius seka klasių multinulio skirstinį su tikimybėmis (), t. y.
tada jungtinė tikimybių masės funkcija (t. m. f.) yra
Matyti, kad kiekvieno duomenų pavyzdžio žymė seka klasių multinulio skirstinį su tikimybėmis (). Todėl kiekvieno duomenų pavyzdžio jungtinė t. m. f. yra Todėl logaritminio tikėtinumo funkcija būtų
Kadangi didžiausio tikėtinumo įvertinime maksimizuojame tikslo funkciją imdami , bet kuriam daugiaklasiam klasifikavimui aukščiau pateiktos logaritminio tikėtinumo funkcijos maksimizavimas yra ekvivalentus kryžminės entropijos nuostolių minimizavimui.
Kad patikrintume aukščiau pateiktą įrodymą, pritaikykime įtaisytą matą NegativeLogLikelihood. Naudodami tuos pačius labels ir preds kaip ankstesniame pavyzdyje, gausime tokius pačius skaitinius nuostolius kaip ankstesniame pavyzdyje iki 5-ojo ženklo po kablelio.
nll_loss = NegativeLogLikelihood()
nll_loss.update(labels.as_nd_ndarray(), preds.as_nd_ndarray())
nll_loss.get()
# Implementation of cross-entropy loss in PyTorch combines `nn.LogSoftmax()`
# and `nn.NLLLoss()`
nll_loss = NLLLoss()
loss = nll_loss(torch.log(preds), labels)
loss
def nll_loss(y_hat, y):
    # Convert labels to one-hot vectors.
    y = tf.keras.utils.to_categorical(y, num_classes= y_hat.shape[1])
    # We will not calculate negative log-likelihood from the definition.
    # Rather, we will follow a circular argument. Because NLL is same as
    # `cross_entropy`, if we calculate cross_entropy that would give us NLL
    cross_entropy = tf.keras.losses.CategoricalCrossentropy(
        from_logits = True, reduction = tf.keras.losses.Reduction.NONE)
    return tf.reduce_mean(cross_entropy(y, y_hat)).numpy()

loss = nll_loss(tf.math.log(preds), labels)
loss
22.11.6 Santrauka
- Informacijos teorija yra tyrimų sritis, nagrinėjanti informacijos kodavimą, dekodavimą, perdavimą ir manipuliavimą ja.
- Entropija yra vienetas, matuojantis, kiek informacijos yra skirtinguose signaluose.
- KL divergencija taip pat gali matuoti divergenciją tarp dviejų skirstinių.
- Kryžminę entropiją galima laikyti daugiaklasio klasifikavimo tikslo funkcija. Kryžminės entropijos nuostolių minimizavimas yra ekvivalentus logaritminio tikėtinumo funkcijos maksimizavimui.
22.11.7 Pratimai
- Patikrinkite, kad pirmajame skyriuje pateikti kortų pavyzdžiai iš tiesų turi nurodytą entropiją.
- Parodykite, kad KL divergencija yra neneigiama visiems skirstiniams ir . Užuomina: naudokite Jenseno nelygybę, t. y. faktą, kad yra iškilioji funkcija.
- Apskaičiuokime entropiją iš kelių duomenų šaltinių:
- Tarkime, kad stebite beždžionės, spausdinančios rašomąja mašinėle, sugeneruotą išvestį. Beždžionė atsitiktinai paspaudžia bet kurį iš rašomosios mašinėlės klavišų (galite laikyti, kad ji dar neatrado jokių specialiųjų klavišų ar „shift“ klavišo). Kiek atsitiktinumo bitų vienam simboliui stebite?
- Nepatenkinti beždžione, ją pakeičiate girtu rinkėju. Jis geba generuoti žodžius, nors ir nenuosekliai. Vietoj to jis atsitiktinai pasirenka žodį iš žodžių žodyno. Tarkime, kad vidutinis žodžio ilgis anglų kalboje yra raidės. Kiek atsitiktinumo bitų vienam simboliui stebite dabar?
- Vis dar nepatenkinti rezultatu, rinkėją pakeičiate aukštos kokybės kalbos modeliu. Kalbos modelis šiuo metu gali pasiekti net punktų painiavą (angl. perplexity) vienam žodžiui. Kalbos modelio simbolio painiava apibrėžiama kaip tikimybių rinkinio geometrinio vidurkio atvirkštinis dydis, kai kiekviena tikimybė atitinka žodžio simbolį. Konkrečiai, jei duoto žodžio ilgis yra , tada Tarkime, kad testinis žodis turi 4,5 raidės. Kiek atsitiktinumo bitų vienam simboliui stebite dabar?
- Intuityviai paaiškinkite, kodėl . Tada parodykite, kad tai tiesa, išreikšdami abi puses kaip vidurkį jungtinio skirstinio atžvilgiu.
- Kokia yra KL divergencija tarp dviejų Gauso skirstinių ir ?