
22.1 Geometrija ir tiesinės algebros operacijos
2.3 skyrelis susipažinome su tiesinės algebros pagrindais ir matėme, kaip ją galima naudoti įprastoms duomenų transformavimo operacijoms išreikšti. Tiesinė algebra yra vienas pagrindinių matematinių ramsčių, slypinčių po didele dalimi darbo, kurį atliekame giliajame mokyme ir plačiau – mašininiame mokyme. Nors 2.3 skyrelis buvo pakankamai priemonių, kad perteiktume šiuolaikinių giliojo mokymosi modelių veikimo mechaniką, šioje temoje yra daug daugiau. Šiame skyriuje pasigilinsime, išryškindami kai kurias geometrines tiesinės algebros operacijų interpretacijas ir pristatydami keletą pagrindinių sąvokų, įskaitant tikrines reikšmes ir tikrinius vektorius.
22.1.1 Vektorių geometrija
Pirmiausia turime aptarti dvi įprastas geometrines vektorių interpretacijas – kaip taškus arba kryptis erdvėje. Iš esmės vektorius yra skaičių sąrašas, pavyzdžiui, toliau pateiktas Python sąrašas.
v = [1, 7, 0, 1]
Matematikai dažniausiai tai užrašo kaip stulpelio arba eilutės vektorių, t. y. kaip
arba
Jie dažnai turi skirtingas interpretacijas: duomenų pavyzdžiai yra stulpelio vektoriai, o svoriai, naudojami svertinėms sumoms sudaryti, yra eilutės vektoriai. Vis dėlto gali būti naudinga būti lanksčiam. Kaip aprašėme 2.3 skyrelis, nors vieno vektoriaus numatytoji orientacija yra stulpelio vektorius, bet kuriai matricai, vaizduojančiai lentelinį duomenų rinkinį, įprasčiau kiekvieną duomenų pavyzdį matricoje laikyti eilutės vektoriumi.
Turint vektorių, pirmoji interpretacija, kurią turėtume jam suteikti, yra taškas erdvėje. Dviejose ar trijose dimensijose šiuos taškus galime pavaizduoti naudodami vektorių komponentes taškų vietai erdvėje nustatyti palyginti su fiksuotu atskaitos tašku, vadinamu koordinačių pradžia. Tai matyti 22.1.1 pav..
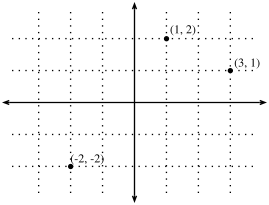
22.1.1 pav. Iliustracija, kaip vektorius pavaizduoti kaip taškus plokštumoje. Pirmoji vektoriaus komponentė duoda koordinatę, antroji – koordinatę. Aukštesnės dimensijos yra analogiškos, nors daug sunkiau pavaizduojamos.
Šis geometrinis požiūris leidžia nagrinėti problemą abstraktesniu lygmeniu. Nebesusidūrę su atrodančia neįveikiama problema, tokia kaip paveikslėlių klasifikavimas į kates ar šunis, galime pradėti nagrinėti užduotis abstrakčiai – kaip taškų rinkinius erdvėje – ir įsivaizduoti užduotį kaip būdo atskirti du skirtingus taškų klasterius paiešką.
Lygiagrečiai egzistuoja antras požiūris, kurį žmonės dažnai taiko vektoriams: kaip kryptims erdvėje. Vektorių galime laikyti ne tik tašku, esančiu vienetus į dešinę ir vienetus aukštyn nuo koordinačių pradžios, bet ir pačia kryptimi: žengti žingsnius į dešinę ir žingsnius aukštyn. Šitaip visus vektorius 22.1.2 pav. laikome tuo pačiu.
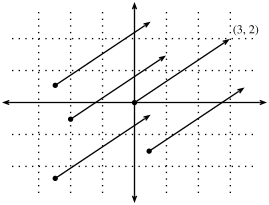
22.1.2 pav. Bet kurį vektorių galima pavaizduoti kaip rodyklę plokštumoje. Šiuo atveju kiekvienas nubrėžtas vektorius yra vektoriaus atvaizdas.
Vienas šio poslinkio privalumų yra tas, kad galime vizualiai suprasti vektorių sudėties veiksmą. Visų pirma sekame vieno vektoriaus nurodytas kryptis, o tada sekame kito vektoriaus nurodytas kryptis, kaip matyti 22.1.3 pav..
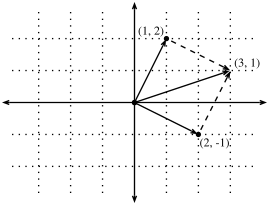
22.1.3 pav. Vektorių sudėtį galime pavaizduoti pirmiausia sekdami vieną vektorių, o tada kitą.
Vektorių atimtis turi panašią interpretaciją. Nagrinėdami tapatybę , matome, kad vektorius yra kryptis, kuri mus nuveda iš taško į tašką .
22.1.2 Skaliarinės sandaugos ir kampai
Kaip matėme 2.3 skyrelis, jei paimame du stulpelio vektorius ir , jų skaliarinę sandaugą galime sudaryti apskaičiuodami:
Kadangi (22.1.1) yra simetrinė, atkartosime klasikinės daugybos žymėjimą ir rašysime
kad pabrėžtume faktą, jog sukeitus vektorių tvarką gaunamas tas pats atsakymas.
Skaliarinė sandauga (22.1.1) taip pat turi geometrinę interpretaciją: ji glaudžiai susijusi su kampu tarp dviejų vektorių. Panagrinėkime kampą, parodytą 22.1.4 pav..
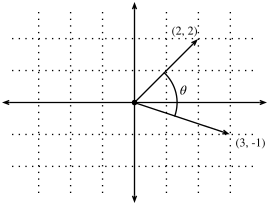
22.1.4 pav. Tarp bet kurių dviejų vektorių plokštumoje yra gerai apibrėžtas kampas . Pamatysime, kad šis kampas glaudžiai susijęs su skaliarine sandauga.
Pradžiai panagrinėkime du konkrečius vektorius:
Vektorius yra ilgio ir eina lygiagrečiai ašiai, o vektorius yra ilgio ir sudaro kampą su ašimi. Jei apskaičiuosime šių dviejų vektorių skaliarinę sandaugą, matome, kad
Atlikę paprastą algebrinį pertvarkymą, galime pertvarkyti narius ir gauti
Trumpai tariant, šiems dviem konkretiems vektoriams skaliarinė sandauga kartu su normomis mums pasako kampą tarp dviejų vektorių. Tas pats faktas teisingas ir bendru atveju. Čia neišvesime išraiškos, tačiau jei nagrinėsime užrašymą dviem būdais: vienu su skaliarine sandauga, o kitu geometriškai naudodami kosinusų teoremą, galime gauti pilną ryšį. Iš tiesų bet kuriems dviem vektoriams ir kampas tarp dviejų vektorių yra
Tai gražus rezultatas, nes niekas skaičiavime neužsimena apie dvi dimensijas. Iš tiesų galime tai naudoti trijose ar trijuose milijonuose dimensijų be jokių problemų.
Kaip paprastą pavyzdį pažiūrėkime, kaip apskaičiuoti kampą tarp vektorių poros:
%matplotlib inline
from d2l import mxnet as d2l
from IPython import display
from mxnet import gluon, np, npx
npx.set_np()

def angle(v, w):
    return np.arccos(v.dot(w) / (np.linalg.norm(v) * np.linalg.norm(w)))

angle(np.array([0, 1, 2]), np.array([2, 3, 4]))
%matplotlib inline
from d2l import torch as d2l
from IPython import display
import torch
from torchvision import transforms
import torchvision

def angle(v, w):
    return torch.acos(v.dot(w) / (torch.norm(v) * torch.norm(w)))

angle(torch.tensor([0, 1, 2], dtype=torch.float32), torch.tensor([2.0, 3, 4]))
%matplotlib inline
from d2l import tensorflow as d2l
from IPython import display
import tensorflow as tf

def angle(v, w):
    return tf.acos(tf.tensordot(v, w, axes=1) / (tf.norm(v) * tf.norm(w)))

angle(tf.constant([0, 1, 2], dtype=tf.float32), tf.constant([2.0, 3, 4]))
Dabar to nenaudosime, tačiau naudinga žinoti, kad vektorius, kurių kampas yra (arba, ekvivalenčiai, ), vadinsime ortogonaliaisiais. Nagrinėdami aukščiau pateiktą lygtį, matome, kad taip nutinka, kai , o tai tas pats, kas . Vienintelis būdas tam nutikti yra tada, kai pati skaliarinė sandauga lygi nuliui, ir du vektoriai yra ortogonalūs tada ir tik tada, kai . Tai pasirodys esanti naudinga formulė geometriškai suprantant objektus.
Pagrįsta klausti: kodėl naudinga skaičiuoti kampą? Atsakymas slypi tokioje invariantiškumo rūšyje, kokios tikimės iš duomenų. Panagrinėkime paveikslėlį ir jo dublikatą, kuriame kiekvieno pikselio reikšmė ta pati, bet ryškumo. Pavienių pikselių reikšmės apskritai yra toli nuo pradinių reikšmių. Taigi jei apskaičiuotume atstumą tarp pradinio paveikslėlio ir tamsesnio, atstumas gali būti didelis. Tačiau daugumai MM taikymų turinys yra tas pats – katės / šuns klasifikatoriui tai vis dar katės paveikslėlis. Vis dėlto jei nagrinėsime kampą, nesunku pamatyti, kad bet kuriam vektoriui kampas tarp ir yra nulis. Tai atitinka faktą, kad vektorių skalėjimas palieka tą pačią kryptį ir tik pakeičia ilgį. Kampas tamsesnį paveikslėlį laiko identišku.
Tokių pavyzdžių yra visur. Tekste galime norėti, kad aptariama tema nepasikeistų, jei parašysime dvigubai ilgesnį dokumentą, sakantį tą patį. Kai kuriems kodavimams (pavyzdžiui, skaičiuojant žodžių pasikartojimus kokiame nors žodyne) tai atitinka dokumentą koduojančio vektoriaus padvigubinimą, taigi vėl galime naudoti kampą.
22.1.2.1 Kosinusinis panašumas
MM kontekstuose, kuriuose kampas naudojamas dviejų vektorių artumui matuoti, praktikai naudoja terminą kosinusinis panašumas daliai
žymėti.
Kosinusas įgyja didžiausią reikšmę , kai du vektoriai rodo ta pačia kryptimi, mažiausią reikšmę , kai jie rodo priešingomis kryptimis, ir reikšmę , kai du vektoriai yra ortogonalūs. Atkreipkite dėmesį, kad jei aukštų dimensijų vektorių komponentės atrenkamos atsitiktinai su vidurkiu , jų kosinusas beveik visada bus artimas .
22.1.3 Hiperplokštumos
Be darbo su vektoriais, kitas esminis objektas, kurį turite suprasti, norėdami toli nueiti tiesinėje algebroje, yra hiperplokštuma – tiesės (dvi dimensijos) arba plokštumos (trys dimensijos) apibendrinimas aukštesnėms dimensijoms. dimensijų vektorinėje erdvėje hiperplokštuma turi dimensijų ir padalija erdvę į dvi puserdves.
Pradėkime nuo pavyzdžio. Tarkime, turime stulpelio vektorių . Norime žinoti: „kokie yra taškai , kuriems ?“ Prisiminę aukščiau pateiktą ryšį tarp skaliarinių sandaugų ir kampų (22.1.2), matome, kad tai ekvivalentu
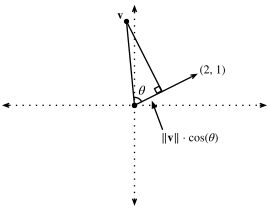
22.1.5 pav. Prisiminę trigonometriją, matome, kad formulė yra vektoriaus projekcijos į kryptį ilgis
Jei nagrinėsime geometrinę šios išraiškos prasmę, matome, kad tai ekvivalentu teiginiui, jog projekcijos į kryptį ilgis yra tiksliai , kaip parodyta 22.1.5 pav.. Visų taškų, kuriems tai teisinga, aibė yra tiesė, statmena vektoriui . Jei norėtume, galėtume rasti šios tiesės lygtį ir pamatyti, kad ji yra arba, ekvivalenčiai, .
Jei dabar pažiūrėsime, kas nutinka klausiant apie taškų aibę, kuriems arba , matome, kad tai atvejai, kai projekcijos yra atitinkamai ilgesnės arba trumpesnės nei . Taigi šios dvi nelygybės apibrėžia abi tiesės puses. Šitaip radome būdą padalyti savo erdvę į dvi puses, kur visi vienoje pusėje esantys taškai turi skaliarinę sandaugą žemiau slenksčio, o kitoje pusėje – aukščiau, kaip matome 22.1.6 pav..
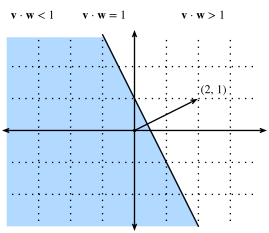
22.1.6 pav. Jei dabar nagrinėsime nelygybės išraiškos versiją, matome, kad mūsų hiperplokštuma (šiuo atveju tiesiog tiesė) padalija erdvę į dvi puses.
Aukštesnėse dimensijose istorija labai panaši. Jei dabar paimsime ir paklausime apie taškus trijose dimensijose, kuriems , gausime plokštumą, statmeną duotam vektoriui . Dvi nelygybės vėl apibrėžia dvi plokštumos puses, kaip parodyta 22.1.7 pav..
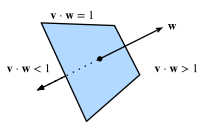
22.1.7 pav. Bet kurios dimensijos hiperplokštumos padalija erdvę į dvi puses.
Nors mūsų gebėjimas vizualizuoti čia baigiasi, niekas netrukdo to daryti dešimtyse, šimtuose ar milijarduose dimensijų. Tai dažnai nutinka galvojant apie išmoktus mašininio mokymo modelius. Pavyzdžiui, tiesinius klasifikavimo modelius, tokius kaip aprašyti 4.1 skyrelis, galime suprasti kaip metodus hiperplokštumoms, skiriančioms skirtingas tikslines klases, rasti. Šiame kontekste tokios hiperplokštumos dažnai vadinamos sprendimų plokštumomis. Dauguma giluminių klasifikavimo modelių baigiasi tiesiniu sluoksniu, paduodamu į softmax, todėl giliojo neuroninio tinklo vaidmenį galima interpretuoti kaip netiesinio įterpinio paiešką, kad tikslines klases būtų galima švariai atskirti hiperplokštumomis.
Kad pateiktume ranka sukurtą pavyzdį, atkreipkite dėmesį, kad galime sukurti pagrįstą modelį mažiems marškinėlių ir kelnių paveikslėliams iš Fashion-MNIST duomenų rinkinio (matytam 4.2 skyrelis) klasifikuoti tiesiog paėmę vektorių tarp jų vidurkių sprendimų plokštumai apibrėžti ir akimis įvertinę grubų slenkstį. Pirmiausia įkelsime duomenis ir apskaičiuosime vidurkius.
# Load in the dataset
train = gluon.data.vision.FashionMNIST(train=True)
test = gluon.data.vision.FashionMNIST(train=False)

X_train_0 = np.stack([x[0] for x in train if x[1] == 0]).astype(float)
X_train_1 = np.stack([x[0] for x in train if x[1] == 1]).astype(float)
X_test = np.stack(
    [x[0] for x in test if x[1] == 0 or x[1] == 1]).astype(float)
y_test = np.stack(
    [x[1] for x in test if x[1] == 0 or x[1] == 1]).astype(float)

# Compute averages
ave_0 = np.mean(X_train_0, axis=0)
ave_1 = np.mean(X_train_1, axis=0)
# Load in the dataset
trans = []
trans.append(transforms.ToTensor())
trans = transforms.Compose(trans)
train = torchvision.datasets.FashionMNIST(root="../data", transform=trans,
                                          train=True, download=True)
test = torchvision.datasets.FashionMNIST(root="../data", transform=trans,
                                         train=False, download=True)

X_train_0 = torch.stack(
    [x[0] * 256 for x in train if x[1] == 0]).type(torch.float32)
X_train_1 = torch.stack(
    [x[0] * 256 for x in train if x[1] == 1]).type(torch.float32)
X_test = torch.stack(
    [x[0] * 256 for x in test if x[1] == 0 or x[1] == 1]).type(torch.float32)
y_test = torch.stack([torch.tensor(x[1]) for x in test
                      if x[1] == 0 or x[1] == 1]).type(torch.float32)

# Compute averages
ave_0 = torch.mean(X_train_0, axis=0)
ave_1 = torch.mean(X_train_1, axis=0)
# Load in the dataset
((train_images, train_labels), (
    test_images, test_labels)) = tf.keras.datasets.fashion_mnist.load_data()

X_train_0 = tf.cast(tf.stack(train_images[[i for i, label in enumerate(
    train_labels) if label == 0]] * 256), dtype=tf.float32)
X_train_1 = tf.cast(tf.stack(train_images[[i for i, label in enumerate(
    train_labels) if label == 1]] * 256), dtype=tf.float32)
X_test = tf.cast(tf.stack(test_images[[i for i, label in enumerate(
    test_labels) if label == 0]] * 256), dtype=tf.float32)
y_test = tf.cast(tf.stack(test_images[[i for i, label in enumerate(
    test_labels) if label == 1]] * 256), dtype=tf.float32)

# Compute averages
ave_0 = tf.reduce_mean(X_train_0, axis=0)
ave_1 = tf.reduce_mean(X_train_1, axis=0)
Gali būti informatyvu išsamiai panagrinėti šiuos vidurkius, todėl nubraižykime, kaip jie atrodo. Šiuo atveju matome, kad vidurkis iš tiesų primena neryškų marškinėlių paveikslėlį.
# Plot average t-shirt
d2l.set_figsize()
d2l.plt.imshow(ave_0.reshape(28, 28).tolist(), cmap='Greys')
d2l.plt.show()
# Plot average t-shirt
d2l.set_figsize()
d2l.plt.imshow(tf.reshape(ave_0, (28, 28)), cmap='Greys')
d2l.plt.show()
Antruoju atveju vėl matome, kad vidurkis primena neryškų kelnių paveikslėlį.
# Plot average trousers
d2l.plt.imshow(ave_1.reshape(28, 28).tolist(), cmap='Greys')
d2l.plt.show()
# Plot average trousers
d2l.plt.imshow(tf.reshape(ave_1, (28, 28)), cmap='Greys')
d2l.plt.show()
Visiškai mašinomis išmoktame sprendime slenkstį išmoktume iš duomenų rinkinio. Šiuo atveju aš tiesiog ranka akimis įvertinau slenkstį, kuris atrodė gerai mokymo duomenims.
# Print test set accuracy with eyeballed threshold
w = (ave_1 - ave_0).T
predictions = X_test.reshape(2000, -1).dot(w.flatten()) > -1500000

# Accuracy
np.mean(predictions.astype(y_test.dtype) == y_test, dtype=np.float64)
# Print test set accuracy with eyeballed threshold
w = (ave_1 - ave_0).T
# '@' is Matrix Multiplication operator in pytorch.
predictions = X_test.reshape(2000, -1) @ (w.flatten()) > -1500000

# Accuracy
torch.mean((predictions.type(y_test.dtype) == y_test).float(), dtype=torch.float64)
# Print test set accuracy with eyeballed threshold
w = tf.transpose(ave_1 - ave_0)
predictions = tf.reduce_sum(X_test * tf.nest.flatten(w), axis=0) > -1500000

# Accuracy
tf.reduce_mean(
    tf.cast(tf.cast(predictions, y_test.dtype) == y_test, tf.float32))
22.1.4 Tiesinių transformacijų geometrija
Per 2.3 skyrelis ir aukščiau pateiktas diskusijas turime tvirtą vektorių, ilgių ir kampų geometrijos supratimą. Tačiau yra vienas svarbus objektas, kurio aptarimą praleidome – tai geometrinis matricomis vaizduojamų tiesinių transformacijų supratimas. Visiškai suvokti, ką matricos gali padaryti transformuodamos duomenis tarp dviejų potencialiai skirtingų aukštų dimensijų erdvių, reikia daug praktikos, ir tai viršija šio priedo aprėptį. Vis dėlto intuiciją galime pradėti kaupti dviejose dimensijose.
Tarkime, turime kokią nors matricą:
Jei norime ją pritaikyti savavališkam vektoriui , padauginame ir matome, kad
Tai gali atrodyti kaip keistas skaičiavimas, kuriame kažkas aiškaus tapo šiek tiek neįveikiama. Tačiau tai mums sako, kad galime užrašyti, kaip matrica transformuoja bet kurį vektorių, per tai, kaip ji transformuoja du konkrečius vektorius: ir . Tai verta akimirką apmąstyti. Iš esmės begalinę problemą (kas nutinka bet kuriai realiųjų skaičių porai) sumažinome iki baigtinės (kas nutinka šiems konkretiems vektoriams). Šie vektoriai yra bazės pavyzdys, kai bet kurį mūsų erdvės vektorių galime užrašyti kaip šių bazės vektorių svertinę sumą.
Nubraižykime, kas nutinka naudojant konkrečią matricą
Jei pažiūrėsime į konkretų vektorių , matome, kad tai , taigi žinome, kad matrica jį nusiųs į . Jei atidžiai pasieksime šią logiką iki galo, tarkime, nagrinėdami visų sveikųjų skaičių porų taškų tinklelį, matome, kad nutinka tai, jog matricos daugyba gali iškreipti, pasukti ir perskalėti tinklelį, tačiau tinklelio struktūra turi išlikti, kaip matote 22.1.8 pav..
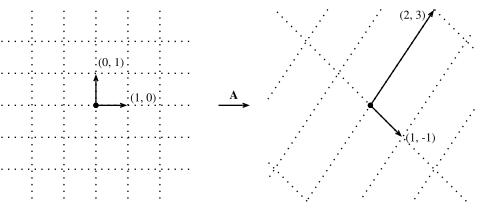
22.1.8 pav. Matrica , veikianti duotus bazės vektorius. Atkreipkite dėmesį, kaip kartu su jais perkeliamas visas tinklelis.
Tai svarbiausias intuityvus dalykas, kurį reikia įsisavinti apie matricomis vaizduojamas tiesines transformacijas. Matricos negali iškreipti vienų erdvės dalių kitaip nei kitų. Viskas, ką jos gali padaryti, – paimti pradines mūsų erdvės koordinates ir jas iškreipti, pasukti ir perskalėti.
Kai kurie iškraipymai gali būti stiprūs. Pavyzdžiui, matrica
suspaudžia visą dvimatę plokštumą į vieną tiesę. Tokių transformacijų atpažinimas ir darbas su jomis yra vėlesnio skyriaus tema, tačiau geometriškai matome, kad tai iš esmės skiriasi nuo aukščiau matytų transformacijų tipų. Pavyzdžiui, matricos rezultatą galima „sulenkti atgal“ į pradinį tinklelį. Matricos rezultatų negalima, nes niekada nežinosime, iš kur atsirado vektorius – ar iš , ar iš ?
Nors šis vaizdas buvo matricai, niekas netrukdo išmoktas pamokas perkelti į aukštesnes dimensijas. Jei paimsime panašius bazės vektorius, pavyzdžiui, , ir pažiūrėsime, kur matrica juos nusiunčia, galime pradėti jausti, kaip matricos daugyba iškreipia visą erdvę, kad ir kokios dimensijos erdvėje dirbtume.
22.1.5 Tiesinė priklausomybė
Dar kartą panagrinėkime matricą
Ji suspaudžia visą plokštumą taip, kad ji telpa vienoje tiesėje . Dabar kyla klausimas: ar yra koks nors būdas tai aptikti žiūrint tiesiog į matricą? Atsakymas – taip, galime. Tegu ir yra du matricos stulpeliai. Prisiminkite, kad viską, ką transformuoja matrica , galime užrašyti kaip matricos stulpelių svertinę sumą: kaip . Tai vadiname tiesiniu dariniu. Tai, kad , reiškia, kad bet kurį šių dviejų stulpelių tiesinį darinį galime užrašyti vien per, tarkime, , nes
Tai reiškia, kad vienas iš stulpelių tam tikra prasme yra perteklinis, nes neapibrėžia unikalios krypties erdvėje. Tai neturėtų pernelyg stebinti, nes jau matėme, kad ši matrica sutraukia visą plokštumą į vieną tiesę. Be to, matome, kad tiesinė priklausomybė tai užfiksuoja. Kad tai būtų simetriškiau tarp dviejų vektorių, užrašysime
Bendru atveju sakysime, kad vektorių rinkinys yra tiesiškai priklausomas, jei egzistuoja koeficientai , ne visi lygūs nuliui, kad
Šiuo atveju galime vieną iš vektorių išreikšti per kokį nors kitų derinį ir taip jį faktiškai paversti pertekliniu. Taigi tiesinė priklausomybė matricos stulpeliuose yra faktas, liudijantis, kad mūsų matrica suspaudžia erdvę į kažkokią žemesnę dimensiją. Jei tiesinės priklausomybės nėra, sakome, kad vektoriai yra tiesiškai nepriklausomi. Jei matricos stulpeliai yra tiesiškai nepriklausomi, suspaudimo nevyksta ir operaciją galima atšaukti.
22.1.6 Rangas
Jei turime bendrą matricą, pagrįsta klausti, kokios dimensijos erdvę matrica atvaizduoja. Atsakymas bus sąvoka, vadinama rangu. Ankstesniame skyrelyje pastebėjome, kad tiesinė priklausomybė liudija apie erdvės suspaudimą į žemesnę dimensiją, todėl galėsime tai naudoti rango sąvokai apibrėžti. Visų pirma matricos rangas yra didžiausias tiesiškai nepriklausomų stulpelių skaičius tarp visų stulpelių poaibių. Pavyzdžiui, matrica
turi , nes du stulpeliai yra tiesiškai priklausomi, bet nė vienas stulpelis pats savaime nėra tiesiškai priklausomas. Sudėtingesniam pavyzdžiui galime panagrinėti
ir parodyti, kad turi rangą du, nes, pavyzdžiui, pirmieji du stulpeliai yra tiesiškai nepriklausomi, tačiau bet kuris iš keturių trijų stulpelių rinkinių yra priklausomas.
Ši procedūra, kaip aprašyta, yra labai neefektyvi. Ji reikalauja peržiūrėti kiekvieną duotos matricos stulpelių poaibį, todėl potencialiai yra eksponentinė pagal stulpelių skaičių. Vėliau pamatysime skaičiavimo požiūriu efektyvesnį būdą matricos rangui apskaičiuoti, bet kol kas pakanka matyti, kad sąvoka yra gerai apibrėžta, ir suprasti jos prasmę.
22.1.7 Apverčiamumas
Aukščiau matėme, kad dauginimo iš matricos su tiesiškai priklausomais stulpeliais negalima atšaukti, t. y. nėra atvirkštinės operacijos, kuri visada galėtų atkurti įvestį. Tačiau dauginimą iš pilno rango matricos (t. y. kokios nors , kuri yra matrica su rangu ) visada turėtume galėti atšaukti. Panagrinėkime matricą
kuri yra matrica su vienetais išilgai įstrižainės ir nuliais kitur. Tai vadiname vienetine matrica. Tai matrica, kuri pritaikyta palieka mūsų duomenis nepakeistus. Kad rastume matricą, kuri atšaukia tai, ką padarė mūsų matrica , norime rasti matricą , kad
Jei į tai žiūrėsime kaip į sistemą, turime nežinomųjų ( elementų) ir lygčių (lygybė, kuri turi galioti tarp kiekvieno sandaugos elemento ir kiekvieno elemento), taigi bendru atveju turėtume tikėtis, kad sprendinys egzistuoja. Iš tiesų kitame skyrelyje pamatysime dydį, vadinamą determinantu, kuris turi savybę, kad kol determinantas nelygus nuliui, galime rasti sprendinį. Tokią matricą vadiname atvirkštine matrica. Pavyzdžiui, jei yra bendroji matrica
tada matome, kad atvirkštinė yra
Galime tai patikrinti pamatydami, kad dauginimas iš atvirkštinės matricos, duotos aukščiau pateikta formule, praktikoje veikia.
M = np.array([[1, 2], [1, 4]])
M_inv = np.array([[2, -1], [-0.5, 0.5]])
M_inv.dot(M)
M = torch.tensor([[1, 2], [1, 4]], dtype=torch.float32)
M_inv = torch.tensor([[2, -1], [-0.5, 0.5]])
M_inv @ M
M = tf.constant([[1, 2], [1, 4]], dtype=tf.float32)
M_inv = tf.constant([[2, -1], [-0.5, 0.5]])
tf.matmul(M_inv, M)
22.1.7.1 Skaitinės problemos
Nors matricos atvirkštinė yra naudinga teorijoje, turime pasakyti, kad dažniausiai praktikoje nenorime problemai spręsti naudoti atvirkštinės matricos. Apskritai yra daug skaitiškai stabilesnių algoritmų tiesinėms lygtims, tokioms kaip
spręsti, nei atvirkštinės apskaičiavimas ir dauginimas, kad gautume
Kaip dalyba iš mažo skaičiaus gali lemti skaitinį nestabilumą, taip gali lemti ir matricos, artimos žemo rango, apvertimas.
Be to, įprasta, kad matrica yra retoji, t. y. joje yra tik nedidelis skaičius nenulinių reikšmių. Jei nagrinėtume pavyzdžius, pamatytume, kad tai nereiškia, jog atvirkštinė yra retoji. Net jei būtų milijono kartų milijono matrica su tik milijonais nenulinių elementų (taigi mums reikėtų saugoti tik tuos milijonus), atvirkštinė paprastai turės beveik kiekvieną elementą nenulinį, todėl reikės saugoti visus elementų – tai yra trilijonas elementų!
Nors neturime laiko pasinerti iki galo į dygius skaitinius klausimus, dažnai sutinkamus dirbant su tiesine algebra, norime suteikti jums šiek tiek intuicijos, kada elgtis atsargiai, o bendra gera taisyklė – praktikoje vengti apvertimo.
22.1.8 Determinantas
Geometrinis tiesinės algebros požiūris suteikia intuityvų būdą interpretuoti esminį dydį, žinomą kaip determinantas. Panagrinėkime ankstesnį tinklelio vaizdą, bet dabar su paryškinta sritimi (22.1.9 pav.).
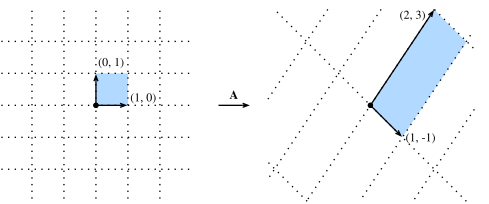
22.1.9 pav. Matrica vėl iškreipia tinklelį. Šį kartą noriu ypač atkreipti dėmesį į tai, kas nutinka paryškintam kvadratui.
Pažiūrėkite į paryškintą kvadratą. Tai kvadratas, kurio kraštines nusako ir , taigi jo plotas lygus vienam. Kai transformuoja šį kvadratą, matome, kad jis tampa lygiagretainiu. Nėra priežasties, kodėl šio lygiagretainio plotas turėtų būti toks pat, nuo kurio pradėjome, ir iš tiesų čia parodytu konkrečiu atveju
tai koordinatinės geometrijos pratimas – apskaičiuoti šio lygiagretainio plotą ir gauti, kad plotas yra .
Apskritai, jei turime matricą
atlikę šiek tiek skaičiavimų matome, kad gauto lygiagretainio plotas yra . Šis plotas vadinamas determinantu.
Greitai tai patikrinkime su pavyzdiniu kodu.
import numpy as np
np.linalg.det(np.array([[1, -1], [2, 3]]))
torch.det(torch.tensor([[1, -1], [2, 3]], dtype=torch.float32))
tf.linalg.det(tf.constant([[1, -1], [2, 3]], dtype=tf.float32))
Arūniai tarp mūsų pastebės, kad ši išraiška gali būti lygi nuliui ar net neigiama. Neigiamam nariui tai yra susitarimo klausimas, paprastai priimtas matematikoje: jei matrica apverčia figūrą, sakome, kad plotas neigiamas. Dabar pažiūrėkime, kad kai determinantas lygus nuliui, sužinome daugiau.
Panagrinėkime
Jei apskaičiuosime šios matricos determinantą, gausime . Atsižvelgiant į aukščiau pateiktą supratimą, tai prasminga. suspaudžia kvadratą iš pradinio paveikslėlio iki atkarpos, kurios plotas lygus nuliui. Ir iš tiesų suspaudimas į žemesnės dimensijos erdvę yra vienintelis būdas gauti nulinį plotą po transformacijos. Taigi matome, kad teisingas toks rezultatas: matrica yra apverčiama tada ir tik tada, kai determinantas nelygus nuliui.
Paskutinė pastaba: įsivaizduokite, kad turime bet kokią plokštumoje nubrėžtą figūrą. Galvodami kaip informatikai, galime išskaidyti tą figūrą į mažų kvadratėlių rinkinį, kad figūros plotas iš esmės būtų tiesiog skaidos kvadratų skaičius. Jei dabar transformuosime tą figūrą matrica, kiekvieną iš šių kvadratų nusiųsime į lygiagretainius, kurių kiekvieno plotą duoda determinantas. Matome, kad bet kuriai figūrai determinantas duoda (ženklinį) skaičių, kuriuo matrica perskalėja bet kurios figūros plotą.
Didesnių matricų determinantų skaičiavimas gali būti sunkus, tačiau intuicija ta pati. Determinantas išlieka daugikliu, kuriuo matricos perskalėja dimensijų tūrius.
22.1.9 Tenzoriai ir įprastos tiesinės algebros operacijos
2.3 skyrelis buvo pristatyta tenzorių sąvoka. Šiame skyrelyje giliau panagrinėsime tenzorių sutraukimus (tenzorių atitikmenį matricų daugybai) ir pamatysime, kaip tai gali suteikti vieningą požiūrį į daugelį matricų ir vektorių operacijų.
Su matricomis ir vektoriais žinojome, kaip juos dauginti duomenims transformuoti. Panašų apibrėžimą turime turėti ir tenzoriams, jei jie mums bus naudingi. Pagalvokime apie matricų daugybą:
arba ekvivalenčiai
Šį dėsningumą galime pakartoti tenzoriams. Tenzoriams nėra vieno atvejo, pagal ką sumuoti, kurį galima būtų pasirinkti universaliai, todėl turime tiksliai nurodyti, pagal kuriuos indeksus norime sumuoti. Pavyzdžiui, galėtume nagrinėti
Tokia transformacija vadinama tenzorių sutraukimu. Ji gali atvaizduoti gerokai lankstesnę transformacijų šeimą nei vien matricų daugyba.
Kaip dažnai naudojamą žymėjimo supaprastinimą, galime pastebėti, kad suma yra tiksliai pagal tuos indeksus, kurie išraiškoje pasitaiko daugiau nei vieną kartą, todėl žmonės dažnai naudoja Einšteino žymėjimą, kai sumavimas netiesiogiai atliekamas pagal visus pasikartojančius indeksus. Tai duoda kompaktišką išraišką:
22.1.9.1 Įprasti tiesinės algebros pavyzdžiai
Pažiūrėkime, kiek tiesinės algebros apibrėžimų, kuriuos matėme anksčiau, galima išreikšti šiuo suglaustu tenzorių žymėjimu:
Šitaip galime pakeisti begalę specializuotų žymėjimų trumpomis tenzorių išraiškomis.
22.1.9.2 Išraiška kode
Su tenzoriais taip pat galima lanksčiai operuoti kode. Kaip matėme 2.3 skyrelis, tenzorius galime sukurti, kaip parodyta toliau.
# Define tensors
B = np.array([[[1, 2, 3], [4, 5, 6]], [[7, 8, 9], [10, 11, 12]]])
A = np.array([[1, 2], [3, 4]])
v = np.array([1, 2])

# Print out the shapes
A.shape, B.shape, v.shape
# Define tensors
B = torch.tensor([[[1, 2, 3], [4, 5, 6]], [[7, 8, 9], [10, 11, 12]]])
A = torch.tensor([[1, 2], [3, 4]])
v = torch.tensor([1, 2])

# Print out the shapes
A.shape, B.shape, v.shape
# Define tensors
B = tf.constant([[[1, 2, 3], [4, 5, 6]], [[7, 8, 9], [10, 11, 12]]])
A = tf.constant([[1, 2], [3, 4]])
v = tf.constant([1, 2])

# Print out the shapes
A.shape, B.shape, v.shape
Einšteino sumavimas yra realizuotas tiesiogiai. Indeksai, pasitaikantys Einšteino sumavime, gali būti perduodami kaip eilutė, po kurios pateikiami tenzoriai, su kuriais atliekami veiksmai. Pavyzdžiui, norėdami realizuoti matricų daugybą, galime panagrinėti aukščiau matytą Einšteino sumavimą () ir pašalinti pačius indeksus, gaudami realizaciją:
# Reimplement matrix multiplication
np.einsum("ij, j -> i", A, v), A.dot(v)
# Reimplement matrix multiplication
torch.einsum("ij, j -> i", A, v), A@v
# Reimplement matrix multiplication
tf.einsum("ij, j -> i", A, v), tf.matmul(A, tf.reshape(v, (2, 1)))
Tai labai lankstus žymėjimas. Pavyzdžiui, jei norime apskaičiuoti tai, kas tradiciškai būtų užrašoma kaip
tai galima realizuoti per Einšteino sumavimą taip:
np.einsum("ijk, il, j -> kl", B, A, v)
torch.einsum("ijk, il, j -> kl", B, A, v)
tf.einsum("ijk, il, j -> kl", B, A, v)
Šis žymėjimas yra skaitomas ir efektyvus žmonėms,
tačiau nepatogus, jei dėl kokios nors priežasties
tenzorių sutraukimą reikia generuoti programiškai.
Dėl šios priežasties einsum siūlo alternatyvų žymėjimą,
kiekvienam tenzoriui nurodydamas sveikuosius indeksus.
Pavyzdžiui, tą patį tenzorių sutraukimą galima užrašyti ir taip:
np.einsum(B, [0, 1, 2], A, [0, 3], v, [1], [2, 3])
# PyTorch does not support this type of notation.
# TensorFlow does not support this type of notation.
Abu žymėjimai leidžia glaustai ir efektyviai atvaizduoti tenzorių sutraukimus kode.
22.1.10 Santrauka
- Vektorius geometriškai galima interpretuoti kaip taškus arba kryptis erdvėje.
- Skaliarinės sandaugos apibrėžia kampo sąvoką savavališkai aukštos dimensijos erdvėms.
- Hiperplokštumos yra tiesių ir plokštumų apibendrinimai aukštoms dimensijoms. Jos gali būti naudojamos sprendimų plokštumoms, dažnai naudojamoms kaip paskutinis klasifikavimo užduoties žingsnis, apibrėžti.
- Matricų daugybą geometriškai galima interpretuoti kaip vienodus pagrindinių koordinačių iškraipymus. Jos yra labai ribotas, bet matematiškai tvarkingas vektorių transformavimo būdas.
- Tiesinė priklausomybė yra būdas pasakyti, kada vektorių rinkinys yra žemesnės dimensijos erdvėje, nei tikėtume (tarkime, turite vektorius, esančius dimensijų erdvėje). Matricos rangas yra didžiausio jos stulpelių poaibio, kuris yra tiesiškai nepriklausomas, dydis.
- Kai apibrėžta matricos atvirkštinė, matricos apvertimas leidžia rasti kitą matricą, kuri atšaukia pirmosios veikimą. Matricos apvertimas yra naudingas teorijoje, bet praktikoje reikalauja atsargumo dėl skaitinio nestabilumo.
- Determinantai leidžia išmatuoti, kiek matrica išplečia ar suspaudžia erdvę. Nenulinis determinantas reiškia apverčiamą (neišsigimusią) matricą, o nulinės reikšmės determinantas reiškia, kad matrica neapverčiama (išsigimusi).
- Tenzorių sutraukimai ir Einšteino sumavimas suteikia tvarkingą ir aiškų žymėjimą daugeliui skaičiavimų, matomų mašininiame mokyme, išreikšti.
22.1.11 Pratimai
- Koks yra kampas tarp
- Teisinga ar klaidinga: ir yra viena kitos atvirkštinės?
- Tarkime, kad plokštumoje nubrėžėme figūrą, kurios plotas . Koks bus plotas po figūros transformavimo matrica
- Kurie iš šių vektorių rinkinių yra tiesiškai nepriklausomi?
- Tarkime, turite matricą, užrašytą kaip su kokiu nors reikšmių ir pasirinkimu. Teisinga ar klaidinga: tokios matricos determinantas visada lygus ?
- Vektoriai ir yra ortogonalūs. Kokia sąlyga matricai , kad ir būtų ortogonalūs?
- Kaip galite užrašyti Einšteino žymėjimu savavališkai matricai ?