
22.3 Vieno kintamojo matematinė analizė
2.4 skyrelis matėme pagrindinius diferencialinio skaičiavimo elementus. Šiame skyriuje giliau panagrinėsime matematinės analizės pagrindus ir tai, kaip ją galime suprasti bei taikyti mašininio mokymo kontekste.
22.3.1 Diferencialinis skaičiavimas
Diferencialinis skaičiavimas iš esmės tiria, kaip funkcijos elgiasi esant mažiems pokyčiams. Kad pamatytume, kodėl tai toks svarbus giliajam mokymuisi, panagrinėkime pavyzdį.
Tarkime, turime gilųjį neuroninį tinklą, kurio parametrai patogumo dėlei sujungti į vieną vektorių . Turėdami mokymo duomenų rinkinį, nagrinėjame savo neuroninio tinklo nuostolius šiame rinkinyje, kuriuos žymėsime .
Ši funkcija yra nepaprastai sudėtinga, nes užkoduoja visų galimų duotos architektūros modelių našumą šiame duomenų rinkinyje, todėl beveik neįmanoma pasakyti, kuri parametrų aibė minimizuos nuostolius. Todėl praktikoje dažnai pradedame parametrus inicializuodami atsitiktinai, o tada iteratyviai darome mažus žingsnius kryptimi, kuria nuostoliai mažėja kuo greičiau.
Taigi klausimas tampa toks, kuris iš pažiūros ne lengvesnis: kaip rasti kryptį, kuria parametrai mažėtų kuo greičiau? Norėdami tai išnagrinėti, pirmiausia panagrinėkime atvejį su vienu parametru: vienai realiajai reikšmei .
Paimkime ir pabandykime suprasti, kas nutinka, kai ją šiek tiek pakeičiame į . Jei norite konkretumo, pagalvokite apie tokį skaičių kaip . Kad geriau įsivaizduotume, kas vyksta, nubraižykime pavyzdinės funkcijos grafiką intervale .
%matplotlib inline
from d2l import mxnet as d2l
from IPython import display
from mxnet import np, npx
npx.set_np()

# Plot a function in a normal range
x_big = np.arange(0.01, 3.01, 0.01)
ys = np.sin(x_big**x_big)
d2l.plot(x_big, ys, 'x', 'f(x)')
%matplotlib inline
from d2l import torch as d2l
from IPython import display
import torch
torch.pi = torch.acos(torch.zeros(1)).item() * 2  # Define pi in torch

# Plot a function in a normal range
x_big = torch.arange(0.01, 3.01, 0.01)
ys = torch.sin(x_big**x_big)
d2l.plot(x_big, ys, 'x', 'f(x)')
%matplotlib inline
from d2l import tensorflow as d2l
from IPython import display
import tensorflow as tf
tf.pi = tf.acos(tf.zeros(1)).numpy() * 2  # Define pi in TensorFlow

# Plot a function in a normal range
x_big = tf.range(0.01, 3.01, 0.01)
ys = tf.sin(x_big**x_big)
d2l.plot(x_big, ys, 'x', 'f(x)')
Tokiu dideliu mastu funkcijos elgsena nėra paprasta. Tačiau jei susiaurinsime intervalą iki kažko mažesnio, pavyzdžiui, , matome, kad grafikas tampa gerokai paprastesnis.
# Plot a the same function in a tiny range
x_med = np.arange(1.75, 2.25, 0.001)
ys = np.sin(x_med**x_med)
d2l.plot(x_med, ys, 'x', 'f(x)')
# Plot a the same function in a tiny range
x_med = torch.arange(1.75, 2.25, 0.001)
ys = torch.sin(x_med**x_med)
d2l.plot(x_med, ys, 'x', 'f(x)')
# Plot a the same function in a tiny range
x_med = tf.range(1.75, 2.25, 0.001)
ys = tf.sin(x_med**x_med)
d2l.plot(x_med, ys, 'x', 'f(x)')
Šią mintį išplėtę iki kraštutinumo, priartinę mažytį atkarpą matome, kad elgsena tampa daug paprastesnė: tai tiesiog tiesė.
# Plot a the same function in a tiny range
x_small = np.arange(2.0, 2.01, 0.0001)
ys = np.sin(x_small**x_small)
d2l.plot(x_small, ys, 'x', 'f(x)')
# Plot a the same function in a tiny range
x_small = torch.arange(2.0, 2.01, 0.0001)
ys = torch.sin(x_small**x_small)
d2l.plot(x_small, ys, 'x', 'f(x)')
# Plot a the same function in a tiny range
x_small = tf.range(2.0, 2.01, 0.0001)
ys = tf.sin(x_small**x_small)
d2l.plot(x_small, ys, 'x', 'f(x)')
Tai yra pagrindinis vieno kintamojo matematinės analizės pastebėjimas: pažįstamų funkcijų elgseną pakankamai mažame intervale galima modeliuoti tiese. Tai reiškia, kad daugumai funkcijų pagrįstai galima tikėtis, jog šiek tiek pakeitus funkcijos reikšmę, išvestis taip pat šiek tiek pasikeis. Vienintelis klausimas, į kurį turime atsakyti: „Kiek didelis išvesties pokytis, palyginti su įvesties pokyčiu? Ar perpus mažesnis? Dvigubai didesnis?“
Taigi galime nagrinėti funkcijos išvesties pokyčio ir nedidelio funkcijos įvesties pokyčio santykį. Formaliai tai galime užrašyti kaip
Su tuo jau galima pradėti žaisti kode. Pavyzdžiui, tarkime, žinome, kad , tada galime pamatyti, kokia yra ši reikšmė taške , taip.
# Define our function
def L(x):
    return x**2 + 1701*(x-4)**3

# Print the difference divided by epsilon for several epsilon
for epsilon in [0.1, 0.001, 0.0001, 0.00001]:
    print(f'epsilon = {epsilon:.5f} -> {(L(4+epsilon) - L(4)) / epsilon:.5f}')
Jei esame pastabūs, pamatysime, kad šio skaičiaus išvestis įtartinai artima . Iš tiesų, mažindami , matysime, kad reikšmė vis labiau artėja prie . Taigi galime teisingai daryti išvadą, kad ieškoma reikšmė (laipsnis, kuriuo įvesties pokytis keičia išvestį) taške turėtų būti . Matematikas šį faktą užkoduoja taip
Trumpa istorinė atkarpa: pirmaisiais neuroninių tinklų tyrimų dešimtmečiais mokslininkai naudojo šį algoritmą (baigtinių skirtumų metodą), kad įvertintų, kaip nuostolių funkcija keičiasi esant mažam trikdžiui: tiesiog pakeisti parametrus ir pažiūrėti, kaip pasikeitė nuostoliai. Tai skaičiavimo požiūriu neefektyvu: norint pamatyti, kaip vieno kintamojo pokytis paveikė nuostolius, reikia dviejų nuostolių funkcijos įvertinimų. Jei taip bandytume daryti net su menku keliu tūkstančių parametrų skaičiumi, reikėtų kelių tūkstančių tinklo įvertinimų visame duomenų rinkinyje! Ši problema buvo išspręsta tik 1986 m., kai (Rumelhart ir kt., 1988) pristatytas atgalinio sklidimo algoritmas suteikė būdą apskaičiuoti, kaip bet koks kartu pakeistų parametrų pokytis pakeistų nuostolius per tiek pat skaičiavimo laiko, kiek reikia vienai tinklo prognozei visame duomenų rinkinyje.
Grįžkime prie mūsų pavyzdžio: ši reikšmė skiriasi esant skirtingoms reikšmėms, todėl prasminga ją apibrėžti kaip funkciją. Formaliau, šis nuo reikšmės priklausantis kitimo greitis vadinamas išvestine ir žymimas
Skirtinguose tekstuose išvestinei žymėti naudojami skirtingi žymenys. Pavyzdžiui, visi toliau pateikti žymenys reiškia tą patį:
Dauguma autorių pasirenka vieną žymenį ir jo laikosi, tačiau ir tai negarantuota. Geriausia mokėti visus šiuos žymenis. Šiame tekste naudosime žymenį , nebent norėsime imti sudėtingos išraiškos išvestinę – tuomet naudosime ir rašysime tokias išraiškas kaip
Dažnai intuityviai naudinga iš naujo išskleisti išvestinės apibrėžimą (22.3.1), kad pamatytume, kaip funkcija keičiasi, kai šiek tiek pakeičiame :
Paskutinę lygtį verta paminėti atskirai. Ji sako, kad jei paimsime bet kurią funkciją ir šiek tiek pakeisime įvestį, išvestis pasikeis tuo mažu dydžiu, padaugintu iš išvestinės.
Šitaip išvestinę galime suprasti kaip mastelio koeficientą, parodantį, kokį išvesties pokytį gauname dėl įvesties pokyčio.
22.3.2 Matematinės analizės taisyklės
Dabar pereiname prie užduoties suprasti, kaip apskaičiuoti aiškios funkcijos išvestinę. Pilnas formalus matematinės analizės dėstymas viską išvestų iš pirmųjų principų. Šiam pagundai čia nepasiduosime, o veikiau suteiksime supratimą apie dažniausiai sutinkamas taisykles.
22.3.2.1 Dažniausios išvestinės
Kaip matėme 2.4 skyrelis, skaičiuojant išvestines dažnai galima naudoti taisyklių seką, kad skaičiavimą sumažintume iki kelių pagrindinių funkcijų. Dėl patogumo pakartojame jas čia.
- Konstantų išvestinė. .
- Tiesinių funkcijų išvestinė. .
- Laipsnio taisyklė. .
- Eksponentinių funkcijų išvestinė. .
- Logaritmo išvestinė. .
22.3.2.2 Išvestinių taisyklės
Jei kiekvieną išvestinę reikėtų skaičiuoti atskirai ir saugoti lentelėje, diferencialinis skaičiavimas būtų beveik neįmanomas. Matematikos dovana yra tai, kad aukščiau pateiktas išvestines galime apibendrinti ir skaičiuoti sudėtingesnes, pavyzdžiui, rasti funkcijos išvestinę. Kaip minėta 2.4 skyrelis, raktas į tai – užkoduoti, kas nutinka funkcijas įvairiai derinant, svarbiausia: sumas, sandaugas ir kompozicijas.
- Sumos taisyklė. .
- Sandaugos taisyklė. .
- Grandinės taisyklė. .
Pažiūrėkime, kaip galime naudoti (22.3.2), kad suprastume šias taisykles. Sumos taisyklei panagrinėkime tokią samprotavimo grandinę:
Palyginę šį rezultatą su faktu, kad , matome, kad , kaip ir norėta. Intuicija čia tokia: keičiant įvestį , ir kartu prisideda prie išvesties pokyčio atitinkamai ir .
Sandauga subtilesnė ir reikalaus naujo pastebėjimo apie tai, kaip dirbti su šiomis išraiškomis. Pradėsime kaip anksčiau naudodami (22.3.2):
Tai primena aukščiau atliktą skaičiavimą, ir iš tiesų matome savo atsakymą () šalia , tačiau yra problema dėl to nario, kurio dydis . Jį vadinsime aukštesnės eilės nariu, nes laipsnis yra aukštesnis už laipsnį. Vėlesniame skyriuje pamatysime, kad kartais norėsime juos sekti, tačiau kol kas pastebėkime, kad jei , tai , kuris yra gerokai mažesnis. Kai , aukštesnės eilės narius galime saugiai ignoruoti. Kaip bendrą šio priedo susitarimą, naudosime „“, kad pažymėtume, jog du nariai yra lygūs iki aukštesnės eilės narių. Tačiau jei norime būti formalesni, galime išnagrinėti skirtumų santykį
ir pamatyti, kad kai , dešinysis narys taip pat artėja prie nulio.
Galiausiai su grandinės taisykle galime vėl žengti kaip anksčiau naudodami (22.3.2) ir pamatyti, kad
kur antroje eilutėje funkciją vertiname taip, tarsi jos įvestis () būtų pastumta mažyčiu dydžiu .
Šios taisyklės suteikia lanksčią priemonių rinkinį, leidžiantį apskaičiuoti iš esmės bet kokią norimą išraišką. Pavyzdžiui,
Kur kiekvienoje eilutėje naudotos šios taisyklės:
- Grandinės taisyklė ir logaritmo išvestinė.
- Sumos taisyklė.
- Konstantų išvestinė, grandinės taisyklė ir laipsnio taisyklė.
- Sumos taisyklė, tiesinių funkcijų išvestinė, konstantų išvestinė.
Atlikus šį pavyzdį, turėtų būti aišku du dalykai:
- Bet kurios funkcijos, kurią galime užrašyti naudodami sumas, sandaugas, konstantas, laipsnius, eksponentes ir logaritmus, išvestinę galima apskaičiuoti mechaniškai laikantis šių taisyklių.
- Žmogui laikytis šių taisyklių gali būti nuobodu ir klaidų kupina!
Laimei, šie du faktai kartu užsimena apie tolesnį kelią: tai puikus kandidatas mechanizavimui! Iš tiesų atgalinis sklidimas, prie kurio dar grįšime šiame skyriuje, yra būtent tai.
22.3.2.3 Tiesinė aproksimacija
Dirbant su išvestinėmis dažnai naudinga geometriškai interpretuoti aukščiau naudotą aproksimaciją. Visų pirma atkreipkite dėmesį, kad lygtis
aproksimuoja reikšmę tiese, einančia per tašką ir turinčia nuolydį . Taip sakome, kad išvestinė suteikia funkcijos tiesinę aproksimaciją, kaip parodyta toliau:
# Compute sin
xs = np.arange(-np.pi, np.pi, 0.01)
plots = [np.sin(xs)]

# Compute some linear approximations. Use d(sin(x)) / dx = cos(x)
for x0 in [-1.5, 0, 2]:
    plots.append(np.sin(x0) + (xs - x0) * np.cos(x0))

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
# Compute sin
xs = torch.arange(-torch.pi, torch.pi, 0.01)
plots = [torch.sin(xs)]

# Compute some linear approximations. Use d(sin(x))/dx = cos(x)
for x0 in [-1.5, 0.0, 2.0]:
    plots.append(torch.sin(torch.tensor(x0)) + (xs - x0) *
                 torch.cos(torch.tensor(x0)))

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
# Compute sin
xs = tf.range(-tf.pi, tf.pi, 0.01)
plots = [tf.sin(xs)]

# Compute some linear approximations. Use d(sin(x))/dx = cos(x)
for x0 in [-1.5, 0.0, 2.0]:
    plots.append(tf.sin(tf.constant(x0)) + (xs - x0) *
                 tf.cos(tf.constant(x0)))

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
22.3.2.4 Aukštesnės eilės išvestinės
Dabar padarykime tai, kas iš pažiūros gali atrodyti keista. Paimkime funkciją ir apskaičiuokime išvestinę . Tai mums duoda kitimo greitį bet kuriame taške.
Tačiau išvestinę galima nagrinėti kaip pačią funkciją, todėl niekas netrukdo apskaičiuoti išvestinės ir gauti . Tai vadinsime antrąja išvestine. Ši funkcija yra kitimo greičio kitimo greitis, arba, kitaip tariant, kaip kinta kitimo greitis. Išvestinę galime taikyti bet kiek kartų ir gauti vadinamąją -ąją išvestinę. Kad žymėjimas būtų tvarkingas, -ąją išvestinę žymėsime
Pabandykime suprasti, kodėl ši sąvoka naudinga. Toliau pavaizduojame , ir .
Pirmiausia panagrinėkime atvejį, kai antroji išvestinė yra teigiama konstanta. Tai reiškia, kad pirmosios išvestinės nuolydis yra teigiamas. Dėl to pirmoji išvestinė gali pradėti neigiama, tam tikrame taške tapti lygi nuliui, o galiausiai tapti teigiama. Tai mums pasako mūsų pradinės funkcijos nuolydį, todėl pati funkcija mažėja, išsilygina, tada didėja. Kitaip tariant, funkcija išgaubta į viršų ir turi vieną minimumą, kaip parodyta 22.3.1 pav..
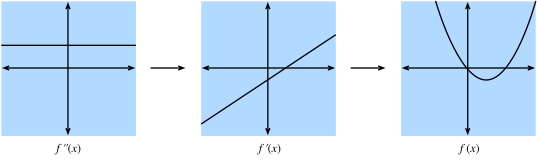
22.3.1 pav. Jei darome prielaidą, kad antroji išvestinė yra teigiama konstanta, tai pirmoji išvestinė didėja, o tai reiškia, kad pati funkcija turi minimumą.
Antra, jei antroji išvestinė yra neigiama konstanta, tai reiškia, kad pirmoji išvestinė mažėja. Tai reiškia, kad pirmoji išvestinė gali pradėti teigiama, tam tikrame taške tapti lygi nuliui, o tada tapti neigiama. Vadinasi, pati funkcija didėja, išsilygina, tada mažėja. Kitaip tariant, funkcija išgaubta žemyn ir turi vieną maksimumą, kaip parodyta 22.3.2 pav..
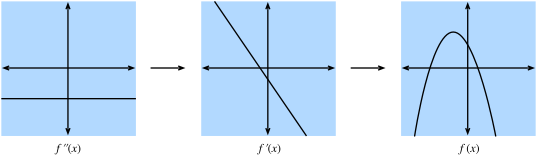
22.3.2 pav. Jei darome prielaidą, kad antroji išvestinė yra neigiama konstanta, tai pirmoji išvestinė mažėja, o tai reiškia, kad pati funkcija turi maksimumą.
Trečia, jei antroji išvestinė visada lygi nuliui, tai pirmoji išvestinė niekada nesikeis – ji yra konstanta! Tai reiškia, kad didėja (arba mažėja) pastoviu greičiu, o pati yra tiesė, kaip parodyta 22.3.3 pav..

22.3.3 pav. Jei darome prielaidą, kad antroji išvestinė lygi nuliui, tai pirmoji išvestinė yra konstanta, o tai reiškia, kad pati funkcija yra tiesė.
Apibendrinant, antrąją išvestinę galima interpretuoti kaip aprašančią, kaip funkcija išlinksta. Teigiama antroji išvestinė lemia išlinkimą į viršų, neigiama antroji išvestinė reiškia, kad išlinksta žemyn, o nulinė antroji išvestinė reiškia, kad visai nelinksta.
Žengkime dar vieną žingsnį. Panagrinėkime funkciją . Tada galime apskaičiuoti, kad
Jei turime omenyje kokią nors pradinę funkciją , galime apskaičiuoti pirmąsias dvi išvestines ir rasti bei reikšmes, kurios joms leidžia atitikti šį skaičiavimą. Panašiai kaip ankstesniame skyriuje matėme, kad pirmoji išvestinė duoda geriausią aproksimaciją tiese, ši konstrukcija suteikia geriausią aproksimaciją kvadratine funkcija. Pavaizduokime tai funkcijai .
# Compute sin
xs = np.arange(-np.pi, np.pi, 0.01)
plots = [np.sin(xs)]

# Compute some quadratic approximations. Use d(sin(x)) / dx = cos(x)
for x0 in [-1.5, 0, 2]:
    plots.append(np.sin(x0) + (xs - x0) * np.cos(x0) -
                              (xs - x0)**2 * np.sin(x0) / 2)

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
# Compute sin
xs = torch.arange(-torch.pi, torch.pi, 0.01)
plots = [torch.sin(xs)]

# Compute some quadratic approximations. Use d(sin(x)) / dx = cos(x)
for x0 in [-1.5, 0.0, 2.0]:
    plots.append(torch.sin(torch.tensor(x0)) + (xs - x0) *
                 torch.cos(torch.tensor(x0)) - (xs - x0)**2 *
                 torch.sin(torch.tensor(x0)) / 2)

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
# Compute sin
xs = tf.range(-tf.pi, tf.pi, 0.01)
plots = [tf.sin(xs)]

# Compute some quadratic approximations. Use d(sin(x)) / dx = cos(x)
for x0 in [-1.5, 0.0, 2.0]:
    plots.append(tf.sin(tf.constant(x0)) + (xs - x0) *
                 tf.cos(tf.constant(x0)) - (xs - x0)**2 *
                 tf.sin(tf.constant(x0)) / 2)

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
Šią mintį išplėsime iki Teiloro eilutės sampratos kitame skyrelyje.
22.3.2.5 Teiloro eilutė
Teiloro eilutė suteikia metodą aproksimuoti funkciją , jei turime pirmųjų išvestinių reikšmes taške , t. y. . Idėja – rasti -ojo laipsnio daugianarį, atitinkantį visas duotas išvestines taške .
Atvejį matėme ankstesniame skyrelyje, ir šiek tiek algebros parodo, kad tai yra
Kaip matome aukščiau, vardiklis yra tam, kad panaikintų , kurį gauname dukart diferencijuodami , o kiti nariai visi lygūs nuliui. Ta pati logika galioja pirmajai išvestinei ir pačiai reikšmei.
Jei logiką tęsime iki , padarysime išvadą, kad
kur atsiranda iš konstantos, kurią gauname priekyje, jei triskart diferencijuojame .
Be to, -ojo laipsnio daugianarį galime gauti taip:
kur žymuo
Iš tiesų galima laikyti geriausia -ojo laipsnio daugianario aproksimacija mūsų funkcijai .
Nors nesigilinsime iki galo į aukščiau pateiktų aproksimacijų paklaidą, verta paminėti begalinę ribą. Šiuo atveju gerai besielgiančioms funkcijoms (žinomoms kaip realiosios analizinės funkcijos), tokioms kaip ar , galime užrašyti begalinį narių skaičių ir aproksimuoti tą pačią funkciją
Pavyzdžiui, paimkime . Kadangi yra savo paties išvestinė, žinome, kad . Todėl galima atkurti paėmus Teiloro eilutę taške , t. y.
Pažiūrėkime, kaip tai veikia kode, ir stebėkime, kaip didinant Teiloro aproksimacijos laipsnį artėjame prie norimos funkcijos .
# Compute the exponential function
xs = np.arange(0, 3, 0.01)
ys = np.exp(xs)

# Compute a few Taylor series approximations
P1 = 1 + xs
P2 = 1 + xs + xs**2 / 2
P5 = 1 + xs + xs**2 / 2 + xs**3 / 6 + xs**4 / 24 + xs**5 / 120

d2l.plot(xs, [ys, P1, P2, P5], 'x', 'f(x)', legend=[
    "Exponential", "Degree 1 Taylor Series", "Degree 2 Taylor Series",
    "Degree 5 Taylor Series"])
# Compute the exponential function
xs = torch.arange(0, 3, 0.01)
ys = torch.exp(xs)

# Compute a few Taylor series approximations
P1 = 1 + xs
P2 = 1 + xs + xs**2 / 2
P5 = 1 + xs + xs**2 / 2 + xs**3 / 6 + xs**4 / 24 + xs**5 / 120

d2l.plot(xs, [ys, P1, P2, P5], 'x', 'f(x)', legend=[
    "Exponential", "Degree 1 Taylor Series", "Degree 2 Taylor Series",
    "Degree 5 Taylor Series"])
# Compute the exponential function
xs = tf.range(0, 3, 0.01)
ys = tf.exp(xs)

# Compute a few Taylor series approximations
P1 = 1 + xs
P2 = 1 + xs + xs**2 / 2
P5 = 1 + xs + xs**2 / 2 + xs**3 / 6 + xs**4 / 24 + xs**5 / 120

d2l.plot(xs, [ys, P1, P2, P5], 'x', 'f(x)', legend=[
    "Exponential", "Degree 1 Taylor Series", "Degree 2 Taylor Series",
    "Degree 5 Taylor Series"])
Teiloro eilutės turi du pagrindinius taikymus:
-
Teoriniai taikymai: dažnai, kai bandome suprasti per daug sudėtingą funkciją, Teiloro eilutės leidžia ją paversti daugianariu, su kuriuo galime dirbti tiesiogiai.
-
Skaitiniai taikymai: kai kurias funkcijas, pavyzdžiui, ar , mašinoms sunku apskaičiuoti. Jos gali saugoti reikšmių lenteles fiksuotu tikslumu (ir tai dažnai daroma), tačiau tai vis tiek palieka neatsakytų klausimų, pavyzdžiui: „Koks yra 1000-asis skaitmuo?“ Teiloro eilutės dažnai padeda atsakyti į tokius klausimus.
22.3.3 Santrauka
- Išvestinės gali būti naudojamos išreikšti, kaip funkcijos keičiasi, kai įvestį šiek tiek pakeičiame.
- Elementariosios išvestinės gali būti derinamos naudojant išvestinių taisykles, kad gautume savavališkai sudėtingas išvestines.
- Išvestines galima iteruoti ir gauti antrąją ar aukštesnės eilės išvestines. Kiekvienas eilės padidinimas suteikia smulkesnės informacijos apie funkcijos elgesį.
- Naudodami informaciją iš vieno duomenų pavyzdžio išvestinių, gerai besielgiančias funkcijas galime aproksimuoti daugianariais, gautais iš Teiloro eilutės.
22.3.4 Pratimai
- Kokia yra išvestinė?
- Kokia yra išvestinė?
- Teisinga ar klaidinga: jei , tai taške turi maksimumą arba minimumą?
- Kur yra minimumas, kai (darome prielaidą, kad taške įgyja ribinę reikšmę )?